

十一月十七日权重上传、十九日 arXiv 技术报告挂出(编号 2611.26409)、二十日补上量化文件——腾讯微信视觉团队开源的 WeMM-Video 只用了三天就把家底放齐。这是一个中英双语的全模态视频理解与推理系列,文本、图片、音频、带声音频轨的视频都能输入,输出文字,规格覆盖 2B、4B、9B 和 35B-A3B MoE 四档。本地部署的硬件门槛其实已经被这套结构自己分好了档:最小的 2B 档四位量化三个分片加起来不到 5 GiB,官方 CPU 运行时已完成四类输入的生成检查;旗舰 35B-A3B 的 BF16 权重 67.39 GiB,官方部署示例直接按两张卡的张量并行来配。还有一道比显存更容易被忽略的门槛在软件环境:不打官方补丁的 vLLM、SGLang 认不出这个架构,官方 GGUF 也不是 Ollama、LM Studio 能直接打开的。知乎arXivHugging Face
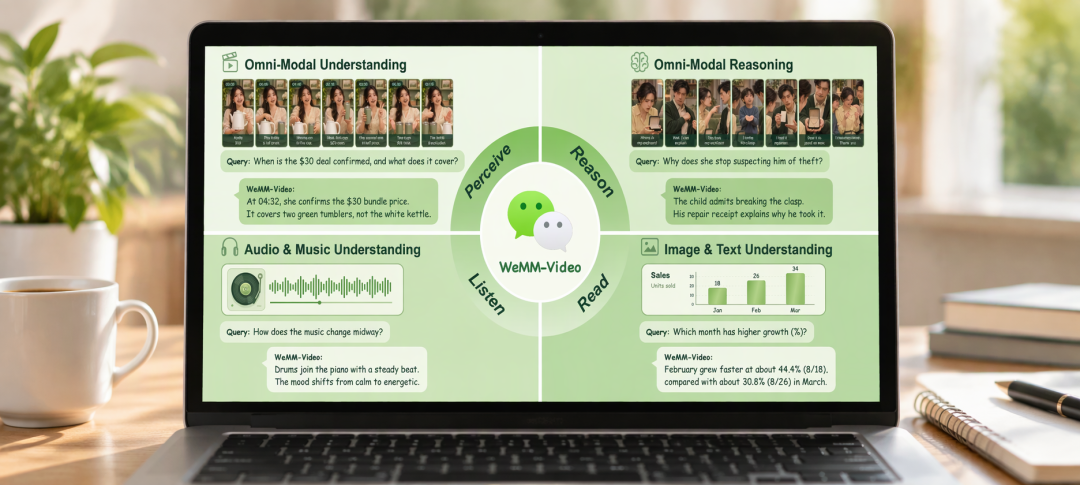
官方对这套模型的定位不低:在 120 多项评测里,35B-A3B 在全模态视频理解上创下开源模型新纪录,明显超过 Qwen3.5-Omni-Flash、Seed2.0-Mini-0428 等闭源模型并与 Gemini-3.0-Flash 的差距收窄,9B 也超过了参数量更大的 Qwen3-Omni-30B-A3B-Instruct。不过这些数字全部出自腾讯自己的评测流程,目前没有一个人复现过。arXivGitHub知乎
热度还因为它不是演示玩具:微信官宣 WeMM-Video 能看、能听、会推理,已接入微信生态实际使用。哔哩哔哩
先把大小账算清:每一档到底占多少地方
名字里的 2B、4B、9B 只是语言主干,每个模型还额外挂着两个外挂编码器,视觉一个、听觉一个。落到硬盘上,官方模型卡给出的 BF16 权重大小分别是 6.12、10.45、19.54、67.39 GiB。知乎Hugging FaceHugging FaceHugging FaceHugging Face
档位 | BF16 权重 | GGUF Q4_K_M(语言+视觉+听觉三分片合计) |
|---|---|---|
2B | 6.12 GiB | 约 4.95 GiB |
4B | 10.45 GiB | 约 7.53 GiB |
9B | 19.54 GiB | 约 13.28 GiB |
35B-A3B | 67.39 GiB | 约 25.44 GiB |
GGUF 版本被裁成语言、视觉、听觉三个分片,必须按同一个提交版本一起下载,混着版本起不来。25.4 GiB 的四位包放到 24G 显存的卡上,装完权重几乎没地方开上下文,因为光语言一个分片就有 22.61 GiB。官方 35B-A3B 的服务命令直接写着用两张卡做张量并行。模型卡对显存的官方口径是"按权重文件、媒体输入和生成缓存一起留",实际要多于权重本身;当天流传的部署分析给的参考是留出比权重多出至少三成的余量,或者干脆走 CPU 加内存的那条慢路。反过来,2B 档是这条链上最便宜的入口,一台没有独立显卡的普通电脑就够得着,因为官方 CPU 运行时已用它完成文本、图像、音频、带声视频四类输入的生成检查。Hugging FaceHugging FaceHugging Face知乎Hugging Face
显存之外的暗门槛:不打补丁,标准安装器统统装不上
环境要求是写死的。官方补丁的安装脚本面向 Linux x86_64、glibc 2.35 以上、Python 3.12 和兼容 CUDA 12.9 驱动的 NVIDIA 显卡。框架版本同样被钉死:vLLM 只认 0.18.0 和 0.31.0,SGLang 只认 0.5.16 和 0.5.19,每个版本还得配特定的 PyTorch、Transformers 和 CUDA 12.9。GitHub知乎
对编译环境还有更直接的要求:SGLang 那条线第一次跑要现场编译 CUDA 核,机器上得备齐 CUDA 12.9 Toolkit 和 C++ 编译器这条工具链。量化格式也各自锁硬件:FP8 路线要求支持 FP8 的 GPU,NVFP4 的官方参考配置直接写了 SM120;连原生运行时的编译示例,点名的也是 L20、H20、RTX PRO 5000 这一档企业卡的架构号。GitHubGitHub
最像捷径的 GGUF 恰恰不是捷径:仓库写明它是给 WeMM native runtime 准备的格式,llama.cpp、Ollama、LM Studio 现在都读不了,因为文件是三块分开的官方流水线产物。想走这条纯 CPU 或半 GPU 卸载的慢路,得自己编译官方锁定的运行时:Linux 下要 CMake 3.20 以上、C++17 编译器和 Python 3.10 以上。知乎GitHub
官方只验证了"能加载",速度数据一个都还没有
对部署预期的校准,看官方验证表最准:打了补丁的 vLLM 在 H20 上成功加载 9B 检查点,并完成文本、图像、音频、带声视频各一次生成检查。速度、显存占用、并发一个数都还没有,部署文档同时注明,从 Hub 下载检查点后的 GPU 生成验证还没完成。另一个现实约束是生态时差:这篇部署分析发稿时官方下载量还是零、没有任何第三方跑过,你现在遇到的每个坑大概率还没人替你踩过。Hugging FaceGitHub知乎
按任务选档比按名字选档靠谱:做字幕、画面描述这类活 2B 够用,还能放进笔记本;要看懂一段视频里某句话和某个画面是否矛盾这种跨模态推理,才值得上 4B 或 9B。该动手的是手里有一批短剧或直播切片要批量摘要、且团队里有人搞得定 vLLM 补丁的人;纯个人尝鲜,可以等社区把转换脚本和现成安装方案补齐再下载——权重已经在 Apache 2.0 下随便商用,不会跑掉。知乎


当前文章无评论,是时候发表评论了