

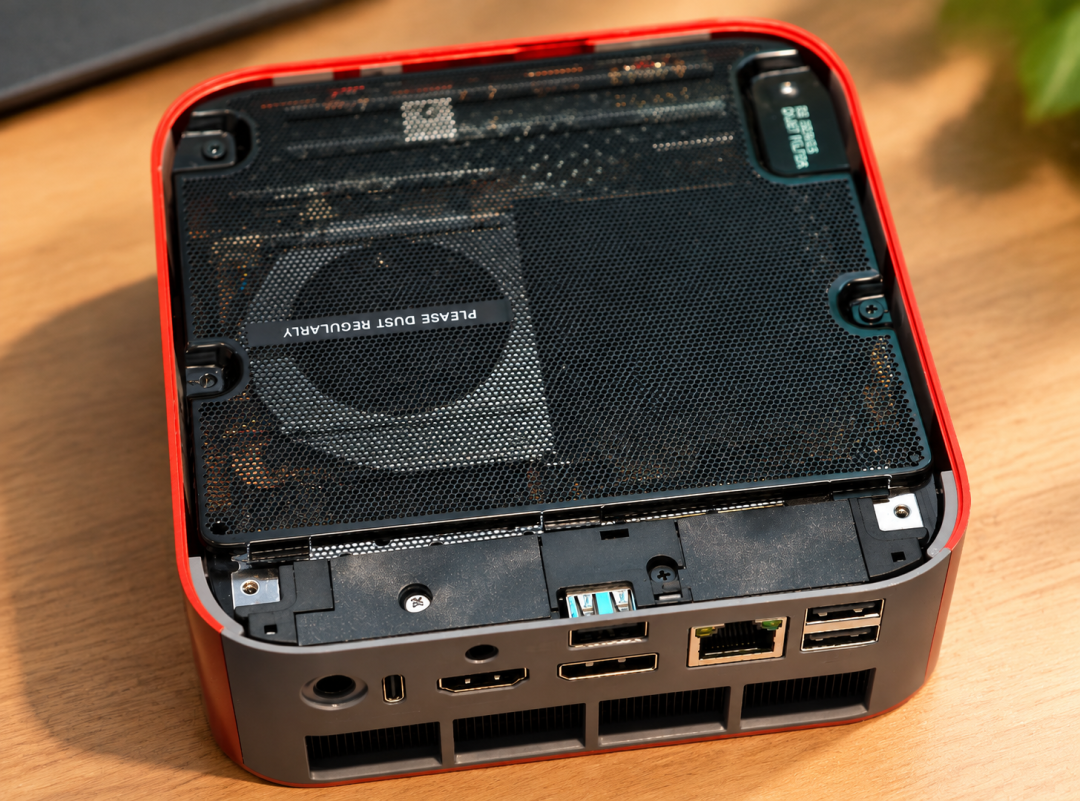
双十一刚过,B站上“铭凡M1 Pro-285H”的视频一天能刷出好几条,文案整齐划一:AI总算力达99TOPS,在迷你主机中属于顶级性能水准。国补还挂着,不少人正准备下单。哔哩哔哩知乎
问题是,这个 99 TOPS 是加出来的——CPU、GPU、NPU 三块算力相加叫“平台总算力”,拿整机加总去比单颗 NPU,就像拿一家人的总收入去比一个人的工资。同一颗酷睿 Ultra 9 285H 拆开看,NPU 单颗标称只有 13.1 TOPS(INT8),铭凡自己的上手稿里也写着“内置NPU,能够提供高达13 TOPS的算力”。前半句是事实,后半句“为本地运行大模型提供了很好的支撑”是愿望。知乎知乎
13 TOPS,连门都进不去
微软给 Copilot+ PC 定的硬门槛是 NPU 40 TOPS 以上、内存 16GB、存储 256GB。13 TOPS 差着三倍,Recall、Click to Do、改进版 Windows 搜索这些“专属 AI 功能”,这台机器一律拿不到门票——不管详情页写多少个 TOPS。知乎
更尴尬的是,这张门票本身正在作废:微软 2026 年发布的新 Surface PC,已经不再称呼 Copilot+ PC。你在迷你主机详情页看到的算力口径,锚定的是一套厂商自己都在淡化的认证。知乎
AMD 那边数字好看些:锐龙 AI 9 HX370 是 50 TOPS,HX470 提到 55 TOPS,铭凡新品通稿的原话是“NPU算力从50TOPS提升至55TOPS,AI处理效率提升10%”。过线了,然后呢?知乎
有人真把 NPU 拆开测了
知乎用户“知无不言”在一台 285H 机器上做了三轮互不复用的实测(OpenVINO 2026.4.1,2026 年 10 月 27 日)。先说清楚:那是台 ThinkBook 16 G7+ 笔记本,跑 Gentoo Linux,不是迷你主机——但芯片是同一颗,量级可以参考。
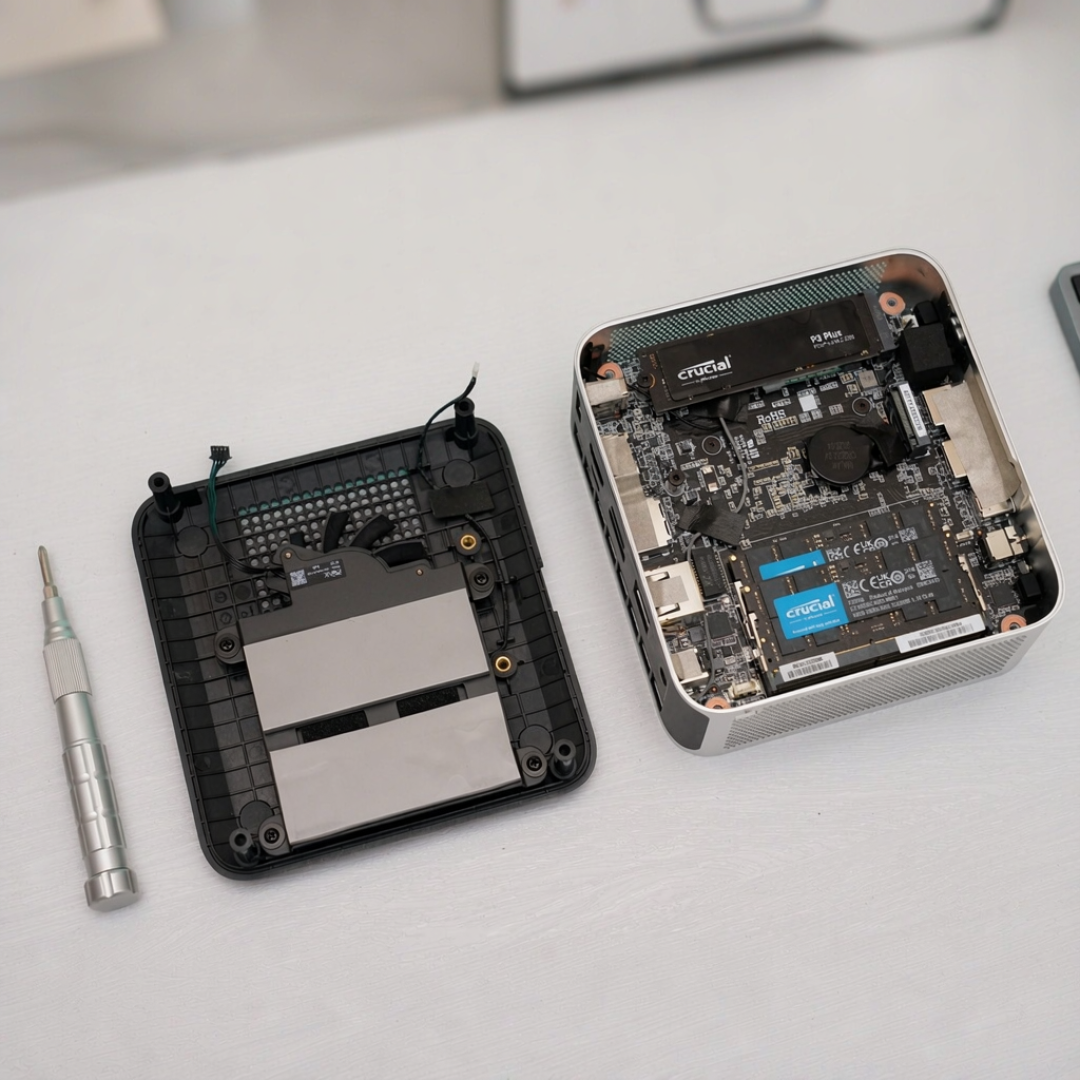
最扎心的一项:跑大模型时,这颗 NPU 的生成速度恒定在 0.64 tok/s,提示从 41 个 token 加到 135 个,首 token 时间几乎不变。瓶颈是逐 token 的固定开销,不是预填充。知乎
同一台机器上,CPU 快约 140 倍。MODNet、YOLOv8n-pose、CLIP 这些模型,NPU 反而更慢——不是不能用,是它吃得下的形状很窄。知乎
更要命的是生态:这台机器上几乎只有 OpenVINO 能调用 NPU,系统里的 ffmpeg、OpenCV、VLC、llama.cpp、ComfyUI 都不会自动走它,Ollama 干脆没有 Intel NPU 后端。11 月 19 日知乎那个浏览量 1.6 万的热问题“AI PC 的 NPU 为什么经常处于闲置状态”下面,一位 Linux 用户的回答更直接:不自己主动找,愣是看不到任何 XDNA NPU 相关的开源应用方案。软件不写,硬件就只能闲着。知乎知乎
NPU 不是不能用,是没人给它写软件。
它真正值钱的地方,是省电
还是那篇实测。作者用 NPU 搭了条 720p30 的虚拟摄像头背景虚化管线:按 30 fps 跑一小时,NPU 路径比空闲多约 5.8 Wh,CPU 路径多约 62 Wh。差整整十倍。知乎
所以 NPU 的主场是“固定输入尺寸 + batch 1 + 连续流 + 能效优先”的常驻小任务:背景虚化、实时字幕、语音唤醒、OCR。不是跑大模型。
但迷你主机买 NPU,还得多算一笔:它和 CPU 共享封装功耗与散热预算,CPU 一忙,NPU 就从 1600MHz 掉到 1266 甚至 1000MHz,延迟直接增加 18%–55%。而迷你主机的功耗墙本来就比笔记本抠——同一批 HX470 机型,厂商功耗墙从 45W 到 80W 都能设。详情页那句“NPU 释放 CPU”,前提是你的 CPU 得闲。知乎知乎
厂商自己已经开始绕开它
真把 NPU 当回事的方案,是把它从 SoC 里搬出来。零刻 SEi13 AI 用的 CPU 是 2023 年的 i7-13620H,NPU 不在芯片里,而是一块 M.2 接口的独立算力卡,自带 24GB 专用推理内存、标称 160 TOPS,本地跑 9B 稠密模型能到 23 tok/s 往上。它预装 Ubuntu 和 llama.cpp,官方模型库直接给到 100 个。知乎哔哩哔哩
同一位用户的实测里,NPU 满载跑推理的同时,CPU 平均一直在 2% 徘徊。这就是他说的“算、算分离”:SoC 里那颗要抢系统内存、抢功耗预算、还得等软件适配;独立卡有自己的内存和供电,llama.cpp 直接就能喂。小米玄戒 AI Cube 走的是同一条路。知乎
下单前,把 TOPS 换成三个问题
一、这颗 NPU 单独多少 TOPS? 不到 40,Windows 那套 AI 功能基本与你无关,“总算力”当装饰看就行。
二、你要跑的软件走不走 NPU? Ollama、LM Studio、ComfyUI 目前主要吃 CPU 和核显。真想本地跑模型,钱花在内存容量和带宽上,比花在 TOPS 上实在得多。
三、你要的是省电还是提速? 长时间开会的背景虚化、实时字幕,NPU 有真价值;指望它加速大模型,现在还不行。
说到底,TOPS 更接近汽车的理论极速,而不是你每天通勤的平均车速。买迷你主机真正要回答的是另一件事:我常用的那件事,会不会变快。知乎
当前文章无评论,是时候发表评论了