

这个月国内外科技媒体都在忙同一件事:DeepSeek Harness(DSH)上线不到 3 个月,日活 154 万,日消耗 token 92 万亿,第三方插件 3.5 万个。国内这边,中兴也把撑着 2000 人研发团队的 Co-Sight Harness 开源了。一夜之间,"Harness"成了 Prompt、Context 之后的新顶流。知乎知乎知乎
它是什么?一句话版本:模型权重之外的一切都是 harness——登记了哪些工具、参数怎么填、结果怎么送回模型、失败了还让不让重试。有论文打了个比方:权重是脑子,harness 是身体。脑子没变,身体好不好用,产出能差几倍。知乎
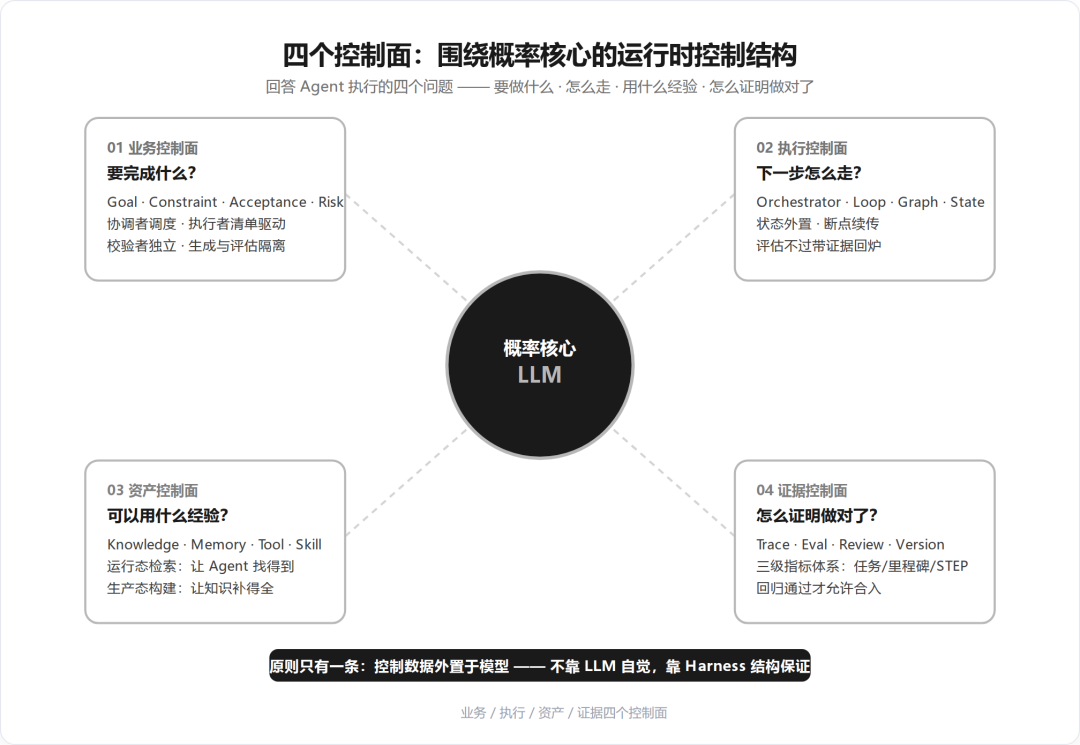
差距是可以算出来的:
成本不看单价,看轮数。一个开发者给的账:成本约等于 token 数乘以循环轮数再乘以单价。工具只回"执行失败"四个字,模型只能瞎猜反复试;把报错位置和原因写清楚,可能两轮就修完。知乎
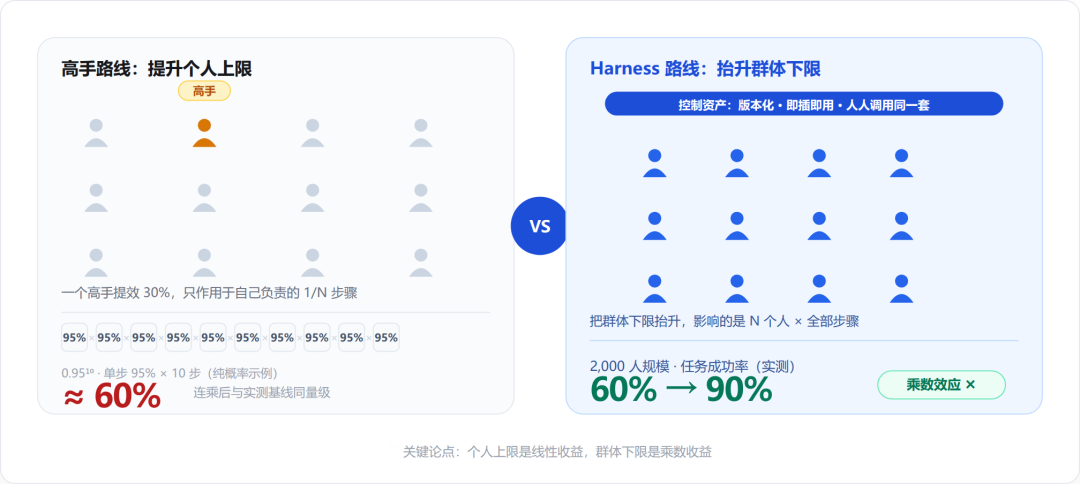
长链路会把小毛病利滚利。每步 95% 把握,连跑 10 步只剩 60%。中兴那条 200 多步的研发链路,改造前无人干预完成率只有 50%,一半任务跑到中途卡死,等人救场。知乎
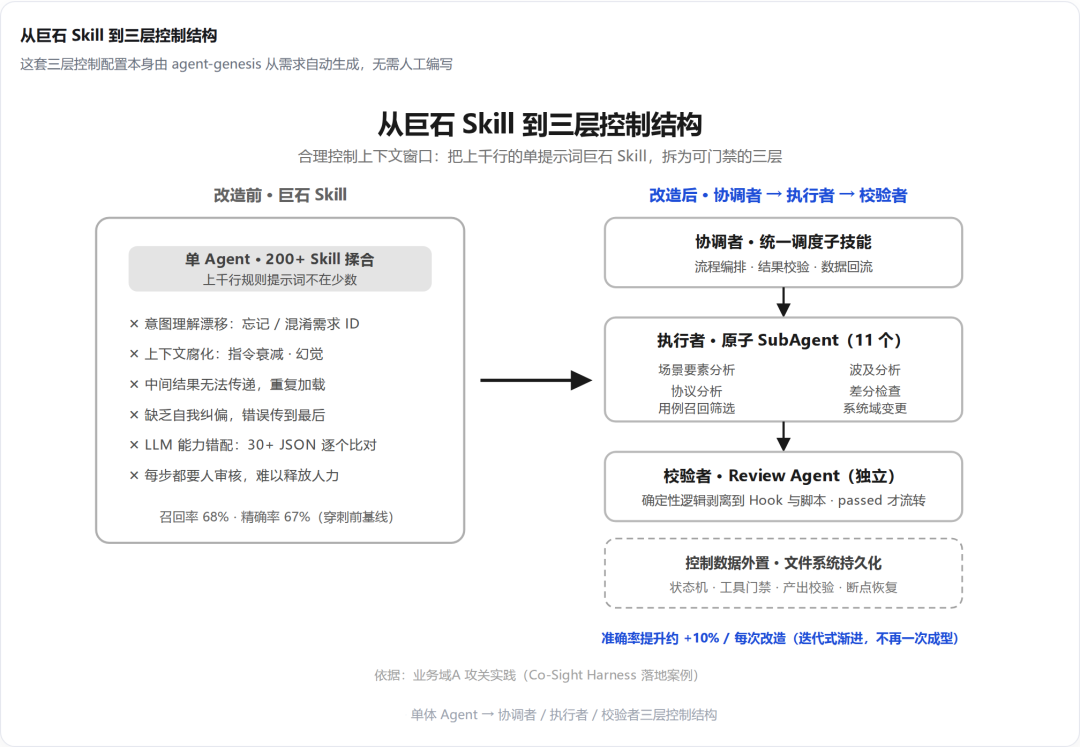
真正拉分项全在"模型外"。底座模型完全没换,Co-Sight 只重造了运行时控制结构:流程用状态机焊死,控制数据存在对话之外的本地文件里,审查 Agent 和生成 Agent 彻底隔离,严禁看设计方案——防止"自己改自己的作业"。结果:完成率 50%→100%,端到端耗时从 440 分钟压到 159 分钟,砍掉 64%;接入一个新场景从 2-4 小时缩到 5-10 分钟。
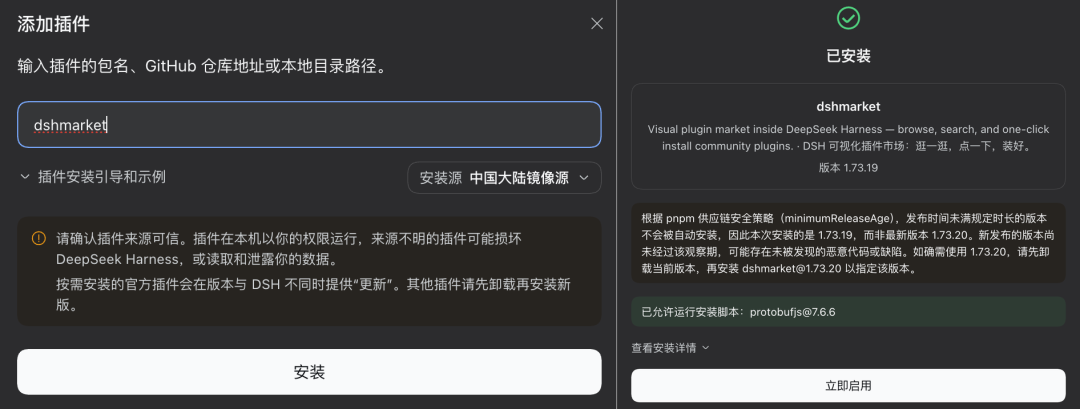
但刷屏的不全是好消息。DSH 上线 12 小时在 GitHub 狂揽 5 万星,Reddit 和 HN 的热帖却在集中吐槽老问题:插件疲劳——3.5 万个插件里大量是重复件、练手件、弃坑件,“找个插件的时间,比手动干完还长”。知乎知乎
评论区比正文还热闹:“DSH 比 Claude Code 更费 token?”“刷屏稿里的增长 5.7 倍,真实口径是 545%”。“日活 154 万对应 92 万亿 token,人均日耗 6000 万——用户画像就是开发者在烧积分”。知乎知乎
社区自己给出了对策:一个"用自然语言描述需求、自动生成新插件"的套娃插件 12 小时下载破千。找不到,就自己造。知乎
还有篇论文值得记住(CoEvo-RSI,2026 年 10 月挂上 arXiv):harness 把工具接口从 XML 换成 JSON 后,模型照样认得出该用哪个工具、参数也算对了,却仍按老写法调用,在入口被反复拒掉——作者管这叫"脑体错配"。知乎
这套演化流程走完,一个 9B 模型在多智能体责任判定上的正确率从 37.9% 提到了 68.4%。给 Agent 做选型,从此多一列:这个模型配的是哪一版 harness。知乎
普通 LLM 应用开发者,这周就能动手改五件事:
先修工具报错:别只印"执行失败",把位置、原因、下一步建议一起吐给模型;
编辑格式想清楚:精确替换省 token,但模型记错一个空格就整次失败,分场景用;
状态搬出对话:任务清单、进度、配置写进文件,别指望它们在上下文里保鲜;
生成和审查隔离:审查员只拿原始物料,不看写作过程;
检查你的质量门禁:中兴翻 Git 记录时发现 12 个审查规则文件里 7 个是 0 字节空文件,系统见空就放行——规则写没写,跑一遍才知道。知乎
Prompt 管表达,Context 管信息,Harness 管身体。 模型之争越来越贵,harness 之争才是这周能替你省钱、还能救回加班的那场。

当前文章无评论,是时候发表评论了