

DaisyRose-27B:回炉18天涨7项分,但12%真不是及格线
跑本地推理的都看过开源圈这出戏:谁又喊出"翻倍强",全网连夜下载,一周后删一半。这次不太一样的地方是——他们自己说了,没训新模型,基座就是你硬盘里那个 Qwen3.8-27B,只是拉回去炉了 18 天。
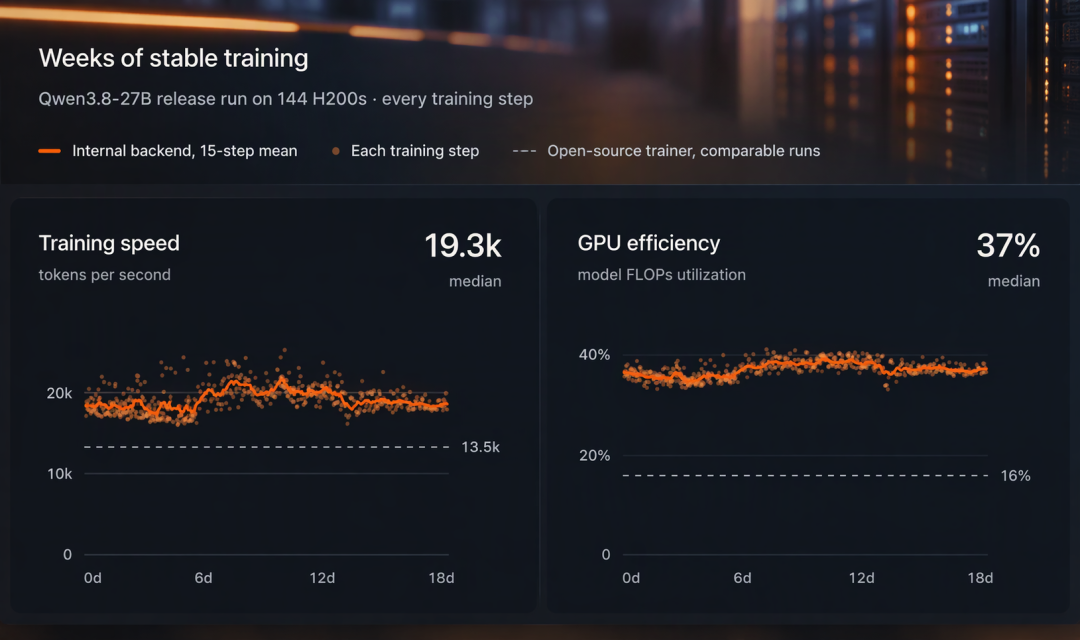
11 月 18 日,RadixArk(推理框架 SGLang 背后的团队)开源了 DaisyRose-27B:纯 RL 后训练,基座 Qwen3.8-27B,144 块 H200、训了 18 天,权重 Apache 2.0 许可。知乎哔哩哔哩
训练配方很"工程味":从几千个候选里筛剩 1200 个任务,每个任务都冲着引出基座模型犯错去设计——一单任务能连着调 100 多次工具、在沙箱里跑 1.5 小时、吐出 25 万多个输出 token。知乎
官方的成绩单:Terminal-Bench 4.1 的 pass@1 从 5.6% 涨到 12.0%,SWE-Bench Pro v2 91.3 到 94.7,GPQA Diamond 89.2 到 90.7,七项基准全涨,BF16 / FP8 / NVFP4 三种精度一次放全。知乎
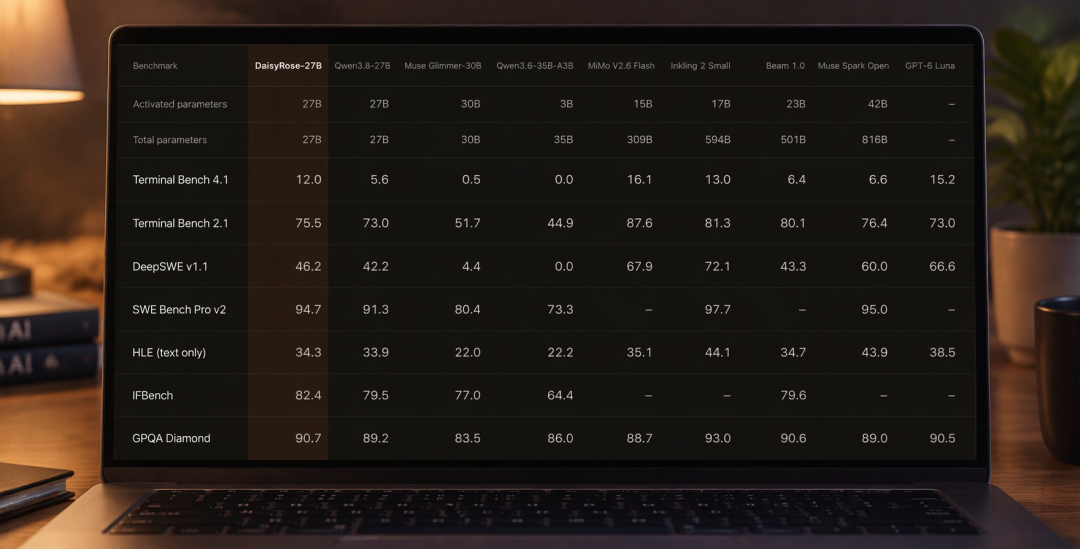
先泼冷水,也是最容易被标题写反的部分:"翻倍"是对它自己基座翻倍,不是对能力翻倍。Terminal-Bench 12% 意味着 100 个智能体终端任务里它还得挂 88 个,绝对值仍在起步区,还有不少难题眼下就是做不对。另外这些数字全部出自官方博客,目前还没有可信第三方复现,想冲的可以缓一缓。知乎
再看本地党真正关心的:能不能跑。B 站实测给的路标是,社区 MX 量化版本生成速度能跑到 60+ Tokens/s,显存占用约 20GB,24GB 的 RTX 3090 够得着门口,大统一内存的 Mac 同样可以考虑,上下文拉到 128K 左右仍能维持在 30~40+ 档。哔哩哔哩
什么人值得换?一句话:本来就在本地跑 vanilla Qwen3.8-27B、主要干代码和 Agent 杂活的人,换它几乎是零成本迁移——同基座、同显存门槛,只是工具调用链被 RL 修得更稳。提醒一句:官方公布的上下文以 256K 为准。"1M"是训练数据的规格,别把预期写进天花板。评论区有人问 2080Ti 22G 能不能上车:20GB 是量化版的地板,贴着线跑不等于跑得稳,别指望奇迹。另一类人直接跳过:冲"无审查"来的——这个项目做的是智能体任务的工程化 RL,安全口径跟着上游走,不是 0 拒绝护身符。哔哩哔哩
真正值得记进小本本的,其实是这件事的另一个信号:小模型后训练的竞争,正在从算法黑话转向任务质量和工程稳定性——9 周跑 94.4 万个沙箱、峰值并发 1566、成功率 99%、10 次升级不中断训练。翻译到用户视角:你手里的 27B 时代,短期内还会不断"免费变强"。等第三方复现落地,再决定要不要动手拉权重。知乎

当前文章无评论,是时候发表评论了