小米-OCR-0 能替普通人解决的是几件很具体、很费时间的文档麻烦:把拍下来的纸质文档转成保留表格和公式的可编辑文稿,按指定字段提取发票、合同等单据里的关键信息,把 PDF 和图片批量转成文字,以及让病历这类隐私文档在本地处理、不上传云端。但它不是一个下载即用的成品 App,而是一套开源的权重和代码,普通人现在要用它,得先接受"在线 Demo 或第三方工具"这两个入口。
这个 0.8B 小模型其实是三件事
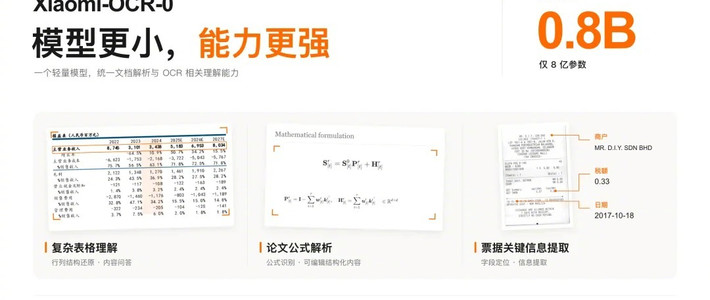
Xiaomi-OCR-0 是一个 0.8B 的统一视觉语言模型,训练起点是 Qwen3.5-0.8B,在约 1.7 亿条 OCR 中心样本上,用 Q-Mask 文本锚定、继续预训练和混合任务强化学习训出来,把文档解析、关键信息抽取、视觉问答三类原本要靠不同工具完成的任务,装进了同一个模型。GitHub
热搜里的它,其实已经发布了近一个月
9 月 30 日,模型团队在社交平台正式宣布发布并开源了这个由团队自研的 0.8B OCR 模型。 10 月 30 日晚,媒体端的报道集中出现:小米开源 0.8B 参数 OCR 小模型,可同时覆盖文档解析、关键信息抽取与视觉问答,性能在 1B 以下模型中登顶,现已开放权重与推理代码。 围绕"这一成果对端侧 AI 落地有哪些意义"的提问,也随之在热榜上聚起了讨论。小红书IT之家知乎
四类文档麻烦,它分别怎么管
拍文档、扫描页,直接变成可编辑的稿子。模型识别整页后输出结构化 Markdown,表格转成可放进文档的 HTML,公式以 LaTeX 输出——过去"扫出来一串乱码还要手动重排版"的返工环节,理论上少了一步。GitHub
发票、合同这类单据,可以"要什么字段给什么字段",对页面内容直接提问也能作答,结果以 JSON 输出,方便接进自动化流程。东方财富网
PDF 和图片批量处理,官方仓库自带 MCP 本地 Agent 工具与浏览器 Demo,能自己挂上自动化流程跑批。 屏幕划词、截图取字这类零碎需求,社区已经把它做成了"按快捷键框选屏幕、识别结果连同表格公式直接进剪贴板"的 Mac 插件,在 M1 Pro 上典型截图约 2 秒返回。GitHubGitHub
本地能跑,是它对小用户最实在的一点,但门槛要认清
原始权重约 1.75GB,社区量化后语言部分只有 517MB,加上 198MB 的视觉模块约 0.7GB,普通笔记本甚至 CPU 或核显环境就能跑起来。 隐私敏感的文档不必上传云端,这正是"端侧"讨论的核心收益。但它是开发者级工具:装起来要命令行、Python 环境和推理后端,连发布教程的实践者都建议,只想试试图片、PDF 转文字表格的话别急着本地装,先用在线 Demo。 截至发稿,小米还没有公开把它内置进手机或现成办公应用的计划。GitHub小红书
"登顶"和分数,口径要看准
"1B 以下登顶"是这波传播里最响的一句话。官方对比表里,它在三项文档解析基准上拿到 0.8B 档最好成绩。 团队也公开自述,它在同参数量里基本没有对手、甚至打赢了好几个更大的模型。 但同页对比中,1.2B 的 TeleOCR 在两项分数上仍高于它——"登顶"限定在 1B 以下参数段。另外要留意,这些解析分数出自官方页面的两阶段评测方法,真实使用效果会随图片质量和版式浮动。GitHub小红书
它也不是孤军:10 月 27 日百度开源文心 UnlimitedOCR2,主打超长文档的无限页解析;面壁同期开源 MiniCPM-OCR 系列,另辟蹊径让一个模型识别、另一个模型校验"该不该信"。OCR 小模型赛道正在快速拥挤,对用户的实际影响是:本地、免费、强力的文档识别引擎,门槛一直在往下探。知乎
最后把边界说清楚
第一,识别没有 100%:96 分以上的综合分数,意味着多数内容可靠,但合同金额、发票编号这类"错一位就出问题"的字段,仍需人工复核原件。第二,用法有讲究:官方建议规整印刷文档用区域解析,而场景文字、手写、书法、古籍要整页解析,避免区域边界切错丢上下文。第三,别把"开源了"读成"人人可用了"——现在它是工程师手里的引擎,普通人的收益点是先用官方在线 Demo 试试自己的真实文档,再观察第三方工具何时把它封装成开箱即用的功能。小模型卷到 0.8B 之后,文档处理的成本已经压得很低,剩下的只是入口何时打开。