显卡AI算力白捡八成?gpu-unlock,这三类人碰了才不亏
一块八年前的老显卡,不换硬件、不刷BIOS、连官方驱动都不用动,硬是被开源玩家把算力"挖"出来一截,特定运算直接翻倍。这周 gpu-unlock 系列工具刷爆了GPU社区,10月18日才建的仓库几天就攒下三千多颗星。手里的3080突然就不香……不对,是突然又香了。机器之心知乎
英伟达给游戏卡上的是一把什么锁
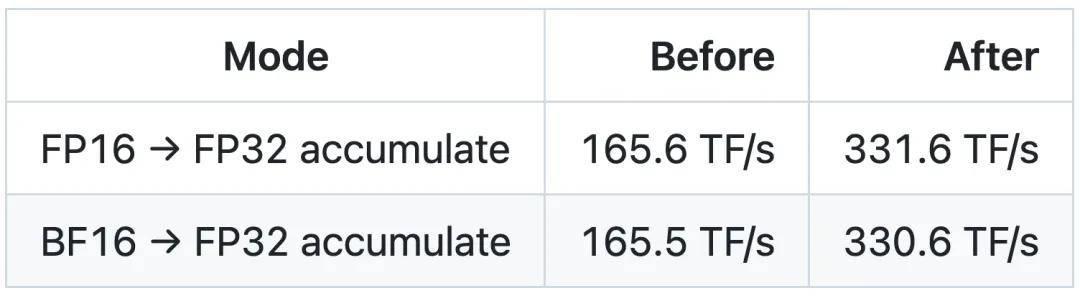
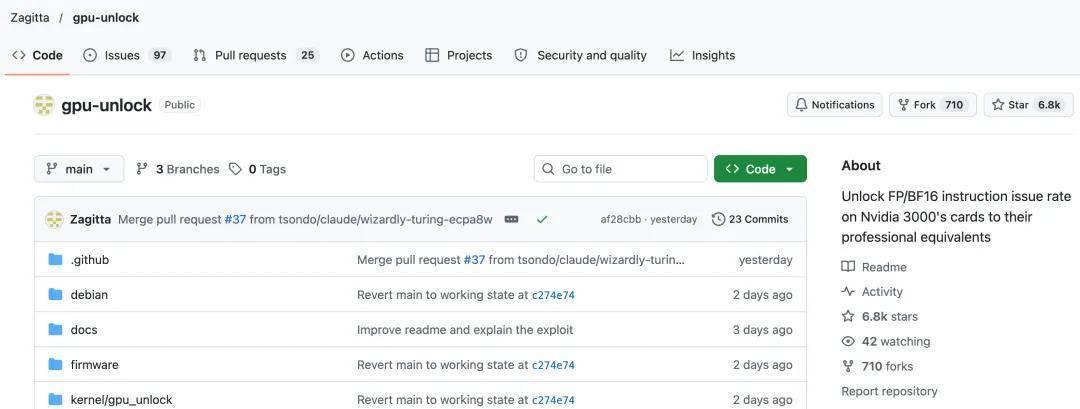
社区发现:部分GeForce游戏卡的Tensor Core,在执行特定混合精度运算时存在指令发射速率限制。这条被寄存器锁住的路径只有硬件能力的一半,而同芯片的专业卡却是满速。gpu-unlock利用GPU安全启动固件的漏洞拿到权限,改写速率控制寄存器,再经PCIe复位生效——未经修改的官方驱动照常接管。机器之心
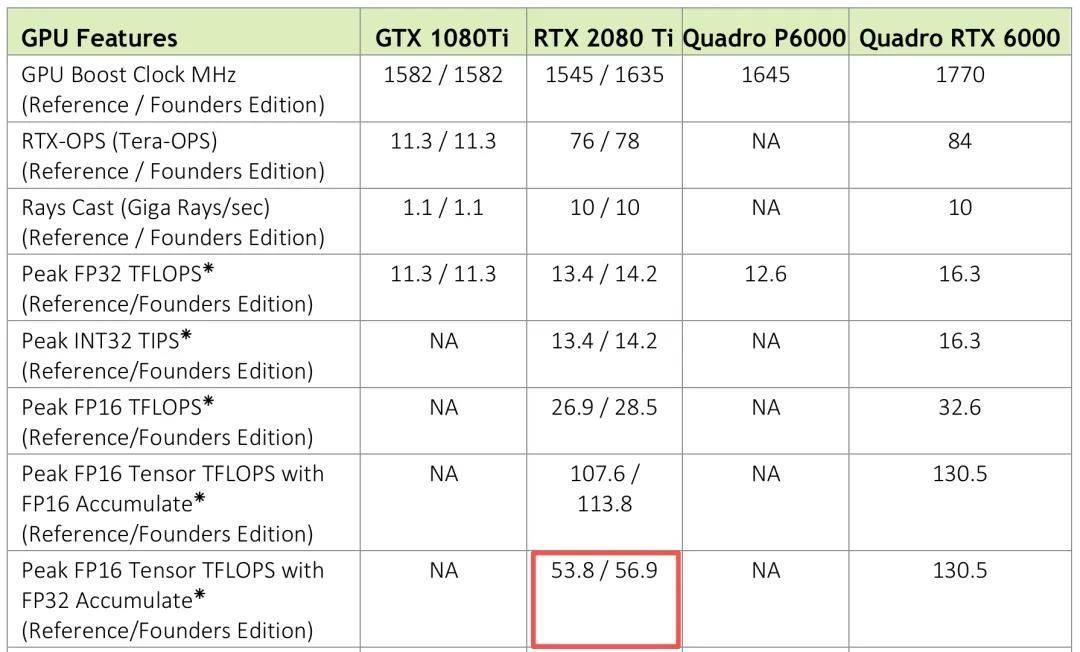
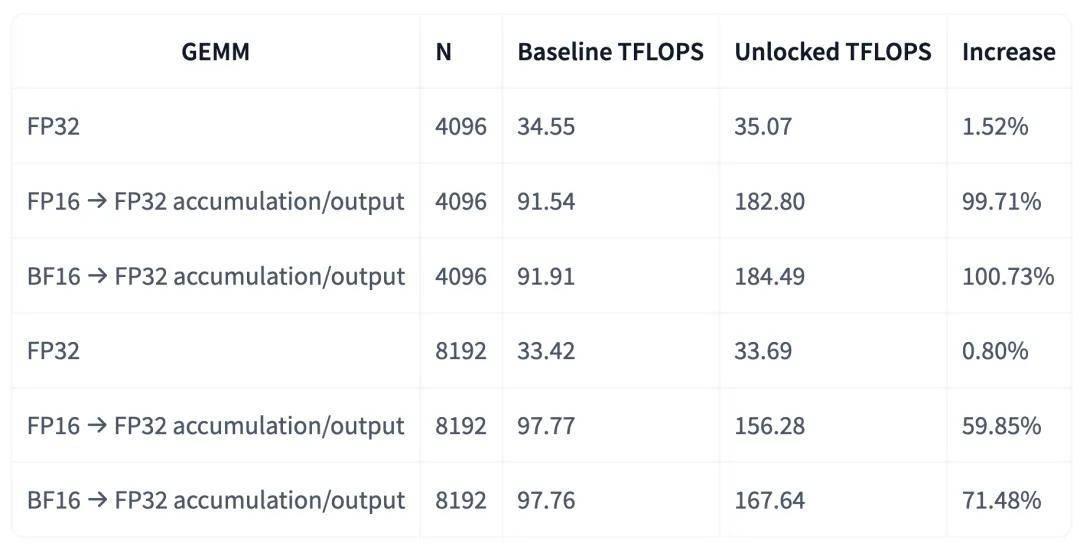
实测结果相当好看:RTX 4090这条路径的指令吞吐从165.6→331.6 TFLOPS,有人拿同型号卡独立复测确认。RTX 3090 Ti的BF16从87.5→157.4 TFLOPS,+80%。其他型号也差不多:3080 +73%、3070 +81%、3060 +76%,连2018年的2080 Ti,实际矩阵乘法也提升了约64%。机器之心知乎
先泼冷水:吞吐翻倍≠你的电脑翻倍
真实矩阵乘法(cuBLAS 4096³)只涨12%~34%,INT8、FP32和本来就不受限的FP16累加纹丝不动。机器之心知乎
本地跑大模型,vLLM的预填充提速约33%,但逐Token生成卡在显存带宽上,同样没变化。至于拿llama.cpp跑q4量化模型的,这16位算力你一点都用不上;游戏帧数也一样没变——高赞总结得很直白:对游戏党没用,对q4用户没用,对16位出图出视频的才是第二春。机器之心知乎
三类人能碰,两类人劝退
✔ Ubuntu系统下用30/40系老卡跑wan2.2这类16位精度的文生图/文生视频、或BF16推理的——有玩家的32G魔改3090跑视频直接快了85%。收益真实,白捡的甜点;✔ 愿意备份数据、自担风险的研究型玩家。知乎
✘ 游戏党别冲,这次解锁和帧数无关;✘ Windows实验方案和二手"魔改卡"别盲动——Windows侧目前只在特定改装显卡上跑通过,还不能当成普通40系通用的依据。这是固件级操作,翻车成本自己兜。机器之心
最后说句买卡的事
近期50系新卡价格一路刷新历史高点,5080已经涨到19499元。解锁消息传开后,海外二手平台上原本1000美元的3090 Ti,一周被炒到2650美元。我的建议是:手里有老卡的,当白捡甜点;手里没卡的,别为"可解锁算力"去接二手的加价盘——那是花真金白银,赌别人的工具链。知乎知乎