11月2日,腾讯混元发布了新一代科研智能体 Hyra 2.0。官方给出的变化不是“解题更快”,而是“换了活法”:研发重点从直接用 AI 攻克科学难题,转向让通用 Agent 参与科学模型、研究工作流及软件工具的研发与升级。 对不做科研的人,这篇文章值得看完的理由很直接:这场转向决定的是 AI 以后靠什么变聪明——靠多答对几道题,还是靠造出能被反复调用的东西。知乎
解题的成果是一次性的,造工具的收益是复利的。这是官方对比里最朴素的一句话,也是整件事的分水岭:过去刷掉再难的题,下一次研究仍要从头搭环境、重新试错;而升级一件工具,所有用到它的任务都能受益。知乎
解题这条路,为什么先撞上了墙
转向不是凭空发生的。今年 7 月上线的 Hyra 1.0 就是靠解题出圈:它参与攻克了加法组合学中一道悬置五十余年的开放问题,也验证了这条路的可行性。 但“答题”模式的麻烦在10月集中暴露:10月6日,OpenAI 一口气公布 722 份数学手稿、覆盖 372 个难题。凤凰网科技差评
几天后,OpenAI 就撤回了已发布的 3 篇论文,原因是符号写错导致论证失效。 据差评报道,此前陶哲轩还联合 25 位菲尔兹奖得主发布过声明,强调不能让 AI 公司把数学题当 benchmark 来刷——不是因为 AI 不强,而是现在的用法有严重错位。知乎知乎
错位具体在哪里?一位数学背景的研究者在知乎回答里点破:AI 事实上发明了新的工具,却仍用旧的数学语言来表达,导致人类看 AI 生成的论文非常痛苦。 答案越出越多,理解反而越来越贵。把“造工具”提为目标,正是对这条死路的修正。知乎
造工具,是在造什么
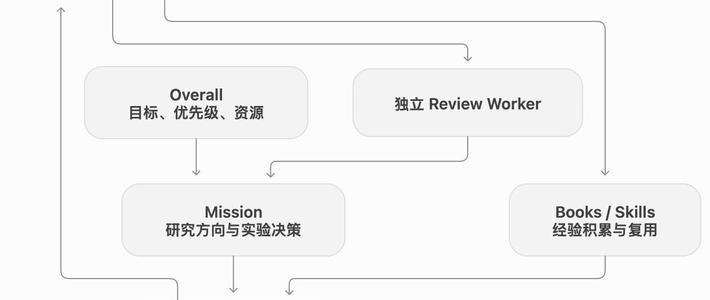
Hyra 2.0 的架构把研究工作拆成三层:Overall 与人类研究者沟通并对齐目标,Mission 长期负责单一研究问题并判断路线取舍,Worker 独立读代码、做实验、分析失败原因,甚至可以质疑 Mission 的判断。 任务不靠一个越拉越长的会话硬撑:等待训练结果时别的任务继续推进,进展写进共享看板,必须处理的问题才发消息打断人。凤凰网科技
真正让“复利”成立的是记忆机制:系统为项目状态、Agent 分层记忆与共享知识库 Books 设计了分离的存储,复盘时把可迁移的方法整理成 skill,供后续任务直接调用——经验第一次变成资产,而不是随项目散落的隐性劳动。 造出来的东西分两类:代码、工作流、验证程序这类符号化工具,改变的是“怎么做”;通过训练把规律存进权重的模型,改变的是“会不会”。共同点是,答题型 agent 的产物是一段文本,造工具型 agent 的产物是一个以后还能被调用的东西。凤凰网科技知乎
官方晒出的成果里,没有一项是“一段回答”:196 万参数的蛋白质逆折叠模型 HyInv,相对 ProteinMPNN 快 57 倍,128 条、402 个残基的序列在 H20 上约 50.6 毫秒生成完;量子纠错码工具 HyQEC 在 qLDPC 挑战里造出的编码效率比此前最优纪录高约 48%;数学证明工作流 HyProver 完成了包括丘成桐圆作用猜想在内的证明,并经数学家核验。知乎
不做科研,为什么也要关心
第一,AI 变强的方式变了,而它会传导到你手里的每一款产品。解题时代,进步靠堆算力多刷榜;造工具时代,进步靠可复用资产越滚越快。当日的整理类报道还提到一个更值得留意的说法:Hyra 2.0 已经参与下一代混元模型的预训练和推理优化,也就是 AI 在帮着训练更强的下一代 AI。 这一说法出自自媒体整理,官方口径尚未确认,只能作为待观察的信号——但“AI 造 AI 的工具”这个方向本身,已经是行业明牌:8 月 DeepSeek 开源智能体框架 Harness 时,36 氪的提问就是“AI 开始制造 AI 了?”。知乎36氪
第二,同样的叙事正在消费端上演。同一天,美团发布 LongCat-2.5,目标从“写代码”改成“做完项目”。知乎
实验室里的“经验沉淀成 skill、供后续调用”,和普通人给自己搭一条“只有关键决策才找人拍板、其余让机器按规则跑”的自动化流程,是同一种活法。 换句话说,值得学的不只是让 AI 多答一个问题,而是让它多留一件还能用的东西。知乎
第三,它重新划定了人的位置。Hyra 2.0 涉及较大算力开销和共享知识同步的操作,要经过人工审批。 它不是“全自动科学家”,而是一个能自己推进、但在关键路口会停下来问人的研究团队。系统内部最受约束的一环是证据链:谁汇报完成,就得附上代码版本、实验结果和原始运行轨迹,必要时由独立的 Review Worker 复核。对人类的要求,正在从“会执行”转向“会定义问题、会审查证据”。知乎
工具厂没开门,该盯的三个信号
这件事也有清晰的边界:Hyra 2.0 最核心的编排系统没有公开。三层之间怎么调度、提示词怎么写、评估器怎么判,外人都看不到;GitHub 上能拿到的仍是 Hyra 1.0 的成果仓库 Hyra-results(Apache-2.0 协议),2.0 的成果说会持续公开,但没给时间表。 能测的是产物,不是过程,57 倍、48%、5.79% 目前都还是腾讯口径,尚未经过独立复验。知乎
所以,接下来值得普通用户盯的信号有三个:成果仓库是否按承诺补齐、编排层是否开放哪怕一部分、57 倍、48%、5.79% 这类数字能否由独立团队在相同条件下复现出来。判断标准也很简单:如果一件工具只能留在原团队里,它更像一篇论文;下一个使用者能拿来就用、还能继续改,那才叫工具。 从解题到造工具,改变的不是你是否要去做科研,而是你手里的 AI 下一次变好用的速度,以及你站在流水线的哪一边。知乎