10月30日晚,面壁智能办了场特别的技术直播:让AI从零开始写一个GPU算子,人类全程不写一行代码。
目标挑得相当狠——DeepSeek开源模型里的FlashMLA Prefill算子。这是人类顶尖工程师手工打磨的实现,官方参考实现对AI全程封源,AI手里只有数学定义和硬件约束,跑在一张B200上。
22.5小时后,AI交出472微秒,基线是518微秒,快了9.8%。42轮迭代留下32个版本,消耗1张B200、22个GPU小时。小红书知乎
这条优化曲线值得细看
第一版出来是1834微秒,速度只有基线的0.3倍。不到4小时降到593微秒,降幅67.6%;第7小时前后出现一次结构突破,首次反超基线;第10小时左右稳定压过FlashMLA。后半段更有意思:AI自己发现Q的突发加载在跟KV搬运抢访存带宽,主动放慢Q的请求节奏,又压下2.4%耗时。这种判断,过去通常只出现在资深算子工程师的脑子里。小红书
靠什么赢的
方法叫promote + forge:每版算子通过验收后,就变成下一轮要打败的对手,逐代滚动向前;实测有效的优化经验存进知识库,跨任务复用。整套系统基于Claude Code搭成,Teacher和Student两个Agent分工。知乎
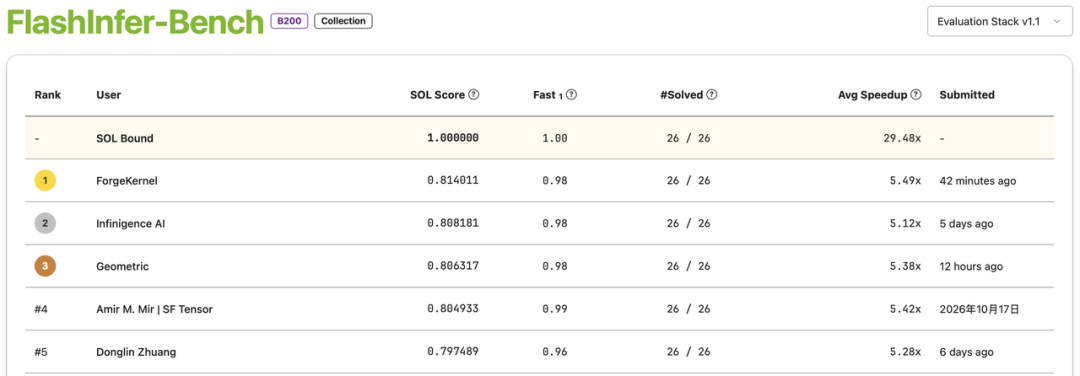
单场直播可能算运气,榜单不会说谎。英伟达侧,ForgeKernel完成FlashInfer-Bench在B200上的全部26项任务,以0.814011的SOL Score(通过正确性与作弊检查后的综合评分)登顶,平均加速比5.49倍。知乎
华为侧是另一份成绩单:包揽CANNBench的A3、950DT、950PR三个硬件榜第一。自10月15日封榜至今,没让出过第一。知乎小红书
配套论文JustGoal的数据更直接:只给目标不给算子知识,10个算子里8个跑赢人类维护的开源库;22个专家库实现里,18个达到或超过基线。知乎小红书
热度之外
数字全是官方口径,没有第三方复现。直播成绩在被独立验证之前,当能力演示比当结论更合适。
AI擅长调细节,不擅长做架构。论文自己承认这一点。知乎评论区也有人贴出真实踩坑经历:只丢一段PyTorch逻辑让AI写kernel,三轮全在原地打转,贴一个能跑的参考版本后才开始真正优化。小红书知乎
真正的问题是门槛在换位置。算子开发的门槛从来不是CUDA语法——这部分最先被自动化吃掉;难的是判断瓶颈在访存还是算力、该优化哪一层、怎么用最小代价拿到可验证的收益。热评那句"CUDA:什么叫我的护城河被护城河撅了"拿到108个赞。玩梗背后是真焦虑。知乎
对正在学CUDA的人,这不是坏消息。手写的活会越来越少,但知道往哪儿使劲、把验证和反馈循环组织给AI,恰好是新门槛所在。DeepSeek的算子工程师刘胜说得更直接:为了生产效率和算子性能,现在的AI干活儿比他快,以后的AI还会又快又好。知乎