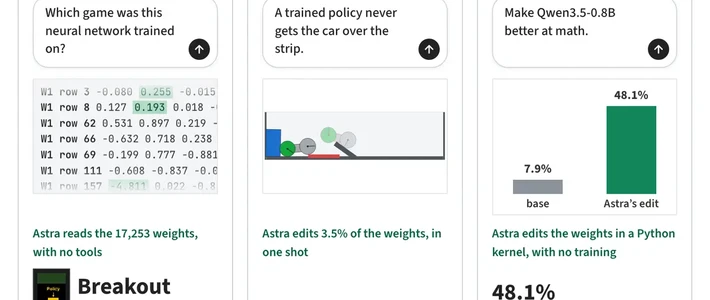
MIT CSAIL 团队让 GPT-6 Astra 直接编辑 Qwen3.5-0.8B 的权重,只修改约 0.016% 的参数,MATH-500 就从 7.9% 升到 48.1%。 整个过程没有重新训练模型,也没有使用梯度下降。这组数字被概括成“数学能力涨 6 倍”。机器之心
但“6 倍”描述的是分数变化,不是六倍数学智能被装进模型。论文给出的机制更朴素:Qwen3.5-0.8B 开思考模式后容易陷入重复循环,最初 96 次练习里有 85 次一路写到 32,768 个 token 的上限。 Astra 把循环追到第 15、19 层 MLP 写出的一个方向,从每层 64 个输出列中减去它,共改动 131,072 个权重。 改完后,MATH-500 撞到长度上限的比例从 93% 降到 33.1%。 分数跳上去,首先是因为答案终于能写完。机器之心MIT CSAIL量子位
更关键的是 Gemma 3 270M 这组对照。它更小、采样也不同,但关键差别在故障形态:Qwen 有一个可定位的循环,Gemma 只有分散错误;同一套 Astra 流程里,Gemma 只有 8.5% 的答案触到长度上限,而 Qwen 是 93%。 在 5、10、25、50 次前向调用四档预算下,MATH-500 从 6.8% 只走到 7.0%、7.6%、7.7%、7.0%,这些修改都没能让成绩提升超过约 1 个百分点。MIT CSAIL机器之心
作者结论很直白:编辑权重可以移除遮住能力的障碍,却不能补上模型原本没有的能力。机器之心
Qwen 的曲线也不是慢慢爬上去的:10 次和 25 次前向调用时,MATH-500 只到 12.3% 和 14.1%,撞线比例仍有 87.2% 和 86.4%;到 50 次,分数才跳到 48.1%,撞线比例降到 33.1%。 分数跳变和循环缓解同处发生,比单看 48.1% 更能说明机制。MIT CSAIL
但这还不是稳定的“维修服务”。10、25、50 次是三次独立运行,各自找到的修改不同;50 次这一档没有重复多次,48.1% 不能当成必然可复现的结果。知乎
成本也没“只改 0.016%”那么轻。公开日志里,最强的一次运行花了 20.3 小时,包括 158 个对话轮次、80 次 Python 执行,以及 4.7 小时的服务中断等待。 这仍是博客和公开日志,没有同行评审。知乎
那“从零写权重”呢?在 MinAtar 和 9 路围棋里,Astra 确实能从零写出网络,部分成绩超过训练 1 亿步甚至 5 亿步的 PPO。 但对象是权重全为零的小网络,规则、结构和评分都给了它;它做的是把规则翻译成网络程序,不是给成熟模型塞进它从未具备的知识。MIT CSAIL
另一个边界:只看两个 Gemma 的权重,Astra 分不出哪个被微调成迎合用户;允许它看注意力分布后,才在三对模型里全部认对。 至少在这个任务上,“读”仍要额外信号;谈“直接给大模型加能力”就更早了。目前还没有第三方对整套方法做独立复现。MIT CSAIL机锋网
准确地说:权重空间编程不是凭空加能力。它最扎实的成果,是把权重从只能由优化器更新的数字,变成可以用自然语言诊断和局部修改的对象;它擅长拆掉一个具体故障,也能在小网络上从零搭出程序,但还没有证明能给一个成熟模型稳定增加原本不具备的高阶能力。真正能支持“加能力”的实验,得找一个不循环、没有单一故障、但确实缺某项能力的模型,让同一套方法在多个模型、任务和随机种子下稳定把它教会。这个实验,目前还没有出现。