先问自己一件很扎心的事:你攒了十几年的笔记,到底存在哪?如果答案是"某个 App 的云端空间",那在 AI 时代,这笔财产正在悄悄贬值。知乎用户"比特候鸟"的说法很扎人:可以供给给Agent的就是资产,被锁在软件里的是数据。知乎
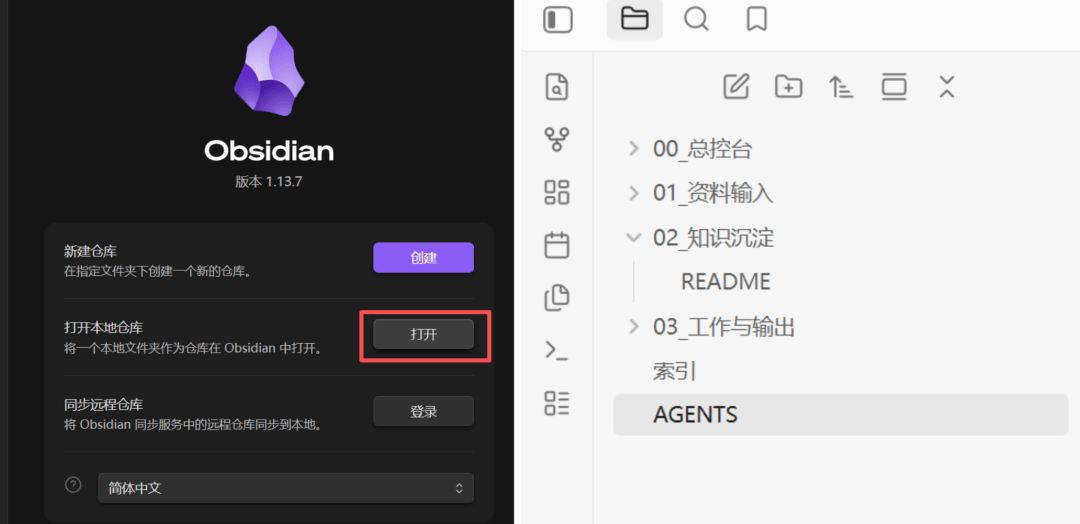
最近"为什么 Markdown 成了 AI 时代知识管理的默认格式"这个问题在知乎热了起来,有回答被收藏了 700 多次。我翻完全楼,发现高赞评论一句话戳穿了本质:它被大规模采用,不是因为方便人写,而是因为方便机器读。 人爱排版精致,所以有了复杂的富文本体系;模型的需求恰好相反——标题、段落、粗体、链接全是明牌结构,零解析成本。Word、PPT 那种排版"卷上天"的文档,AI 得先费劲拆解,才轮得到理解内容。知乎
多数人真正的坑不在新笔记,而在存量:几百个 PDF、PPT、Word 堆在文件夹里。B站评论区就有学生问:老师发的课件怎么喂给笔记里的 AI 插件读?标准答案是——别把原始文件直接丢给 AI。微软开源的 markitdown 是现成的"万能钥匙":pip 装完,一行命令就能把 pdf、ppt、excel、word 甚至音频视频批量转成 md,本地离线跑、不烧 token,转几十万份文件"只花点电费",配上 OCR 插件连扫描版 PDF 都能啃。当然它不是 100% 靠谱:双栏排版、复杂表格、页眉页脚照样可能错位,重要文档转完最好人工扫一眼——这是工具的诚实边界。说到底就一句话:先变成干净的 md,再喂给 AI。哔哩哔哩知乎
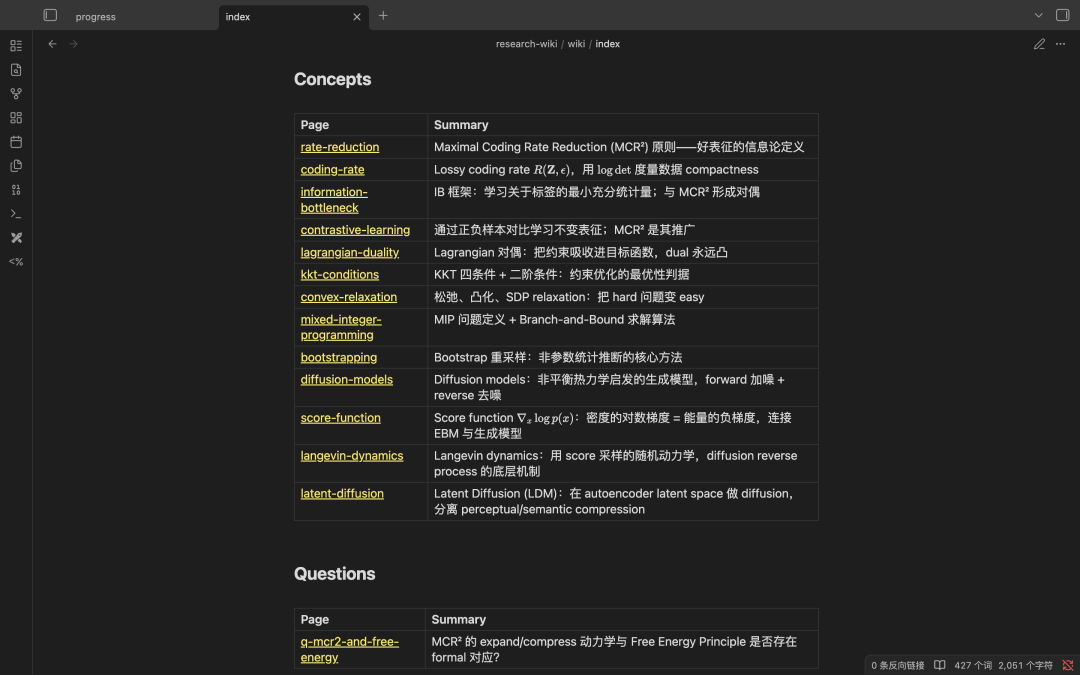
增量习惯也简单:每条笔记开头用 frontmatter 标好类别、主题、日期,Agent 靠元数据定位,而不是全文盲扫,又快又准。日常分工可以记住一句话:Agent 负责"动",本地 md 负责"静"——提醒、定时任务、周报初稿交给 Agent,沉进库里的只留会议纪要、决策记录和提炼后的干货。知乎
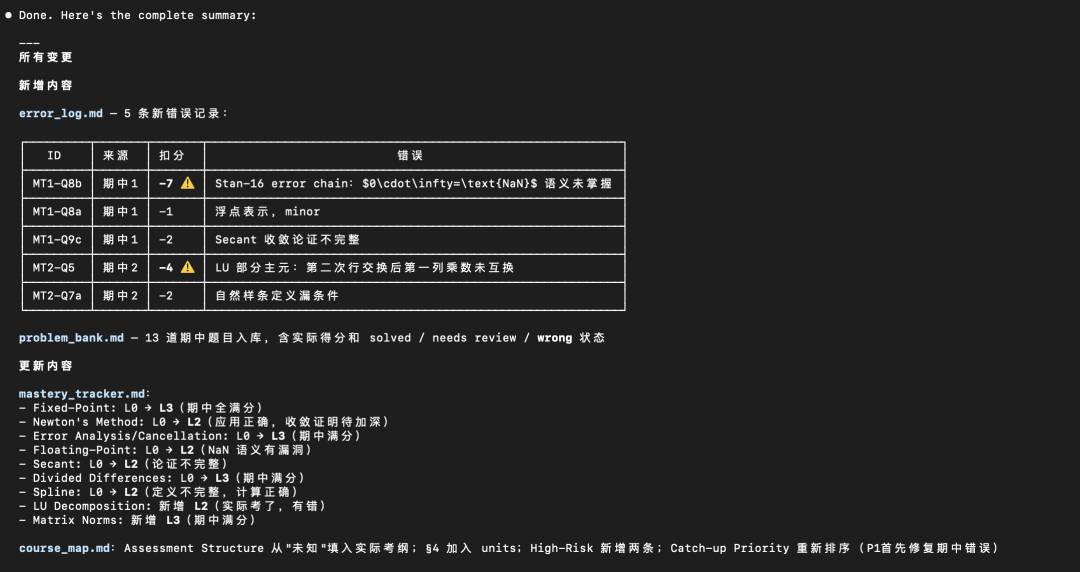
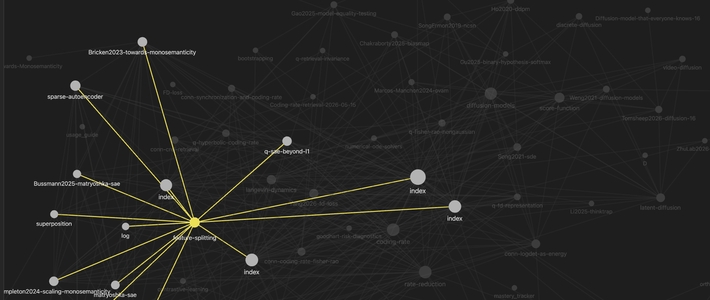
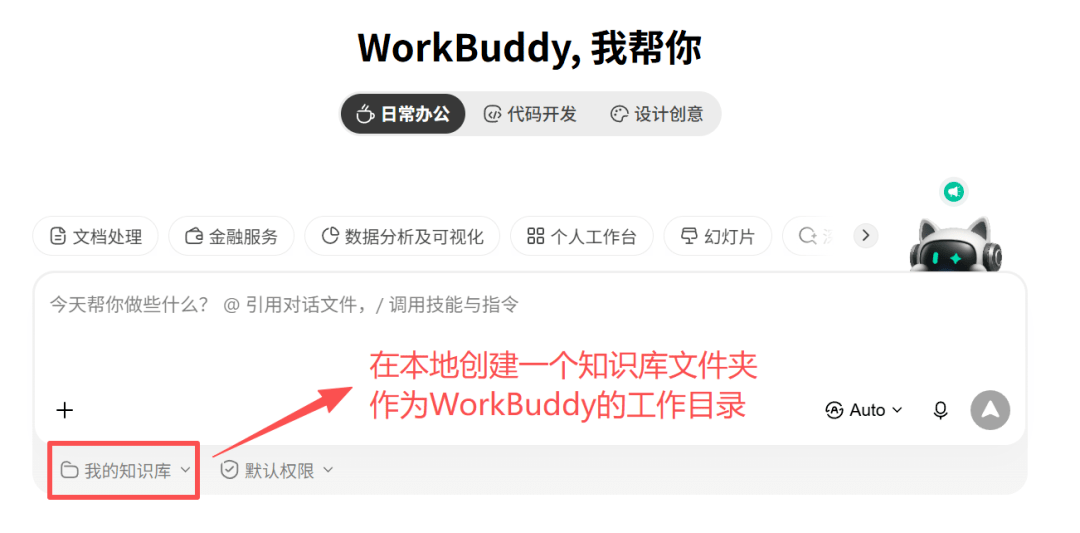
最该警惕的,是把知识库建成收藏夹。有用户说得很直白:库的总量到了某个量级,你基本不可能再打开它,它唯一的用处就是给 AI 当总库来搜。搭完就不看的库,不叫知识管理,叫数字囤积。判断标准就一个问题:你问 AI 东西时,它能不能直接从你的库里把答案读出来?而做到这一切的前提,是把本地知识库文件夹直接挂成 Agent 的工作目录——库是它的食堂,不是你的摆设。小红书知乎
顺便一提,连免费开源的 Opensidian 都做出了,目标就是兼容 Obsidian 库格式、不被专有软件绑定——"随时能走"正在重新成为刚需。格式是租约,本地纯文本才是房本。 从今天起,你存的每一篇笔记,最好都存成 AI 读得走的样子。知乎