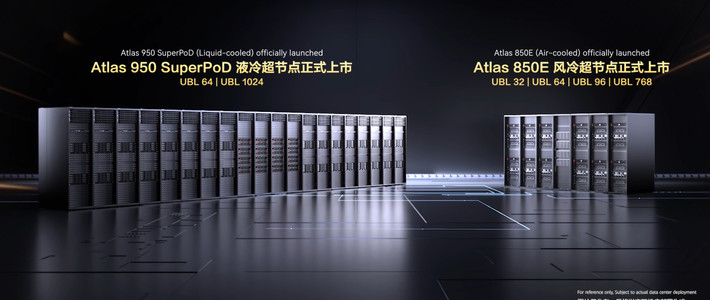
11月5日上午,华为中国官方对外宣布:前一天月之暗面开放Kimi K3.1 Pro完整模型权重,华为昇腾已基于vLLM Ascend、SGLang两个开源推理引擎同步完成0Day推理适配——开发者在权重发布的当天,就可以开始在这套国产算力上部署和验证这个2.8万亿参数的大模型,支持的硬件覆盖Atlas 800 A3、Atlas 900 A3 SuperPod以及昇腾950超节点系列产品。微博
“0Day"不是新品发布的意思,而是生态适配的术语:硬件厂商不等模型上线后的适配窗口期,而是在发布当天就完成接入,首日可部署、可验证。这次的时间点值得掰清楚:0Day卡的是"权重开放”,不是"模型发布"。K3.1 Pro早在10月24日就已上线,当时开放的是API和产品入口,官方预告完整权重在11月4日前放出。 11月4日,权重按模型卡正式公开:总参数2.8T,MoE架构下每个token只激活约104B,原生多模态,上下文窗口1,048,576 tokens,权重磁盘体量约1.56TB量级。36氪知乎
这次适配的,是一条全新的稀疏注意力路径
K3.1 Pro采用混合线性注意力与稀疏注意力架构,具备百万token上下文和视觉理解能力。 与上一代K3相比,它在结构上最大的改动是把全注意力层换成了DeepSeek的稀疏注意力算法DSA,技术报告的原文是"we replace the full-attention Gated MLA layers with Gated DeepSeek Sparse Attention (Gated DSA) layers for more efficient long-context modeling"——百万级上下文能算得动,靠的正是这条新路径。IT之家知乎
对硬件厂商来说,难点恰恰在"新增"二字上。昇腾推理团队依托K3已有的适配经验提前做了模型分析,在已有KDA与MoE支持的基础上,补上了K3.1 Pro新增的稀疏注意力路径和多模态推理适配,优化覆盖历史信息筛选、稀疏注意力计算、分布式缓存等环节,长上下文推理才有可用的算子与服务链路。 一个值得注意的差别:7月Kimi K3开源时,昇腾的0Day同时完成了训练复现和推理部署两条线;这次的公告口径只有推理部署,训练侧未作承诺。华为计算微博
从"能下载"到"能跑",是集群规模的账
权重可下载不等于人人能跑。1.561TB已经是量化之后的体量,光把权重装进显存就需要机柜级集群——按单台8张80GB卡共640GB显存估算,仅静态装载就需要2.5台以上,还没计入KV缓存、激活值、通信缓冲和副本冗余,百万token上下文的KV cache是另一笔独立开销。知乎
而这次0Day硬件名单从Atlas 800 A3服务器到昇腾950超节点的梯度,对应的正是从单机到机柜集群的不同私有化部署规模:昇腾950超节点通过灵衢互联把1024张NPU组织成一套,支持跨物理节点的统一内存编址。 这套超节点11月2日刚获得世界互联网大会领先科技奖。知乎CNMO科技
对企业用户的现实含义,一句话能说清:昇腾0Day降低了国产卡上的验证门槛,但不降低存储、互联与运维成本。 "要不要自建"之所以重新变成一道选择题,与模型侧最近的额度争议直接相关——发布后"额度几分钟烧完"是订阅用户最集中的吐槽,月之暗面已发公告返还25%额度。 手里已有昇腾集群的团队,从"观望权重"到"首日开工验证"之间,不再需要等一个适配窗口。知乎36氪
两条边界要一起读。许可证方面,权重适用自定义的Kimi K3.1-Pro License:对自用和中小团队接近无门槛,但对外售卖推理服务和大体量流量场景需要法务把关,不能简单等同于"随便商用"。 性能方面,华为和月之暗面这次都没有公布昇腾上的吞吐、精度数据,0Day确认的是"能跑","跑多快、划不划算"还要等推理框架发布复现配置、首批部署方回传实测。知乎
把时间线拉长,这次不是孤例而是惯例的延续:今年7月K3开源时,昇腾即实现0day适配,训练复现和推理部署两条线同时完成;10月底MiniMax开放新模型权重,报道标题里同样写着华为昇腾将接入。 国产旗舰开放权重模型与国产算力"首日可用",正在从惊喜变成默认动作。接下来最短的观察窗口只有一个:vLLM Ascend和SGLang随后补上的K3.1 Pro复现配置与实测数据。36氪