10月31日晚,DeepSeek Harness 团队发布《Super-agent 设计探索:迈向更自主的 Agent 系统》,同步开源了一个 MIT 协议的原型。36氪
先厘清一件事:这不是新模型,也不是正式产品。README 第一句就写明,这只是研究原型,不是 DeepSeek 的正式产品。GitHub
它想解决的问题很具体:一个人通常只能同时跟进 3 到 5 个活跃 Session,单任务的上限取决于模型能力,多任务的上限取决于人的注意力。DeepSeek
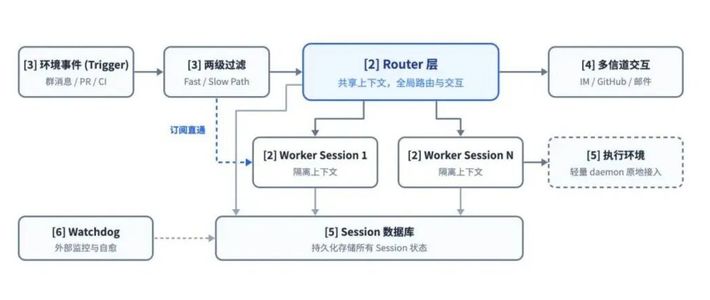
办法是双层结构,把“跟人打交道”和“干活”拆开。最外层是常驻的 Router,接住群聊、邮件、GitHub 的消息,判断哪些事值得做、该交给谁,并统一对外回复。下面是 Worker,各自在隔离的上下文里执行,挂完整工具,用最强模型,但不直接跟人说话,只向 Router 交报告。按文章的设计,Router 不直接执行具体任务,只负责人类交互和任务分派,甚至可以不配 Bash 工具。DeepSeek
这套分工的关键不是“多 Agent”,而是“要不要分工”不再由模型临场决定。官方做过一组对照:同一个模型、同样的输入,用中性提示词,5 次运行没有一次调用子 Agent;换成“优先委派”的提示词,5 次里有 4 次派了活,但仍有 1 次觉得任务小、自己上手。36氪
围绕双层结构,还有四个部件:事件驱动、异步交互、存算分离、外部 Watchdog。事件驱动是先把群聊、CI、评审评论变成 Trigger,用规则筛掉大部分噪音,再让模型判断;已经归属的 Thread 后续消息直接投给 Worker。异步交互是把耗时命令转后台,结果回来再作为新事件投递。存算分离是 Agent 循环在云端、状态进数据库、执行环境留在本地,端侧只放一个轻量 daemon。外部 Watchdog 则是一个独立会话,定时醒来判断 Worker 有没有实质进展、有没有跑偏。DeepSeek
官方用约 300 条消息、20 个工作请求做了模拟测试,编码工作被换成一个只消耗时间的工具,测的是调度,不是代码质量。官方报告的中位数是 12.4 分钟,p95 是 15.7 分钟。 同一实验里,带子 Agent 工具、用中性提示词的单会话方案,p95 是 29.5 分钟。DeepSeek36氪
代价也很清楚:多会话的读缓存 token 高于单会话。去掉订阅直通后,完成时间几乎不变,但 Router 要做的决定多了约 30%,单次实验总读缓存 token 从 2323 万涨到 3177 万。DeepSeek
要分清文章和原型。文章说 Router 甚至可以不配 Bash,但公开原型并没有真的拿掉它的 Shell。 原型保留了 Shell,只是加了禁止 sleep、限制前台等待等约束。知乎
官方列了未解问题:Router 怎么扩展、跨月记忆、Agent 间通信、提示词注入。主动接单默认是 observe 模式,只记录“如果允许我会做什么”,要人看过再切到 auto。 文章还提醒,云端 Agent 一旦被提示词注入攻破,所有连接的端侧设备都可能被控制。知乎DeepSeek
也有开发者认为,真正的问题不是把 Session 藏起来,而是把上下文显出来。 路由一旦猜错,在能对外动手的系统里就是事故。知乎
这份架构最值得看的,不是“AI 管 AI”的画面,而是它把一组原本靠模型临场判断的事——要不要分工、消息给谁、任务算不算完成——变成了系统结构。它没有让模型更聪明,只是试着让人少当几个窗口的项目经理。验收这一端,人还在。










校验提示文案
校验提示文案