

这周热榜把三家的代码能力放到同一张考卷上,答案比预想的绕:最容易“长”出新屎山的,和最会修旧屎山的,目前是同一个——GPT。但堆法各家不同:GPT 过度设计、代码越写越肿;Claude 写得太漂亮、让人放松审阅;Gemini 常把活干成半成品。而决定项目烂不烂的开关不在选型,在于有没有人还读得懂 AI 生成的代码——GitHub 的统计口径下,2025 年 9 月约四成 PR 已由 agent 起草。知乎
这周的题目,来自一场“屎山比武”
B站UP主“Token就是词元”(4.7万粉丝)从10月底开了“屎山论剑”系列:把各家旗舰模型逐个扔进真实的祖传代码Bug里,按修复轮次分高下。11月18日那场是 Gemini 4 三兄弟集体赴考,视频标题直接写着“Gemini4扬眉吐气,三兄弟屎山BUG大论剑”。该集播放10.3万;11月20日更新的正赛才是御三家旗舰正面交锋,视频简介点名三位参赛者:Fable5.2、GPT 6.2 Astra 与 Gemini Carbon。视频上线四小时播放破3万、评论超1100条。哔哩哔哩哔哩哔哩
评论区顶到前排的是“K004”的战绩:它出自真实遗留系统,被视作史山大当家,只有经过考验的模型得以与之见面,至今共计9个模型挑战过。按这份整理,GPT-6.1 Sol 和 Qwen 4 五轮没过,Grok 4.7、Gemini 4 Argon、4 Carbon、Fable 5.2 三轮没过,此前唯一通关的是 Opus 5.5,花了五轮;而这一期,GPT-6.2 Astra 两轮通过。哔哩哔哩
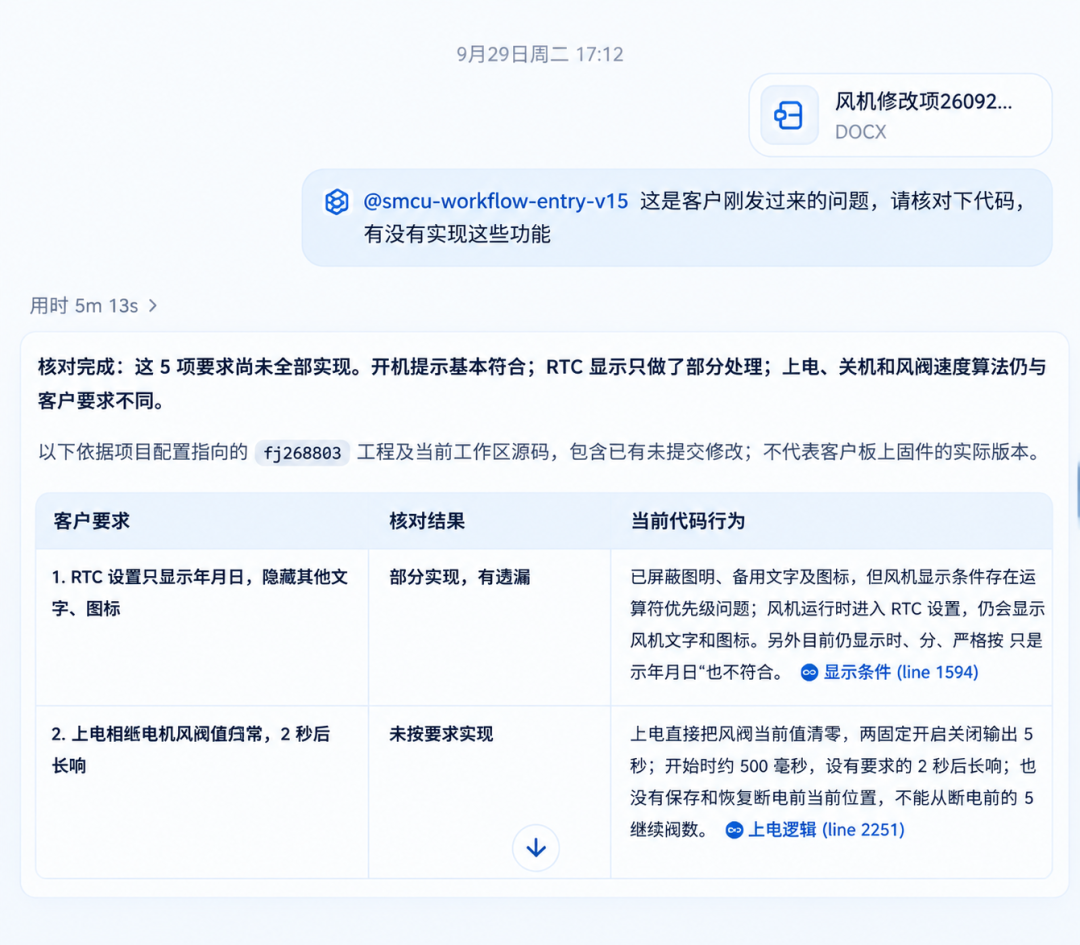
独立验证也出现了:另一B站UP主“程序员阿江-Relakkes”用自己攒的老ERP屎山题库测修复能力,上一代GPT在第一道题还要追加一轮提示。结合论剑中两轮拿下K004的记录与阿江题库首轮全过,当前社区独立测试的信号都指向 GPT-6.2 Astra 在“修屎山”这条线上领先。哔哩哔哩哔哩哔哩
但要划清边界:这些都是单人UP主的单集小样本,UP主本人给视频打了“含AI生成内容”标签,评论区高赞也在自我提醒“不能据此得出GPT已经彻底起飞的结论”;小红书同期流传的另一组基准自述则给出相反结果——“仓库修复Gemini4表现最强”。这些结果只能当信号,不能当定论。小红书
三家堆屎山,各有各的堆法
GPT堆的是“膨胀山”。知乎一位长期实测后端的答案说得很直接:GPT 系纪律性和性价比强,但缺点是会过度设计,必须在架构上狠狠挤水,否则后端会膨胀成屎山。论剑区的用户补了另一半体验:6.2 版本强得没悬念,但不说人话、越来越吃提示词,第一轮常因粗心翻车,靠追加一轮“逼”出真实水平。它是为做题而生的代码机器——代码写给判题器看,不是写给你读。知乎哔哩哔哩
Claude堆的是“信任山”。同一片实测区里 Claude 的口碑是反面互补:审美和直觉公认最好,阿江直言自己的前端评测里更喜欢 Claude 模型的审美。但那位后端实测者的警告也针对它:Fable 太聪明,而且这种聪明显而易见,最大的危险性是让用户过度信任它的周全性,其纪律性在后端设计上反而不如 GPT。漂亮、周全、看得人放心——恰恰是最容易没人逐行审的组合,K004 上它是三轮没过的那批之一。哔哩哔哩知乎
Gemini堆的是“半成品山”。它这周的存在感来自价格和评测:谷歌11月18日发布 Gemini 4 Neon,在独立机构 ArtificialAnalysis 的综合智能指数上得61分、总排名第三,价格不到 GPT、Claude 旗舰的四成。它堆屎山的强度在三家里最低,但社区给它的评语是“干活没有 GPT 和 Claude 那么可靠,拿来出主意很好用”。风险从“堆山”换成了“留给你一堆不敢合的草稿”。微博知乎
真正决定屎山的,是“没人来得及读”
把三家的堆法摆齐之后会发现,触发条件是共用的。知乎答主白头豕给屎山下过一个工程化的定义:一个 N 个文件的项目,如果问题不能通过 Log(n) 量级的阅读完成心智建模、必须遍历所有文件,就是屎山。AI 改变的只是到达这个状态的速度。11月20日知乎刚出现的热帖说得最直白:技术债不是AI生成出来的,是“没时间读”攒出来的。知乎知乎
更硬的证据链来自站外。11月11日,一篇前 Meta 工程师的文章冲上 Hacker News 首页,作者自述在 Meta 最后几个月90%以上代码由AI生成,这仍是合格绩效的最低线,而 AI 并没有让他的产出翻倍。他列的四种变脆机制——测试写得浅、为 DRY 而 DRY、人对代码库的理解流失、速度压垮评审——没有一条绑定某家模型。知乎
研究机构给出的数字更反直觉。METR 在2025年7月的随机对照试验里,16名资深开发者做246个真实任务,用AI的一组平均慢了19%,做完却仍自认快了20%。知乎
DORA 对约5000名从业者的2025年调查则显示:AI 采用率和交付吞吐量正相关,和交付稳定性负相关,三成受访者对 AI 生成的代码基本不信任。生成端快了一个量级,理解端没有——屎山就这么攒出来的。知乎
连“让 AI 把山修回去”也不是保险箱:B站“喵了个猫了个咪了个猫”让12个AI组队优化同一段屎山代码,有的快了上千倍,有的比原来还慢。DORA 的结论放在这里最合适:AI 修不好一个团队,它只会放大这个团队本来的样子。哔哩哔哩知乎
回到标题:谁最容易堆,你该怎么办
按本周社区实测与长期反馈排序:最容易堆出新屎山的是 GPT——过度设计加上只对着任务出代码,不挤水就膨胀;最容易让你不知不觉住进屎山的是 Claude——它的问题恰恰是让你不想审;Gemini 则是把风险从“堆山”换成“返工”,便宜快但交付不敢直接合。
选择可以按分工来:修老系统、刷后端疑难 Bug,当前信号优先 GPT-6.2 Astra;做架构和前端,Claude 直觉更好,但要强制自己逐段读它的输出;要初稿、要出主意、要低成本跑量,Gemini 够用。比选型更值钱的,是那篇 Meta 观察文留下的自查动作:翻出你最近合并的三个 PR,不看 AI 总结,讲清每个改了什么——讲不清的那一个,就是变脆的起点。用一位老程序员的话收尾,AI 代码要么全看,要么全不看,不可能有中间态。抖音
当前文章无评论,是时候发表评论了