

11 月 20 日,腾讯混元把旗舰模型 Hy4 的权重正式公开,GitHub、Hugging Face、ModelScope 和 GitCode 四个渠道均可下载部署。模型安全评估卡片(System Card)也随权重一起发布,从 Hy3、Hy4 preview 到 Hy4、Hy4 flash,混元 Hy 系列就此完成全量开源。想在自己机器上跑 Hy4 的人,其实分属两类门槛完全不同的场景:旗舰 Hy4 总参数 770B、每 token 激活 49B,官方 README 里 vLLM 和 SGLang 的示例跑的都是 FP8 版、tensor parallel 设的 8。8 卡起步,就是旗舰版官方的最低示范。轻量版 Hy4 flash 的总参数小一个量级,社区已经把它压进了单张消费级显卡。先搞清楚自己要跑哪个版本、手里有多少显存,才是这道门槛真正卡人的地方。小红书知乎
旗舰 Hy4:个人机器基本无缘,先认清数字
Hy4 正式版 11 月 4 日发布,随着模型能力的再次全面跃升,Hy 首次跻身最强开源模型之列。这次开放了模型权重:正式版、FP8 量化版和预训练 Base 版。按参数量折算,BF16 版本是 1.5TB 级的体量。知乎小红书
FP8 版单个文件就重到七百多 GB,个人部署基本无缘。开发者“银龙聊AI”翻完官方 README 后算过这笔账:FP8 光权重就七百多 GB,8 张卡平摊每张一百 GB 出头,再给 KV cache 留点地方,80G 的卡我估计塞不下,得上显存更大的卡或者多机。他也明确说明这属于个人估算,官方没写具体卡型。真要用旗舰能力,现实路径是调 API:作为对比,同系列的 Hy4 API 分别是 6 元、18 元和 0.3 元(命中缓存)每百万词元。输入输出单价约是 flash 的 12 倍和 9 倍。按这位开发者的观察,开源消息发布当天 Together AI 已经官宣可以直接调用 Hy4,多一个平台,意味着后续价格未必由一家说了算。知乎知乎
Hy4 flash:个人能上手的是它,12B 激活是关键
如果说旗舰版是给企业的,Hy4 flash 才是个人开发者的入口。腾讯混元 11 月 16 日推出 Hy4 flash,先只给了 API;11 月 18 日,instruct、FP8 和 base 三个版本的权重都放上了 Hugging Face、ModelScope 和 GitCode。魔搭社区确认其总参数 224B,其中包含 64B Engram 参数,每个 token 激活 12B 参数,并提供 1M token 上下文窗口。知乎魔搭社区
真正决定部署成本的是架构里的几处“省”。224B 总参数里约 64B 是一张 Engram n-gram 哈希查找表,这部分不参与矩阵乘,理论上能放到更慢、更便宜的存储上。也就是说它可以不常驻显存。工程侧的几处改动则把 KV cache 压到 Hy4 的 1/6。配套的 DFly2 草稿模型直接复用 Hy4 本体的 KV cache,投机解码的开销不随上下文变长而膨胀。总参数听着吓人,实际每步算的只有 12B,这才是它能落到消费级硬件上的原因。知乎PChome知乎
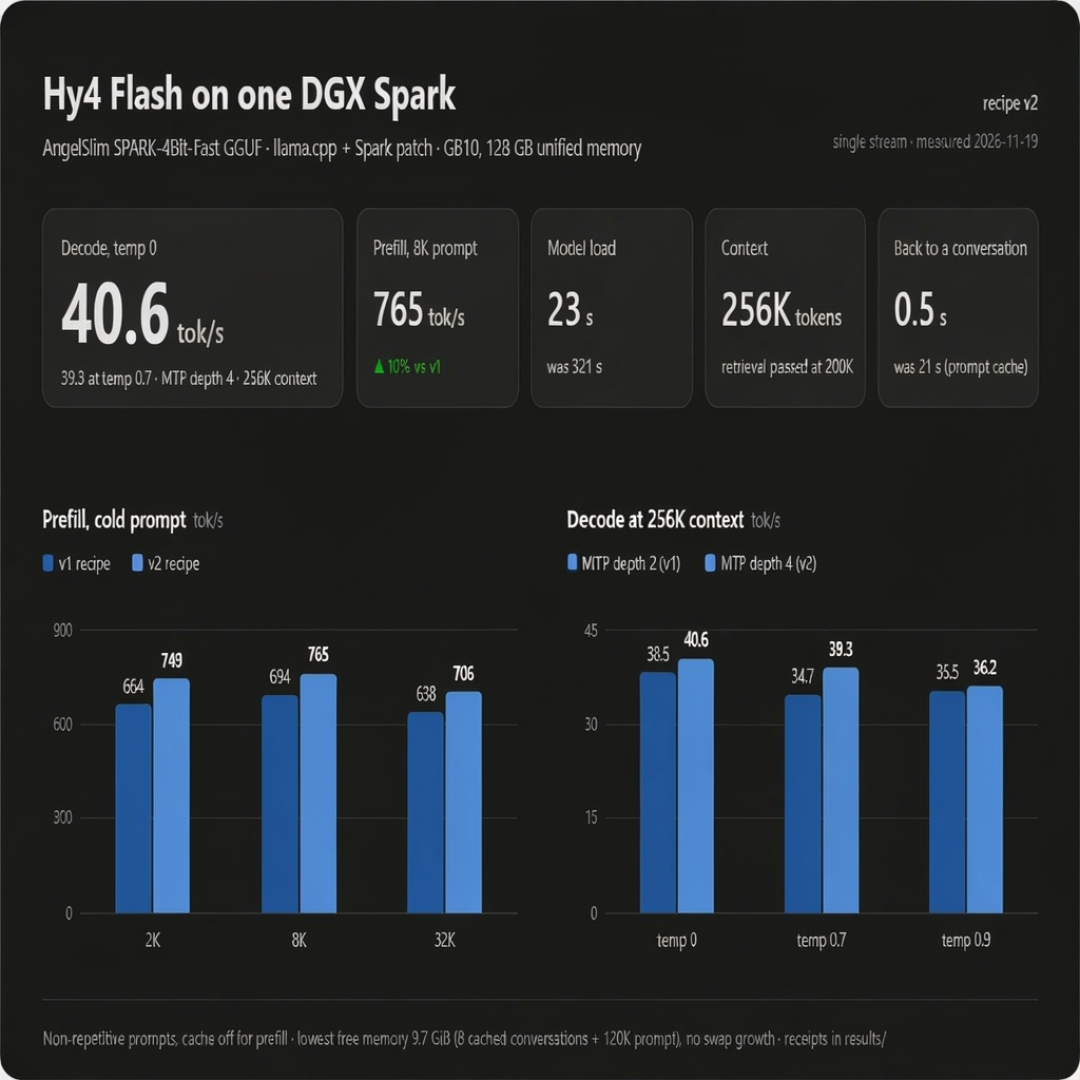
社区已经给出了可验证的样本。博主“折腾 AI 的 Leo”用一台 DGX Spark(GB10 芯片、128GB 统一内存)实测:把约 62GB 的 Engram 表放在 SSD 上按需读取后,模型加载从 321 秒降到 23 秒,GPU 利用率 96%,256K 上下文下解码 40.6 tok/s。他称这台设备六万元左右。腾讯自家的量化工具包 AngelSlim 也提供了 Hy4 flash 的 GGUF 量化版本,并且支持了 128GB 设备配套部署方案。GitHub 项目 Project Maya 的开发者在自有 4×RTX 3090 加 64GB 内存的机器上做出了两档路径:单卡 24GB 配 NVMe 流式加载跑 IQ2 量化,可在完整 262K 上下文加视觉输入下达到 54-68 tok/s 解码速度;四卡 Q3_K 全量载入显存则飙升至 176-251 tok/s,处理一张 1080p 图像约 0.7-0.8 秒。需要提醒的是,官方称 4-bit 量化加自研推理栈下解码超过 150 tokens/s,这是腾讯自己推理栈上的数,分析者也提醒别当成通用部署目标。小红书魔搭社区小红书知乎
本地跑还是调 API:先算这笔账
能力上,flash 的定位是“够用干活”,不是顶配。WorkIndex 评测里 Hy4 flash 得 42.1 分,略高于 Hy4 preview 的 39.7,但低于旗舰 Hy4 的 51.4。魔搭社区
在 85 名用户、27 类共 259 个日常任务的盲测中,它的满意度 2.79/4,接近 Claude Haiku 5.5 的 2.81,端到端完成时间中位数 6.7 分钟,单任务成本 0.26 元。价格和热度站在同一边:每百万词元输入 0.5 元、输出 2 元、命中缓存 0.02 元。腾讯混元披露,它上线首日 Token 调用量突破 50 万亿,创下混元系列模型首日新高,还登上了 OpenRouter LLM 日榜第一。所以决策线其实很朴素:只是偶尔写代码、处理文档,flash 一次任务两三毛钱的 API 远比买卡划算;值得认真折腾本地版的,是数据敏感不愿出云的、靠长上下文 Agent 高频跑任务压成本的,以及手里本来就有多卡工作站的。预算的起点并不苛刻——Project Maya 主仓库支持从 8GB 显卡起的多档 Maya 量化。单张 24GB 显卡加 64GB 内存即可跑通量化版。魔搭社区知乎财经涂鸦小红书小红书
但微调是另一回事:官方 ms-swift 指引对 flash 的 LoRA 或全参数训练都建议至少使用 4 台机器、共 32 张 GPU,每张 GPU 显存不低于 96 GB,每台机器 CPU 内存不低于 2 TB。770B 旗舰的微调自然更不必提。魔搭社区
商用之前,把许可证读一遍
最后是一个容易踩坑的点:这次开源不是 Apache 2.0。开发者核对 Hugging Face 上的 LICENSE 文件时注意到,第一行写的是 Tencent Hy License 1.0,下面还特意补了一句 This License is not the Apache License。Hy4 和 Hy4 flash 采用 Tencent Hy License 1.0,对于提供通用远程模型推理或微调服务的 MaaS 业务,符合特定条件就得取得腾讯单独的书面授权。知乎知乎
协议正文基本照 Apache 2.0 修改,多出来的门槛集中在两处:公司全球 12 个月营收超过 5000 万美元(不管这钱是不是靠 Hy4 赚的),或者产品某个月的月活超过 1 亿。拿模型做自己终端产品、纯内部使用的,按开发者对协议条款的解读不受这条限制。对个人开发者来说“允许商用”成立,只是别再按 Apache 的习惯默认随便用。知乎
还有一点值得放进预期里:对比分析显示,正式版 Hy4 相对 preview 的改动主要在推测编码换成了 5 层 DFly2,10B 参数的 MTP 模块正式版换成 3.3B 的 DFly2,然后视觉加了 1.23B ViT。官方内部评测里幻觉率从 preview 的 15.76% 降到 5.45%,属内部口径。开源补齐的是可部署性和价格竞争,不是能力排名——这也是为什么值得个人本地跑的,恰好是 flash 而不是旗舰。知乎知乎
当前文章无评论,是时候发表评论了