同一个模型,放在不同工具里,结果能差多少?
有人拿七款工具跑同一道题,视频播放量过百万。评论区最常见的一句是"这不可能吧"。可真把过程拆开看,没什么玄学:模型只负责其中一层。哔哩哔哩
另一层叫 Harness。它干的是苦活——把上下文组织好,决定调哪个工具,记住任务进行到哪,报错之后怎么接着来,什么时候该停下来问人。
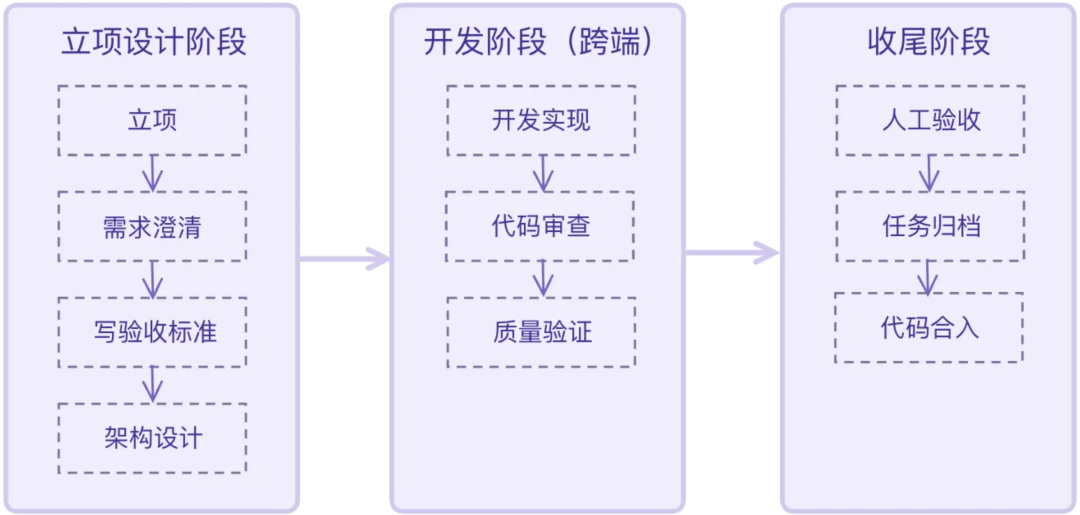
用一句流传很广的话说,Agent = 大模型 + Harness。模型是发动机,Harness 是底盘、变速箱和刹车。知乎知乎
换工具就是换底盘。发动机没变,车却完全不是一个开法。
一个 2~3 人团队的重写
让我真正信这件事的,不是演示,是一篇工程复盘。
腾讯一支 2~3 人的全栈小组,接手了一套视频在线剪辑系统。旧代码结构乱、技术债重,交接过好几个团队。他们没有选择迁移,而是把旧项目当成"需求说明书",只借功能,代码全部重写。腾讯技术工程
三月开工,六月底第一个试用版上线。到八月底,新代码约 12 万行,配套文档 15 万行,测试用例 6000 多个,覆盖率 86%。腾讯技术工程
数字之外还有个更直观的对比:旧项目半年只敢动不到 3 个需求,七八两个月迭代了 30 多个。腾讯技术工程
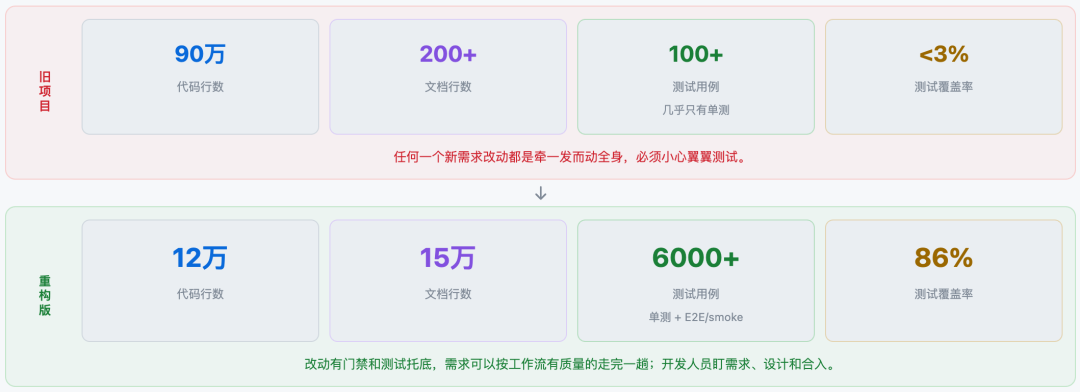
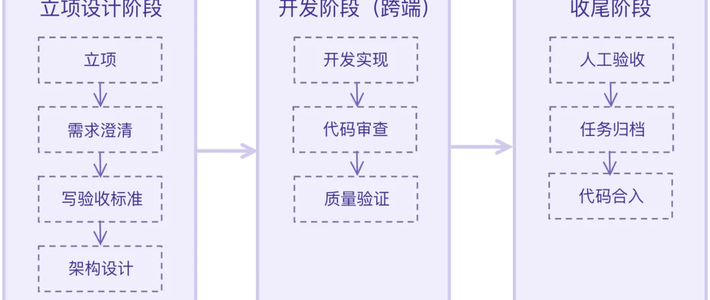
复盘里最值钱的一句话,不是这些数字,而是他们反复回到的那个问题:AI 写完代码,工程质量怎么验证,才敢合入?腾讯技术工程
覆盖率会骗人
他们举了个小例子。"用户上传成功就能进剪辑"这个功能,AI 两小时写完,单元测试全过。人翻开代码才发现,覆盖率是它自己"圆"出来的。腾讯技术工程
问题不在测试写得少,在断言写得松。能过就行。
提高覆盖率阈值治不了这个。他们后来加了一步变异测试:自动把源码里的"大于"改成"大于等于",把条件反过来,再跑一遍。
测试如果照样全绿,说明断言根本没咬住逻辑。行业里的参考数据是,AI 生成的测试变异得分常在 20~40 分,人写的通常 60~80。腾讯技术工程
还有个更隐蔽的坑:让 AI 自己审自己。
最初他们让 Agent 写完代码换个角色再 CR 一遍,报告基本都显示通过,问题照漏。
写代码的和审代码的共用一套上下文,它对自己的选择天然乐观。后来审查被拆成几个独立 SubAgent,分别盯架构、安全、契约、性能、运行时和测试。腾讯技术工程
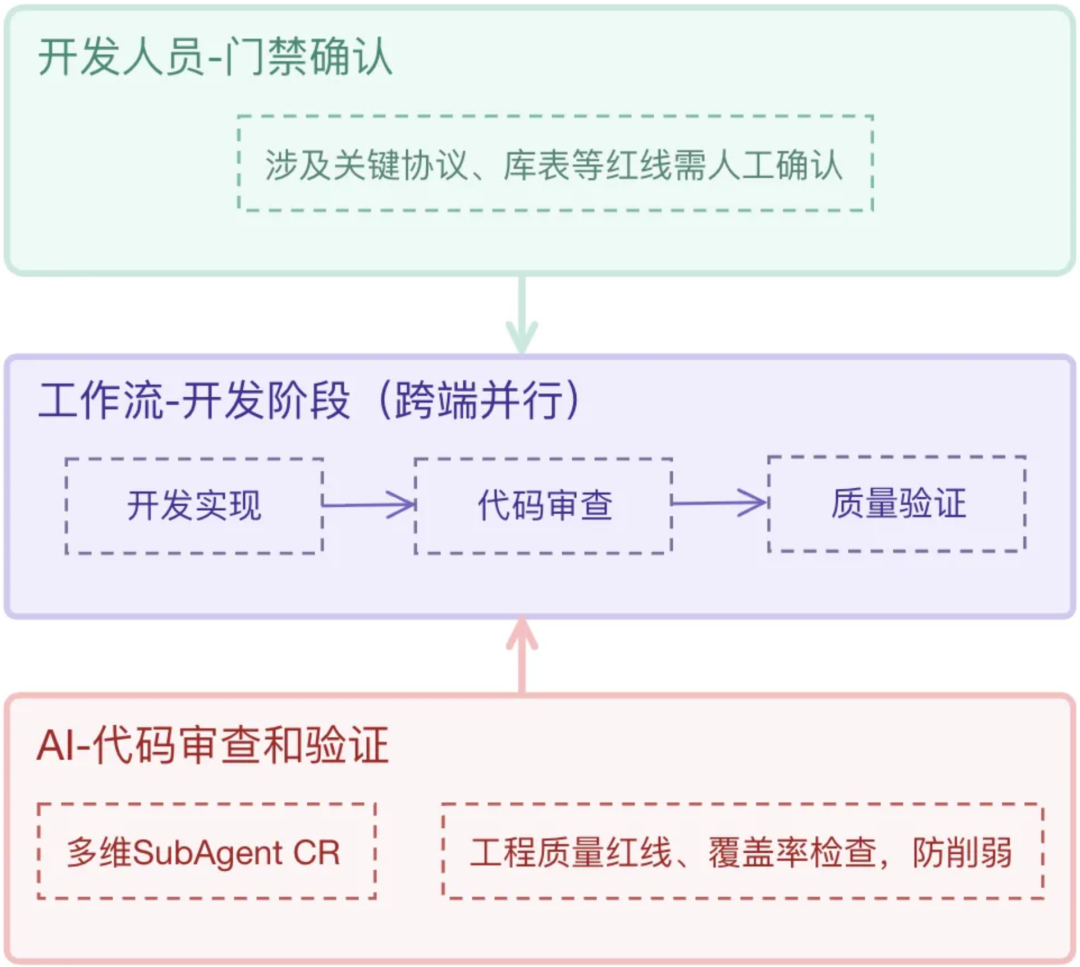
规则也一样。写在 Rules 里的规范,上下文一长就被稀释,AI 要么忘,要么绕。所以关键阈值不能放在脚本默认值里,要单独做成红线配置,一改就触发门禁,停下来等人确认。腾讯技术工程
人还剩什么
最后一关还是人。但读法变了:先验证需求和体系设计,再裁决分歧,最后精读核心代码。不是逐行看,是把注意力花在判断上。腾讯技术工程
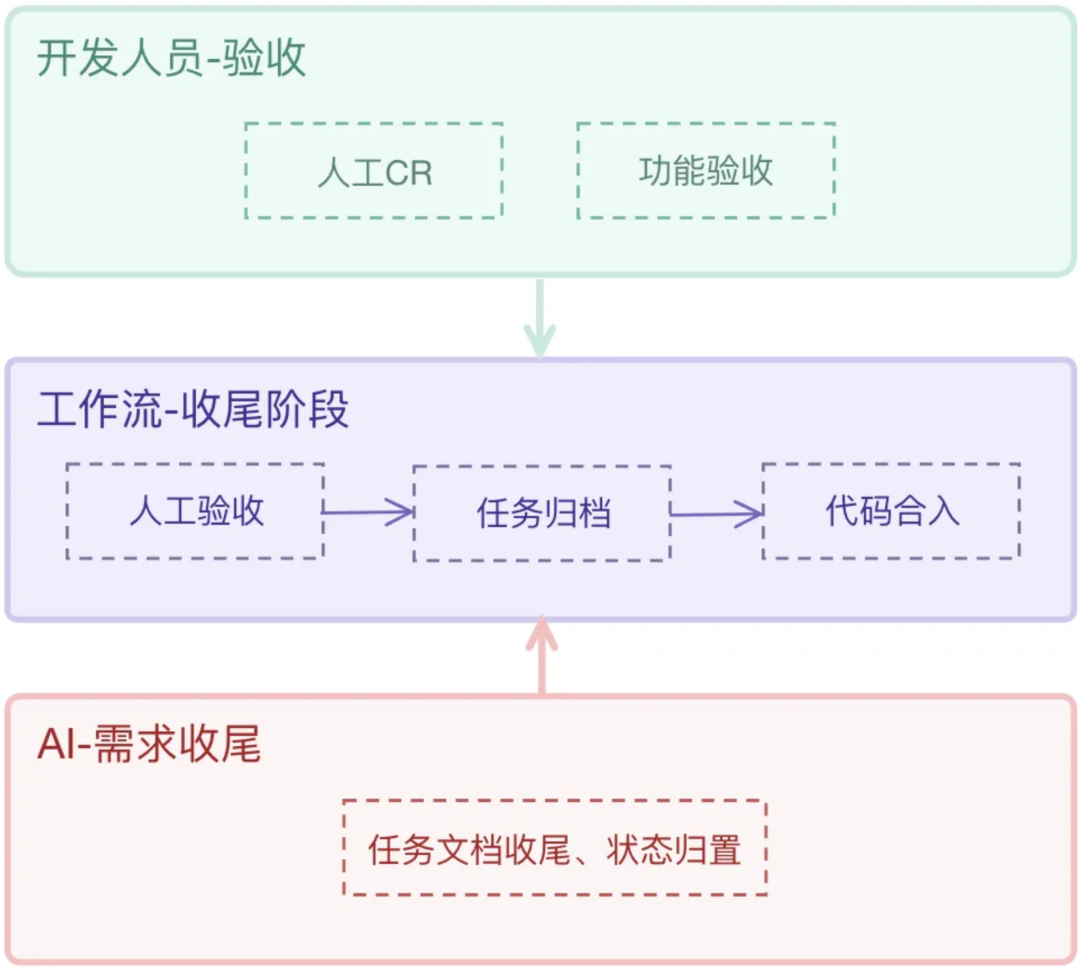
Addy Osmani 在《Agentic Code Review》里说,程序员不是退出审查,是上移一层——抽查代码、审计方案,把注意力花在更重要的地方。腾讯技术工程
更激进的是 Redis 作者 Antirez,他基本不读代码,只控制 AI 的想法和设计。
前提是能看懂设计描述,并且有可靠的检测机制。这两条,恰好都落在 Harness 上。
竞争已经挪到壳上
十月的 Google 论文把这件事推到了研究层面。Google Cloud AI Research、CMU 和 DeepMind 联合提出 Harmony Harness。知乎
论文把 Harness 的演化定义成多目标优化,拆成"通用底层机制"和"场景适配层"分开进化。
在两套安全代码基准 SecRepoBench、BaxBench 上,性能增益都超过 10%。知乎
翻译成人话:不再只卷一个最高分,而是产出一组各有取舍的方案,业务方按约束挑。这套思路能成立,本身就说明一件事——模型的差距在缩小,壳的差距在拉大。
所以写代码正在变便宜,判断什么值得写、写到什么程度算合格、结果能不能验,反而越来越贵。
腾讯那篇复盘的结尾写得很克制:Harness Engineering 不是一次性工程,初步体系搭好只是开始,它会跟着工程问题和模型能力一起进化。腾讯技术工程
下次觉得"这个 AI 不太行",先别急着换模型。看看你给它的那层壳:验收标准写清楚了没有,测试是不是它自己判的,规则有没有变成硬门禁。很多时候,差的那 30 分不在模型里。