

8B从15G压到2G,智商掉多少?量化档位怎么选
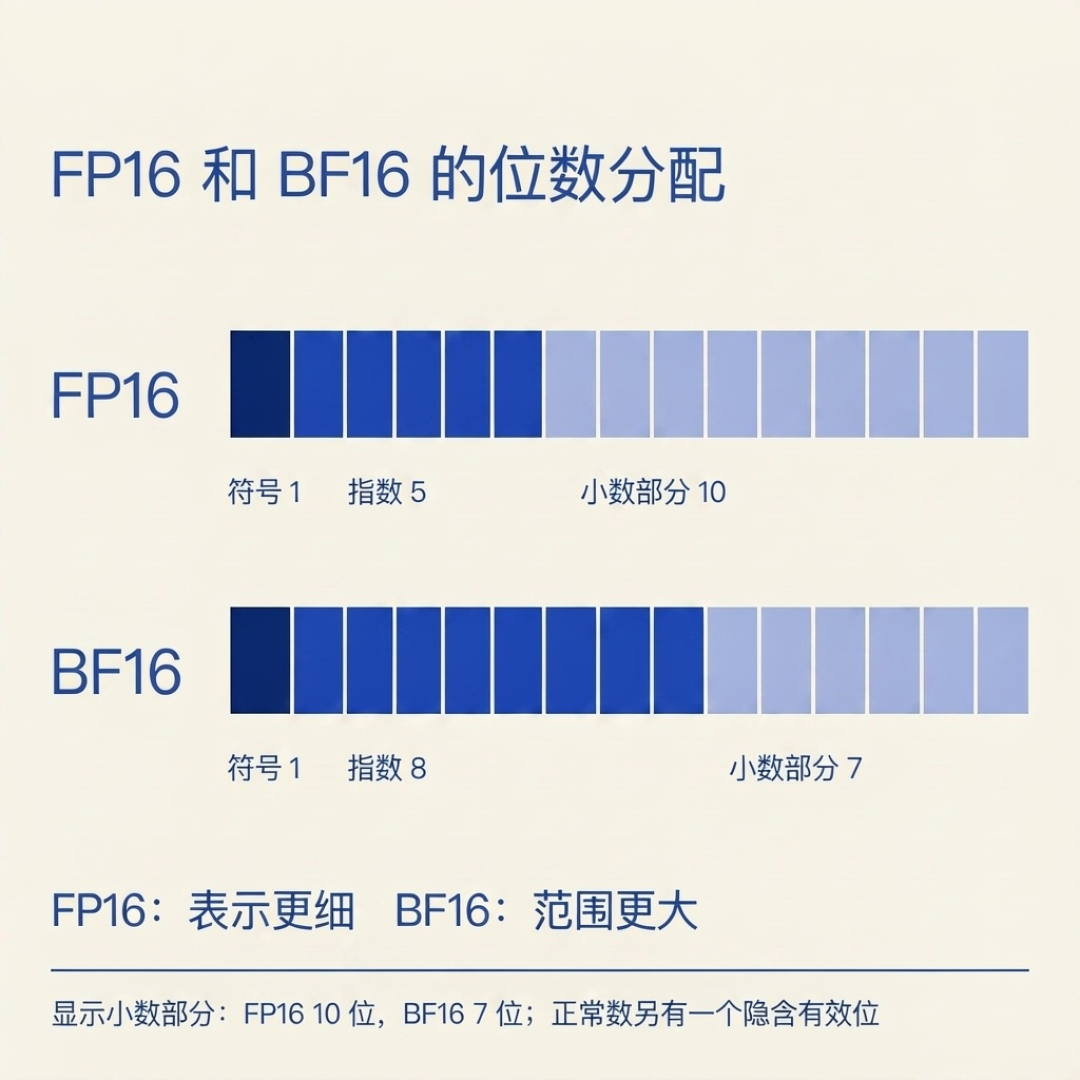
打开模型下载页,同一个 8B 能摆出十几个文件:F16、Q8_0、Q6_K、Q4_K_M、IQ4_XS、Q3_K_S、IQ1_S。名字越冷门体积越小,小到一个 8B 能从 15GB 压进不到 2GB。知乎专栏
省下的那几个 G,是从哪儿抠的?
悬崖不在 Q4,在 Q2
llama.cpp 官方困惑度榜上,LLaMA3 8B 的 FP16 是 6.233,Q8_0 是 6.234,差 0.001,而这把尺子的统计误差是 ±0.038。等于说,Q8_0 和原版分不出彼此。知乎专栏
再往下,Q4 以上几乎察觉不到退化,PPL 从 6.23 爬到 6.41;Q3 开始钝;Q2 大幅劣化;IQ1 直接飙进 25–60,字还连着,意思已经散了。知乎专栏
Q8 凭什么无损?llama.cpp 里的 Q8_0 是 W8A16——只压权重,不动激活。softmax、LayerNorm、残差流全在原精度上跑,噪声只从权重矩阵乘法这一个口子进来。FP16 的相对精度约 0.1%,Q8_0 约 0.4%,同一档;Q4 是 6.25%,高出一个数量级。知乎专栏
快 38%,只在生成时快
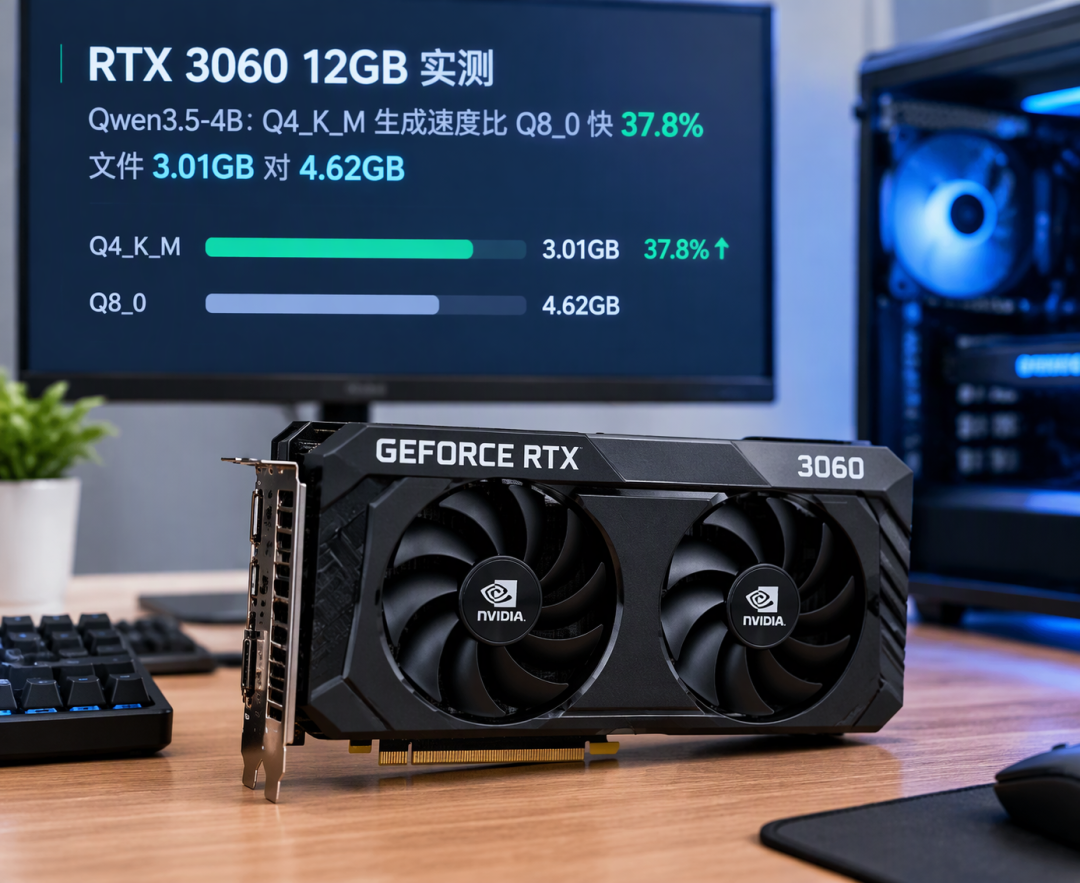
11 月 21 日有人拿一张 RTX 3060 12GB 实测 Qwen3.5-4B,同模型同机器,所有层卸载到 GPU,开 Flash Attention,KV 走 FP16:
Q4_K_M:短上下文 88.33 tok/s,4K 深度 85.31,16K 77.43,文件 3.01GB
Q8_0:64.11 / 62.47 / 58.06,文件 4.62GB
生成快 37.8%。可同一台机器测输入处理(512 token 提示词),Q8_0 约 3635 tok/s,Q4_K_M 约 3384——压得狠的那个反而慢。知乎专栏
这不矛盾。生成是一个字一个字往外吐,卡在显存带宽,权重小就快;读入是一大批 token 并行算,卡在算力,4-bit 权重要先解码回 16-bit 才进内核,多一道手续。知乎专栏
所以长对话、长输出,Q4 香;喂大段文档只要一句结论的活(RAG、摘要、分类),这点加速会被吃掉一块。
模型越大,越经得住压
Ouyang 等人在 1500 多个量化 checkpoint 上拟合出一条关系:量化损失与参数量的 0.226 次方成反比。翻译成人话,参数量翻十倍,退化少约四成。知乎专栏
于是有个反常识的结论:显存固定时,大模型压狠一点,通常打得过小模型用高精度。多个独立来源对上了——70B 的 4-bit 只吃 42GB,持续压过同显存的小模型全精度版本;70B IQ1_M 的 MMLU 是 65.21%,跟 8B FP16 的 65.20% 打平。知乎专栏
但这条线有尽头。同一个 70B 压到 IQ1_S,掉至 61.18%,参数优势被精度损失吃干净。而且掉分不均匀:多选知识题最不敏感,指令跟随和幻觉判别退化得明显更多。Llama3 8B 从 FP16 到 4-bit,Minerva MATH 从 37.5% 掉到 33.7%,3-bit 直接做不完。知乎专栏
写代码、跟复杂指令、算数,都比闲聊该保守一档。
省下的显存,KV cache 会拿走
最容易翻车的一处。Qwen2.5 32B 的 Q4_K_M 权重 18.30GB,塞进 24GB 卡看着宽裕;配上 8K 上下文,总占用 24.10GB,比卡还多。知乎专栏
因为 KV cache 跟参数量只有弱相关,真正决定它的是层数、KV 头数和头维度。Gemma 2 9B 在 128K 下 KV 要 22.55GB,比 32B 的全部权重还贵;Qwen2.5 7B 和 Llama3.1 8B 参数量差不多,前者 4 个 KV 头、后者 8 个,128K 下 KV 是 7.52GB 对 17.18GB,差一倍多。只看"7B""8B"这个标签选模型,就栽在这儿。知乎专栏
好在 KV 精度是另一个独立开关(llama.cpp 里是 `–cache-type-k q8_0` 这类参数),也是收益最大的旋钮:70B 在 128K 下,KV 从 FP16 降到 Q8_0,占用从 90.65GB 掉到 69.17GB,权重一个字节没动。知乎专栏
长上下文场景,先降 KV,再降权重。
不是所有 Q4 都长一个样
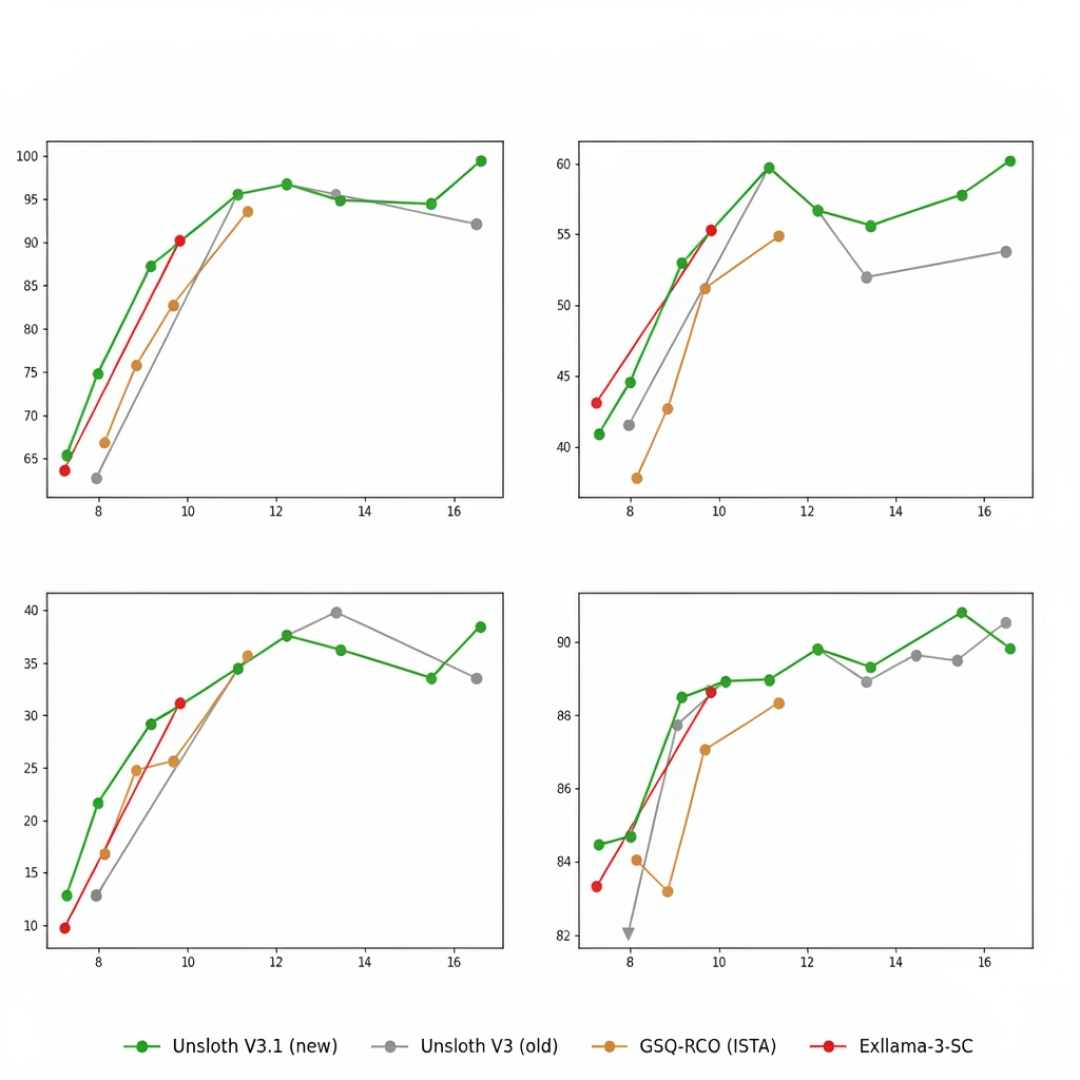
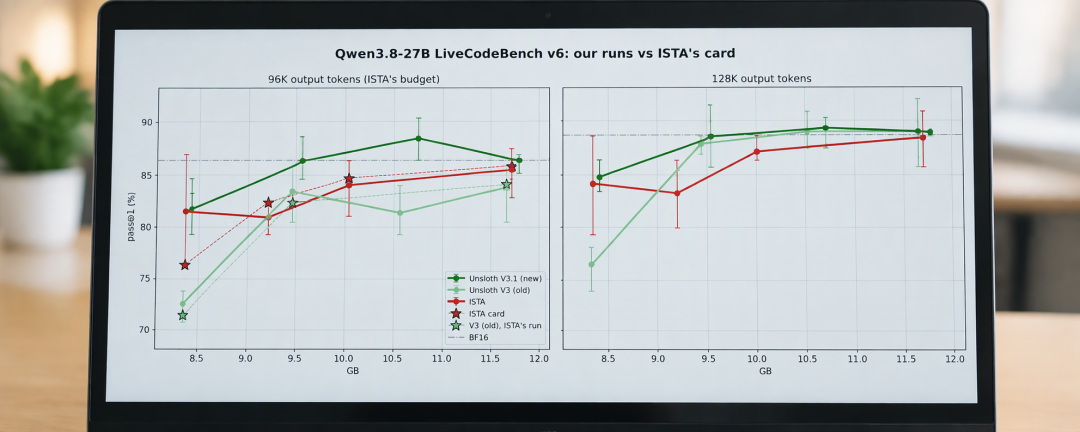
动态量化已经成主流。Unsloth 11 月 13 日发的 Dynamic V3.1,在 Terminal Bench、DeepSWE 上同体积准确率高 5–10%;Qwen3.8-27B 的 4-bit 版能在 16–19GB 显存的机器上跑起来(RTX 5080、4090,或 24GB 内存的 Mac)。思路很朴素:敏感层多给几 bit,不敏感的往死里压。llama.cpp 的 Q4_K_M 里那个 M 是 Medium 预设,本来就让部分张量走 Q5_K/Q6_K,平均 4.5 bit 每权重——所以下载页的真实体积,永远比"参数量 × 0.5 字节"大。知乎专栏知乎专栏
极端那头也有惊喜。11 月 21 日一份九款端侧小模型横评,机器是 15.8GB 内存、没独显的 i5-11320H 轻薄本:1.89GB 的三值量化 Ternary-Bonsai-2 4B 在抽取、应用题、写作三组全拿满分,综合 97.5 夺冠,把 5.09GB 的 Gemma 4 E2B 甩在身后。但同一份榜上,0.25GB 的 1-bit Bonsai 1.7B 和 0.39GB 的 MNN Pocket 0.3B 跑得飞快、中文写得也像样,遇到多步小学应用题双双 0 分。哔哩哔哩
规律没变:模型本来就不大的时候,别再压了。
挑档位的顺序
先算三笔显存——权重、KV cache、运行时开销,别只盯着权重看。
装得下 Q8 就别降。12GB 卡跑 4B 这种组合,那 38% 的生成提速换不回任务上的稳。
装不下就往大模型走:27B/32B 的 Q4 档动态量化,通常比 8B 的 Q8 有用。
IQ2 以下只在"根本跑不动"时启用,且优先给大模型。
要长上下文,先降 KV 精度,权重留着。
当前文章无评论,是时候发表评论了