

"我打算本地部署一个大模型,从此实现token自由。"这句话你在评论区大概见过几十遍。一条播放量一百七十多万的知乎回答把它按在地上摩擦:“你token是自由了,显存、算力、电费、维护时间全跑飞了。能唠嗑,不代表能干活。”
掏钱之前先想清楚一件事:你到底要它干什么活。让它陪你聊天,和让它替你干活,是两回事,答案也完全不一样。
卡住你的不是显卡价格,是显存。 有人花三千块买了张16G显存的卡,兴冲冲加载32B模型,点了加载、等两分钟,屏幕上弹出一行显存不足。重装三遍环境,折腾一整个周末,最后才想明白:16G根本塞不下32B,白花三千只能跑个7B。真正能救场的是MoE架构,像35B-A3B这种,实际激活的参数只有3~6B,靠把一部分权重卸载到内存,16G显存也能跑到每秒三十到四十个token。买卡之前先问模型:你这活儿,内存和显存吃不吃得下。知乎知乎哔哩哔哩
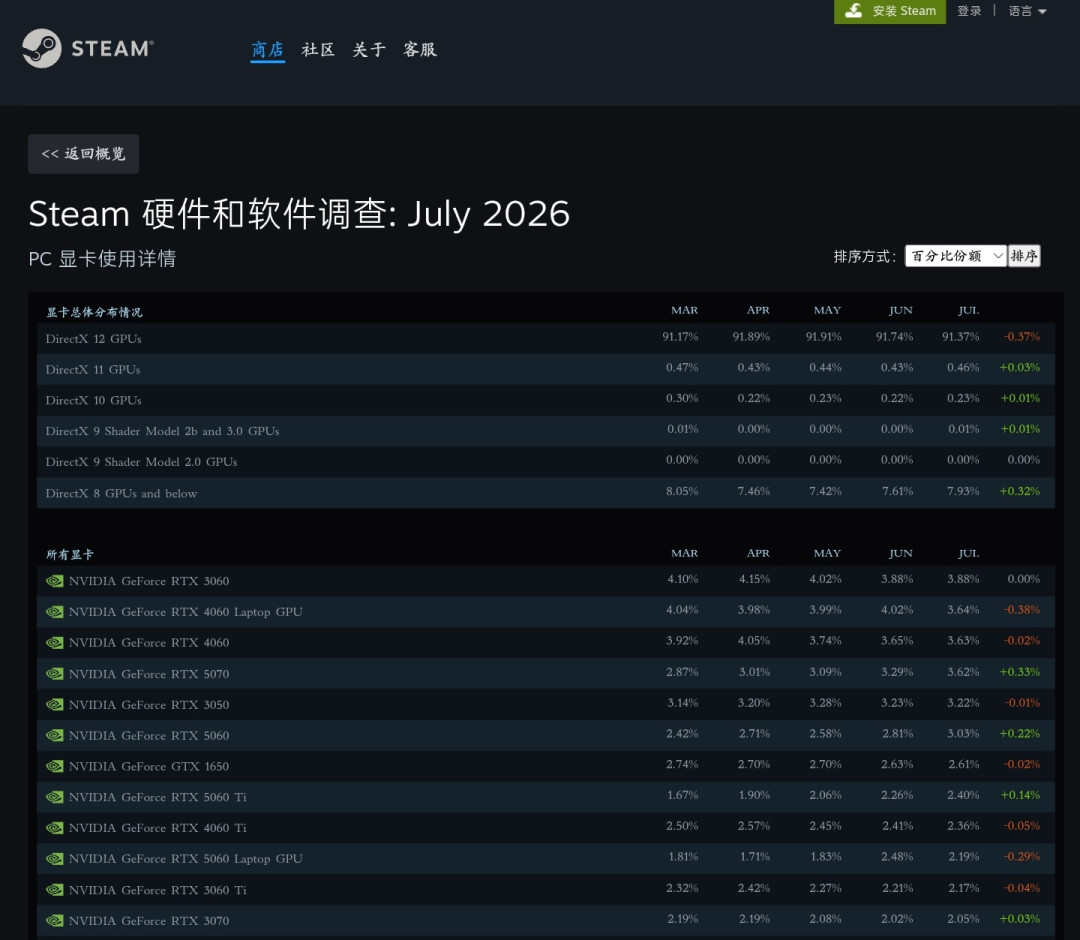
哪些活,本地是真的香。 最硬的刚需是那些见不得光的活。评论里有句话很实在:“我确实要跑一些线上模型不肯给我跑的东西。” 再算上"法规和领导有一堆破要求",凡涉及隐私资料、公司规定的场景,只有本机不会把你的文件往外传,断网照样能用。知乎
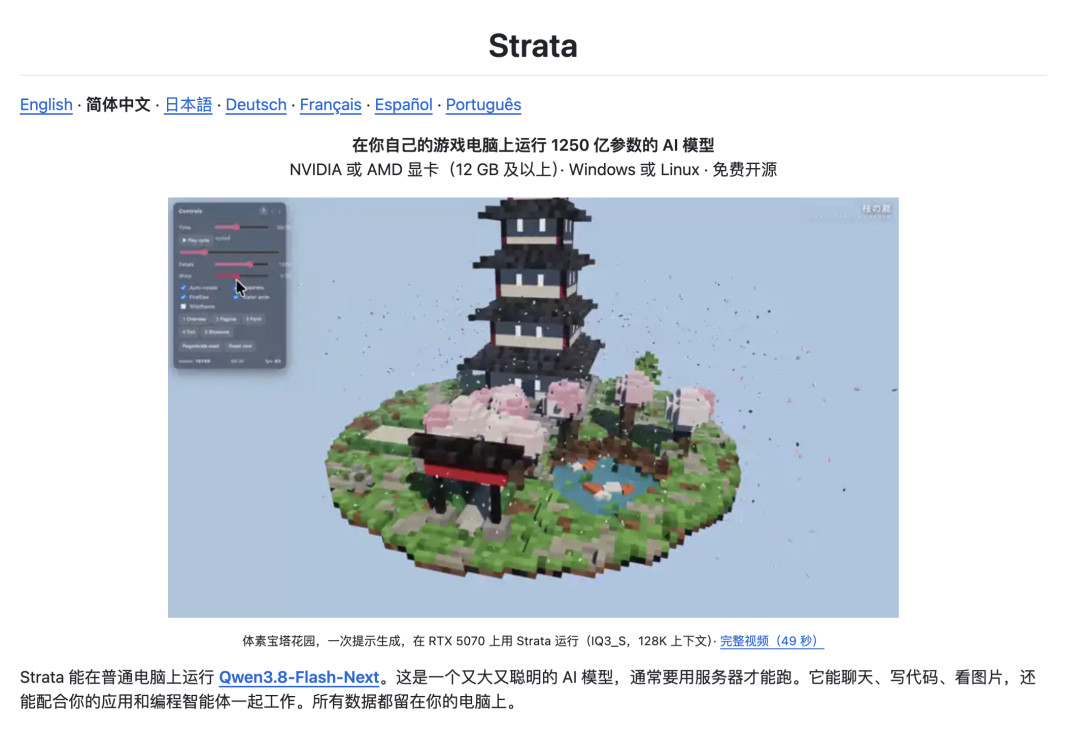
再往下是一堆高频小活,翻译、润色,或者改个格式、来一句摘要,几十秒一次,不用排队,也不用每月交订阅费。本地生图现在也真能打,像Qwen-Image 2.1这类开源模型,透明底图、服装拆分、封面抠字都拿得起来,8G显存就够,2070两分钟一张、5090二十秒一张,公开评分还反超了一些闭源旗舰。
哪些活,本地大概率翻车。 文档一多就开始漏,总结一份还行,接着来第二份第三份就不敢信了。你公司的制度、合同、技术文档,模型压根没读过,让它查个差旅标准,它能给你编出幻觉来。最怕的是连续干活:查数据、分析、生成报告、发送结果,一条龙里中间一断,后面全乱。至于为了跑120B去配一台二三十万的机器,效果还不如随手调用的云端API。能跑、能干活、能干活干得漂亮,是三道不同的坎。知乎
装之前,先算三笔账。 硬件账最好算:两张V100凑32G显存,两千多就能跑一部分32B;可你要做视频生成,门槛直接跳到32G显存起步。
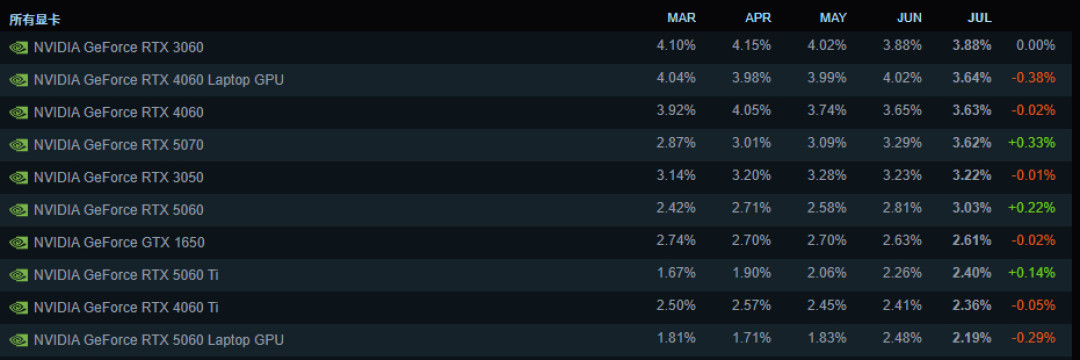
隐性账没写进价格:电费是明面上的,散热降频、装环境的时间、坏了没人修才是暗地里的,每天都在扣。用量账看你是什么人:轻度使用、对隐私敏感的人,本地确实划算;重度用户、非要最新最强模型的,老老实实订API,别为了一句"以后token要涨价"的焦虑,提前囤一台自己伺候不动的机器。
最后对号入座。 如果你的活是隐私资料、断网可用、日常小修小补,这波本地部署不亏,显卡钱半年就回本;可你指望它读完公司十年文档、连着跑完整条工作流,它现在还不够格,这钱先别急着掏。所谓token自由,前提是先有一台真能干活的机器,而不是先点亮一块新显卡。
当前文章无评论,是时候发表评论了