























21
26
托瓦兹用AI查内核:3个13年前的bug露了出来
2026-10-16 18:55:21
0点赞
0收藏
0评论
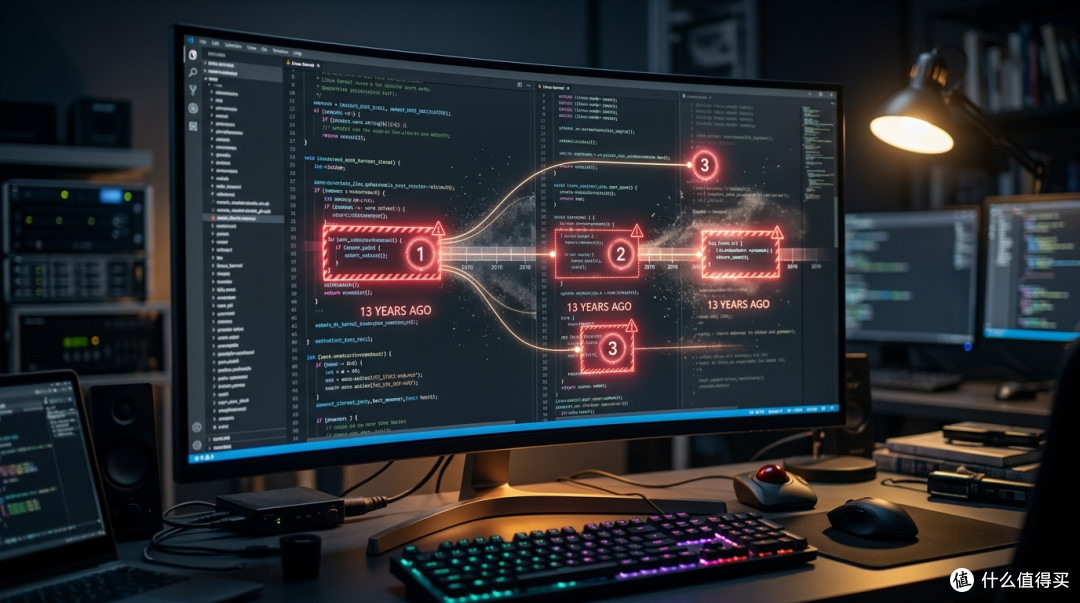
一个 2013 年写进 Linux 的库,1734 行,13 年里没人动过。最近一轮"只是让代码好读一点"的重构,从里面翻出了三个 bug。
三个 bug 藏在 2013 年的第一版里
10 月 12 日,Phoronix 的 Michael Larabel 转述了托瓦兹在内核邮件列表里的一段说明:他用 LLM 工具辅助,把内核里的 assoc_array 代码整理了一遍,目标是让它更容易读。
步骤的先后顺序值得留意。在他动手之前,开发者 Nils Ollrogge 已经报了一个 bug,还附上了自己的修复方案。托瓦兹借 LLM 把这批代码重构之后,写了一个跑在用户态的测试桩去验证——测试桩不进入内核,独立跑。它确认了 Ollrogge 报的那个问题,同时另外撞出三个。
这三个 bug 一路回溯到了 assoc_array 第一次进入内核的那笔提交。内核邮件列表的存档里还留着那封邮件:《增加一个通用关联数组实现》,署名 David Howells,日期是 2013 年 7 月 17 日。也就是说,这几处问题在内核树里躺了 13 年,从没有人碰响过。
补丁目前没有合进 master。Phoronix 的判断是,Linux 7.4 的合并窗口是它们最可能的去处。
为什么这段代码 13 年没人碰得动
assoc_array 干的事说穿了很朴素:你给内核一个索引键,它把一个对象指针还给你,一个按名字取东西的容器。
实现方式就不朴素了:索引键被按 4 位一组切开,每一层用这 4 位去选一个 16 叉节点的槽位,节点装满了就往下分叉。中间一串只占一个槽的节点会被 shortcut 直接跳过,省内存也省遍历层级;叶子和指向下一层的指针还能混在同一个节点的槽里,只要键前缀对得上。
它最初是给 keyring 写的。2013 年 7 月 David Howells 那组补丁说得很清楚:把 keyring 的容器换成 assoc_array,是为了大幅提高密钥环的容量,同时让"密钥很多时的查找"变快,顺带也给 FS-Cache 管 cookie 留着可能。那一次提交往 lib/assoc_array.c 里一次加了 1734 行,配套文档又写了 583 行,两个头文件另算。
增删也不是直接改树。插入和删除先生成一个"编辑脚本",把要装的节点提前分配好,再一次性应用——这个设计的好处是应用阶段不会再失败,坏处是读代码的人要在"还没生效"和"已经生效"两个状态之间来回切。被换下来的旧节点和旧对象不会立刻释放,要等一个 RCU 宽限期过去,好让正在读这棵树的线程不受影响。
树自己还会动。一个节点里攒到 17 个对象就要分裂,反过来,某个子树里的对象掉到 16 个以下,它会尝试折叠回一个节点,这个折叠还会一路往根的方向蔓延。指针也有规矩:所有对象指针的最低两位必须是 0,因为那两位被借去标记对象类型了——违反了只有一个 BUG_ON 兜着。
最麻烦的地方,代码自己的文档里写着一句:back pointer 让"同时修改与遍历"变得棘手。每个节点和 shortcut 都存着指向父节点的指针和自己在父节点里的槽位号,非递归遍历靠它往上爬。所以动一个槽位,你得同时在脑子里跟踪父指针、槽位号、层级偏移和 RCU 时序这几样东西。
读的人宁可跳过,因为这里改错一次,未必看得出来。
LLM 干的活很朴素:让代码能被读懂
托瓦兹做的事情本身不大:把几个又大又难读的函数拆开。这是纯粹的重构,不改变行为。
效果却不像看起来那么小。一个 200 行往上、分支嵌套的函数,大多数人的处理方式是跳过,而不是审阅;拆到几十行、名字能说清"这个函数负责哪一段键空间"之后,边界条件和每个分支的输入才变得可以讨论。测试桩也是在这个前提下才写得出来的。
这里有个容易被叙事带偏的点:真正把另外三个 bug 撞出来的是那个用户态测试桩,不是模型自己"审"出了什么。托瓦兹让 LLM 承担的是摊开代码、写测试、跑测试这些体力活,判断依旧在他手上。所以这件事的重点不在于"AI 会找 bug",而在于"读懂 1734 行的成本被压下来了,于是写测试这件事第一次变得划算"。
同一周的性能分支:吞吐 3 倍,时钟周期砍掉七成
另一条线上的动作更直接。10 月 13 日,他在自己的仓库里推了一个分支,名字里带着 llm 后缀,主题是提高页面引用计数的可扩展性。按 LWN 的转述,这组补丁的核心代码、测试程序、漏洞审查、公告文档初稿,都是在他本人指导下由 Claude Code 协作完成的。
他给出的本机数据是这样的:8 个线程并发读同一个文件,读取吞吐从每秒 990 万到 1040 万次,升到 3000 万到 3300 万次;单次读取消耗的内核时钟周期从约 2950 次降到 725 次。负载本身挑得很准:多个核反复去更新同一份页缓存的引用计数,争抢就发生在那里。
两组数字都属于本机实验口径,测试前他关掉了本机的一部分安全防护;补丁也还停在实验分支,没有进主线。
把两件事放在一起看会更清楚:一头是让代码可改(可读性),一头是让改动可信(测试)。少了前者,没人敢动;少了后者,动了也不知道动坏没有。
两个容易看错的地方
第一种说法:AI 已经能自己找内核 bug 了。
这话有一半是对的。没有这轮 LLM 辅助的重构,那个用户态测试桩大概率不会有人去写,那三个 bug 会继续埋着。
但它解释不了一件事:Ollrogge 报的那个 bug 是人先发现的,另外三个是测试桩撞出来的。模型没有运行过代码,也没有为内核语义负过责。
更准确的理解是,LLM 改变的是成本结构——把"读懂这 1734 行"从两天压到一个下午,于是补测试、跑测试从"不划算"变成了"顺手就做"。
第二种说法:内核已经接受 AI 写的代码了。
他确实在用自己的仓库推分支,也确实公开演示了 LLM 辅助的结果,示范效应很强。
但补丁没进 master,性能分支停在实验分支,7.4 合并窗口只是外界的"预计"。内核那几道门槛——人审、测试、回归——一条都没有松。
眼下被验证有效的组合是"人做判断 + LLM 干体力活 + 测试兜底"。把 AI 从"助手"换成"提交者"是另一件事,至少现在没有证据支持。
想在自己项目里复现这套流程,四步
第一步,挑那块谁也不愿打开的文件。老代码里长期没人改的部分,通常也是测试覆盖最薄的部分,两个特征往往指向同一处。
第二步,只做"让它好读"的重构。拆大函数、给中间变量起名、把隐式约定写成注释。这一步别顺手改行为,否则后面出了 bug,说不清是谁引进的。
第三步,补一个能在本地或用户态跑的测试桩。内核这次的抓手就在这里:测试跑在内核外,反而更容易造出边界条件,也更容易反复跑。
第四步,让测试去撞 bug,别让模型去猜 bug。模型可以帮你列出可疑点,但一条 bug 只有被复现、被定位到具体分支,才算数。
这套流程有个前提:你得有能力写出测试。如果那块代码根本没有可运行的环境,你能拿到的只是"更好读"的代码——它仍然有用,但别把它当成找到了问题。
托瓦兹这轮没让 AI 写一行业务逻辑,只让它干了一件最不显眼的事:把代码摊开。你手上大概率也有一段谁都不想打开的文件——你会先用它提速,还是先让它摊开?
作者提示含AI生成内容。作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~







