"学的越晚,学的越少。"这条评论在B站UP主YZ_金鱼的《MiniMax H3终极篇》下面拿了106个赞。底下有人接:“早学苦用功,晚学全自动”,“学慢了就不用学了,因为更好的已经出来了”。哔哩哔哩
看上去是玩梗,实际上是一周多以来AIGC视频圈最真实的集体情绪:10月13日到20日,B站MiniMax H3相关的投稿几乎一天一屏——6G显存三采工作流、16G显存挂机一晚上、导演台V8、零训练RefMod、一张图360°环绕LoRA、Intel量化、3.85倍加速插件。金鱼的"终极篇"拿到3224赞、5675收藏、7.2万播放,评论区1091条。海螺H3这波本地生态,正在把"不用按秒交钱"的叙事推向每一个还在给云端抽卡付账的人。
先把事实底盘摆正:H3不是新模型。7月31日发布、8月3日稀宇科技正式开源权重,官方口径是"通用型全模态生成系统"——统一理解文本、图像、视频、音频,一次前向同时产出画面、音效和语音,生成最高2K分辨率、最长15秒、带原生立体声的视频。新浪微博知乎
开源当天ComfyUI就能用,DesignArena多图生视频榜上它Elo 1355,是榜单内最强开源视频模型(第一名是Seedance 2.5,1400)。新浪微博
8月初博主动过真格:在LibTV上用同一套提示词和角色图、UI图、完整界面图三张素材,让H3和Seedance 2.0各生成一段游戏UI动效,发帖人的结论是"H3的表现甚至盖过了Seedance 2.0"。 8月29日起,通过Comfy还能拿到H3本地商用授权,生成内容归使用者所有、支持微调和LoRA训练。新浪微博新浪微博
真正在10月中旬引爆的,是两周之内被补齐的那批"能用"缺口:10月15日,阿里AIGC团队开源TaoMate-H3-FL2VA,社区很快把它转成3步加速LoRA。DMAD那边把H3蒸馏到4步,作者还在评论区亲自认领:“感谢大佬推广我们的加速LoRA”。知乎哔哩哔哩
Intel下场做了量化,体积砍29%、画质几乎无损。RunningHub线上工作流10月19日更新v1版,作者自测:“基本不损质量,速度再提近一倍”。哔哩哔哩哔哩哔哩
换句话说:8月的问题是"能跑但难用",10月的兴奋是"好像真的可以用了"。兴奋是真的,但"本地=创作自由"这笔账,得拆成三本来对。
第一本账:显存、硬盘和流量——"能跑"的门槛不是显卡名
一位用RTX 5070 Laptop(8G显存+32G内存)跑通全流程的知乎作者写得很诚实:H3是330亿参数的模型,8G卡跑15秒视频"就是这么慢——这是物理极限不是软件问题"。他的实测数字:5秒一条大约8~10分钟,15秒带日语口型、双语字幕、本地质检的全流程约35分钟,成片736×416、24fps。知乎
下载和存储也在账里:他走ModelScope下载量化权重,84.9GB实测15~26MB/s,一个半小时下完。另一位做MV人物替换的作者(RTX 4090 24GB)核对过Ref2VA流程的五个文件仅权重就约40GB,建议SSD预留100GB。他还画了一张从原版MV到分镜遮罩、逐人替换、原帧驱动嘴形、音轨回封再到导出的六步流程图——本地党的真实工作量就藏在这条流水线里:知乎知乎
还有一个新手最容易踩的坑,来自上面那篇8G实录:别上来就下GGUF。H3的隐藏维度是2688,不能被256整除,GGUF标称Q4实际会退化成Q4_0/Q4_1,画质损失比标称大;官方推荐能用cu130就选int8_convrot,其次fp8_scaled。知乎
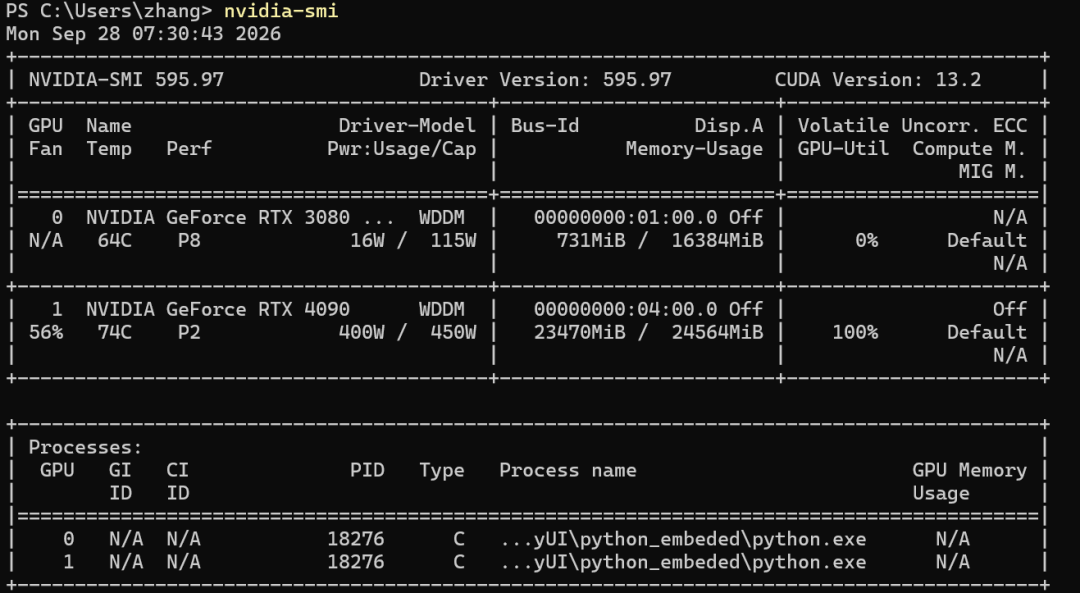
这本账的结论很直接:12G及以下显存,“能跑"和"能用"是两件事。写过双GPU对比测试的知乎作者贴过一张nvidia-smi:同样是ComfyUI里的H3进程,24G卡吃到23470/24564MiB、利用率拉满100%,16G卡上只挂了731MiB、利用率0%——负载全压在能装下的那张卡上。金鱼评论区就有现成的例子:一采0.6二采每一步都要3分钟,5070ti+32g,10秒的视频等了20分钟果断取消了。楼下有人接"我跟你配置一样,10分钟”,同一个工作流、同一个配置,耗时差出一倍,差别全在采数和参数上。哔哩哔哩
第二本账:时间按"分钟"准备,不是按"秒"
云端同样没有"秒出"。一家API网关(apimodels.app,自述利益相关)10月10日~17日对基于H3开放权重的RH Enhanced做了实测:线上768P的中位耗时约5.8分钟,最快不到3分钟、最慢约8.4分钟。官方自测480P 4秒要46~62秒,1080P 4秒要218秒,带6.6秒参考视频的480P请求要346秒。他们给用户的建议原话是:“按分钟准备,不是按秒。” 连10月19日刚把H3接入网页端的云服务商,宣传文案开头打的也是这笔账:“本地显卡跑10秒视频,要等20~40分钟,普通创作者根本扛不住这个试错成本”。知乎新浪微博
所以本地和云端的真实差距不是"快vs慢",而是时间花在哪:云端是提交任务之后去干别的,5到10分钟后回来验收;本地是你坐在电脑前,显存被卸载机制吃满、内存被占住,32G机器"检测到并发加载必炸"。金鱼那位8G作者的建议代表了本地党的活法:先跑5秒打磨,定稿了再上15秒;"16G显存跑一个下午,都跑冒烟了"的,是还没学会把5秒当草稿的。
第三本账:钱——云端的抽卡税vs本地的电费和卡
云端这半边,我前面已经算过(可灵、价格战那几篇)。H3这边的官方定价同样卷:7月底发布时#MiniMaxH3价格仅为同类三分之一#上过讨论,官方给到的口径是2K每秒0.8元。新浪微博
8月开源活动期间LibTV上768P给到约一毛钱一秒、2K两毛。10月17日的官方价格页上,标准版minimax-h3是768P每秒$0.097、2K每秒$0.145,且参考视频要按它自己的时长以同样单价再收一遍。第三方网关的RH Enhanced把价压到768P每秒$0.07、1080P每秒$0.10,参考图、参考视频、驱动音频都不另收费——768P一条10秒片子$0.70,同条件官方列价要$1.28。新浪微博知乎
本地那半边没有明码标价,但每一笔都存在:显卡折旧、85GB级的下载流量、以及最贵的——你坐在35分钟前面的时间。金鱼的线上工作流12秒从10分钟压到6分钟、加速LoRA一天一个版本,意味着今天为本地买的算力,半衰期可能按周算。
对完三本账,给三种人三个答案:
手里已有12G以上显存的台式机、每月出片量稳定:值得认真试。选官方推荐的int8_convrot路线,从5秒片段开始,把"废片自动筛除"(8G作者用本地4B决策模型逐帧质检)学起来,人只看成片。
只有笔记本、8G以下显存:别为H3装机。用RunningHub、仙宫云、autodl这类按小时租的,或者干脆留在云端按秒计费——“autodl的h3真的很好用”,这是评论区做生日贺片的作者的原话。哔哩哔哩
要2K、要超过15秒、要秒级出片:现在三条路都不成立。原生2K只有官方标准版API有,RH Enhanced最高1080P,本地量化版普遍在736P~1080P之间挣扎。这不是软件问题,等下一波量化和蒸馏。
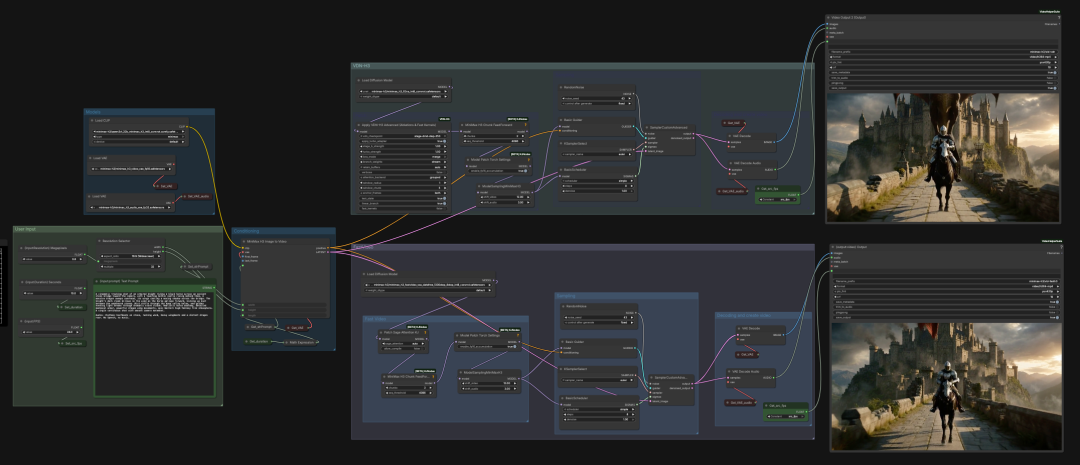
最后留两个继续盯的信号:TaoMate、DMAD这类加速LoRA是否跟进ComfyUI官方模板库(跟进了才算真"全自动")——社区已经有人把VDN-H3和FastH3两套工作流并排搭进了ComfyUI,上排走ATTN-H3高级注意力加Fast Kernel,下排8步直出,一个屏幕就能对比出两条加速路线的差别:
另一个信号是MiniMax自家10月19日晚刚发布的M3.1Flash——此前以匿名身份处理了超过200T Token刷屏的"太空兔",正是它的早期版本。它会不会把开源节奏带到视频模型上。至于"学的越晚学的越少"——这句106个赞的话,反过来读才对:晚学到不用学前摇后晃的工作流,直接用官方6段式Ref2VA提示词和现成整合包。这才是这波里最省学费的姿势。知乎哔哩哔哩