这两年,"本地大模型"这几个字意味着:自己挑卡、自己下 GGUF、自己装 Ollama 或 LM Studio,自己对着显存表掐算。
但 10 月这半个多月,事情开始反过来——
10 月 6 日,有小红书用户在手机淘宝的隐藏私有目录深处,挖出一个叫"NGUserIntent 下一代用户意图理解"的文件夹,里面是一整套端侧大模型文件。配置文件里第一句系统提示词写着:"你是一个淘宝购后场景电商推荐系统的导购专家。"这条笔记拿了 3026 赞、366 条评论。小红书
10 月 16 日晚,搭载 NVIDIA RTX Spark(N1X)芯片的联想 YOGA Pro 15 开售,29999 元起,官方宣称可本地运行"超千亿参数大模型";128GB 顶配 37999 元,同批开售的华硕 ProArt 创 16 上线即售罄。知乎
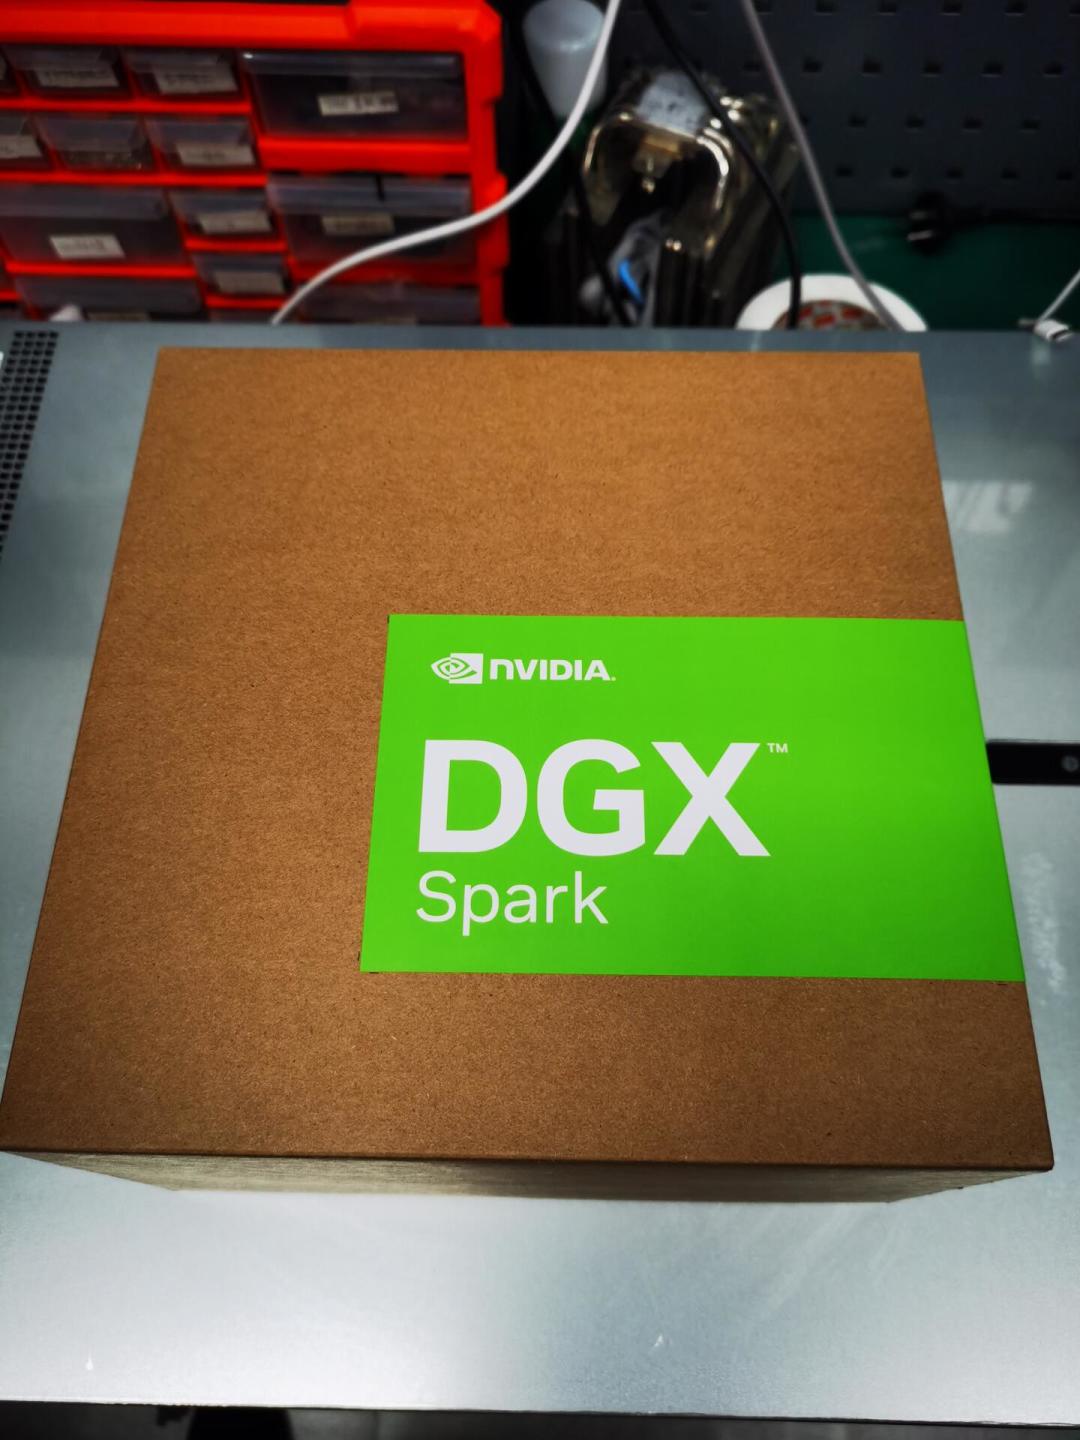
10 月 23 日,DGX Spark 64GB 版将经由宏碁、华硕、戴尔、技嘉、惠普、微星六家 OEM 开售,起售价 4999 美元,官方称可本地运行最高 1000 亿参数模型。微博
也就是说:你还没动手装,"本地大模型"已经先来找你了——藏在 App 里、印在笔记本详情页上、做成小主机在卖。
这篇内容写给一直没装机、原本在观望"要不要在今年入手一台本地 AI 设备"的人。我把这些商品页上关于"本地大模型"的说法逐条拆开,对照官方口径、社区实测和翻车现场,摆进同一张表。付钱之前,先对完三本账:门票、速度、知情权。
先把话说清:每个"本地大模型",口径和实物差在哪
事件(均为 2026 年) | 商品页/宣传的说法 | 实际核到的情况 |
|---|---|---|
淘宝预装模型(10 月 6 日曝光) | 无宣传——静默下载 | 藏在受保护目录,文件管理器看不到,清缓存按普通数据一笔带过;据笔记称约 1GB 存储、调用手机 GPU/NPU 离线推理;笔记口径为 Qwen2-0.5B,而评论区指向的阿里自家 RecGPT-Mobile 论文写的是 Qwen3-0.6B-Quant,连规格口径都对不齐 |
联想 YOGA Pro 15(10 月 16 日开售) | 本地跑"超千亿"、断网可用、零 Token 成本、数据不出门 | 开箱自带的是 35B 本地模型;“千亿"对应"天禧 AI 超能模式”,发售稿明确写"将通过后续 OTA 升级实现";120B 是否 MoE、激活参数多少,各渠道均未披露,未获证实;"断网可用"暂无独立实测 |
DGX Spark 64GB(10 月 23 日开售) | 桌面"AI 超算",最高跑 100B 参数 | 原版 128GB 卖 3999 美元,内存砍半的 64GB 版反而 4999 美元起——贵了 1000 美元;社区已有单机跑 DeepSeek-V4.1-Flash 仅 20~30 tok/s 的自报数字,16 台并联跑 Kimi K3 也只有 38 TPS,被吐槽"就是花活" |
二代豆包手机 NaviX Ultra(9 月 16 日发布,5999 元) | “全球首款 AI 智能体手机” | 注意:检索了微博、知乎多个渠道,均未获证实它在本地跑大模型——它的卖点(替你办事、后台操作)走的是智能体+App 生态路线,且阿里、腾讯、快手系已明确拒绝其自动化操作。把"本地大模型"标签贴给它,是蹭概念 |
小米 AI Cube(8 月 24 日展出) | 本地部署 120B+3B 双模型、快慢系统切换 | 是原型机,没有上市时间、没有售价,三芯片(玄戒 O3/O100/D100)与双模型口径目前全部来自知乎讨论与媒体转述,未见官方产品页 |
更早的铺垫也得算进来:5 月联想 AI 主机 P7 已经在喊"Token 工厂",9 月定价 5999 元的二代豆包手机自称"全球首款 AI 智能体手机",8 月底 2nm 新 Mac mini 把苹果本地推理门槛压到 6999 元。厂商动作密到这份上,说明"本地大模型"正在从发烧友黑话变成货架话术。微博微博
第一本账:门票——三万块买到的不是"更聪明的模型",是"模式"
把价签排一下:6999 元(Mac mini 2nm)→ 5999 元(豆包手机,但它压根不承诺本地模型)→ 29999 元(YOGA Pro 15)→ 4999 美元起(DGX Spark 64GB)。价差最高 5 倍,但溢价买的从来不是模型智商。
为"千亿"付的差价,今天是张期票。 YOGA 官方口径是支持本地运行超千亿参数大模型,但出厂自带的是 35B 本地大模型,"千亿"对应的超能模式要等 OTA 才解锁。就算 OTA 落地,“千亿"是总参数还是激活参数、什么量化精度,官方一个字没给。本地圈早就验证过的"参数量≠智商”,商品页原样复刻了一遍。知乎
DGX Spark 的定价反直觉,但你得看懂为什么。 64GB 版比 128GB 版贵 1000 美元。不是英伟达发昏:128GB 版是 Founders 直销价,64GB 走 OEM 渠道,多出的是渠道利润和整机形态,内存反而少了。而 64GB 意味着"最高 100B"的宣称基本只能在重度量化下够到门槛——DeepSeek-V4.1-Flash 盘上 510GB,社区已经验证过 NVFP4 量化塞不进 128GB 单机,64GB 更不用说。微博
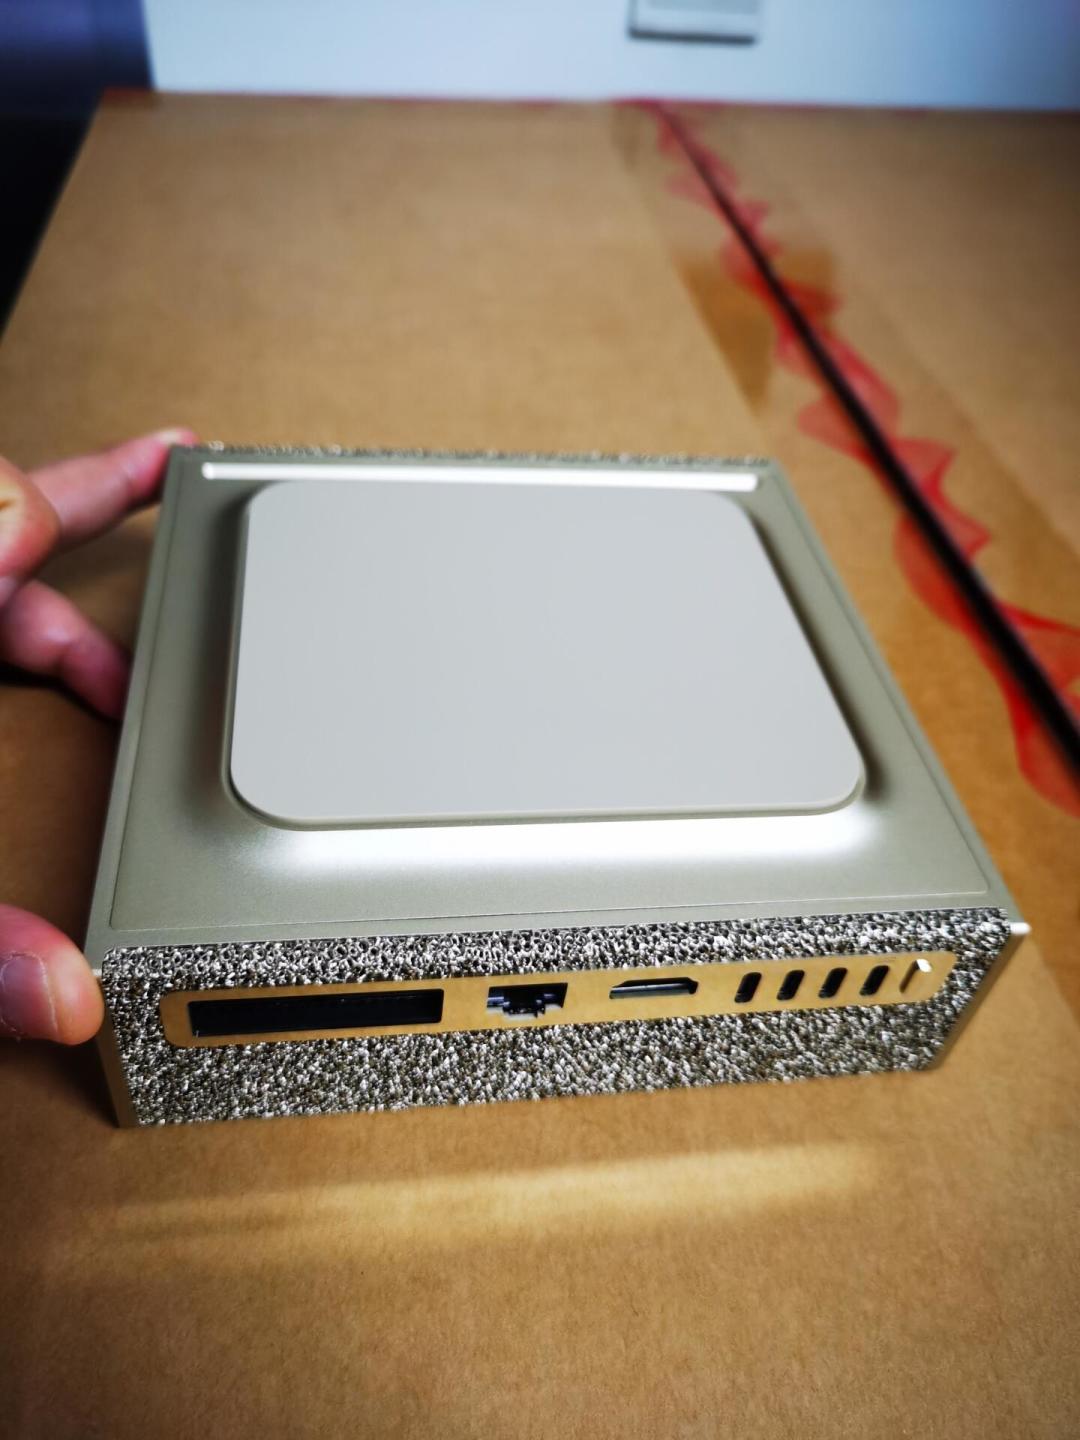
云端没闲着,这是门票账最容易被忽略的一行。 10 月 20 日 MiniMax M3.1 Flash 发布,输出卷到 200+ TPS、价格砍到 1/2。10 月 16 日 Reflection 的 501B 稀疏 MoE 也上了 Ollama,走云端跑、限时免费,不占你的显卡。云端每降一次价,"买三万机器为了省 Token 费"这个故事的兑现窗口就窄一寸。靠本地省钱的人,先看看这个月云的价签。36氪知乎
第二本账:速度——"装得下"和"干得动"是两件事
本地圈这个月最热的实验恰恰在说反面:Strata 引擎让 12GB 显存的游戏卡跑 125B MoE,开发者自报能到 93 tokens/s。微博群里 3090 的实际测试是短问答 67 tok/s,同硬件 llama.cpp 只有 20——虽然自报数字和第三方实测之间也有过分歧(有人只测出 30 多),但方向很明确:三千到八千块的旧卡+开源引擎,速度并不输给三万块的新形态硬件。微博
而 DGX Spark 这边的社区自报是 20~30 tok/s 档:有玩家分享单机跑 DeepSeek V4 Flash 的方案,即便优化过,也只能到 20~30 多 Token 一秒。想要多机并联补算力,还得看背部那几个 QSFP 高速口怎么组网。微博
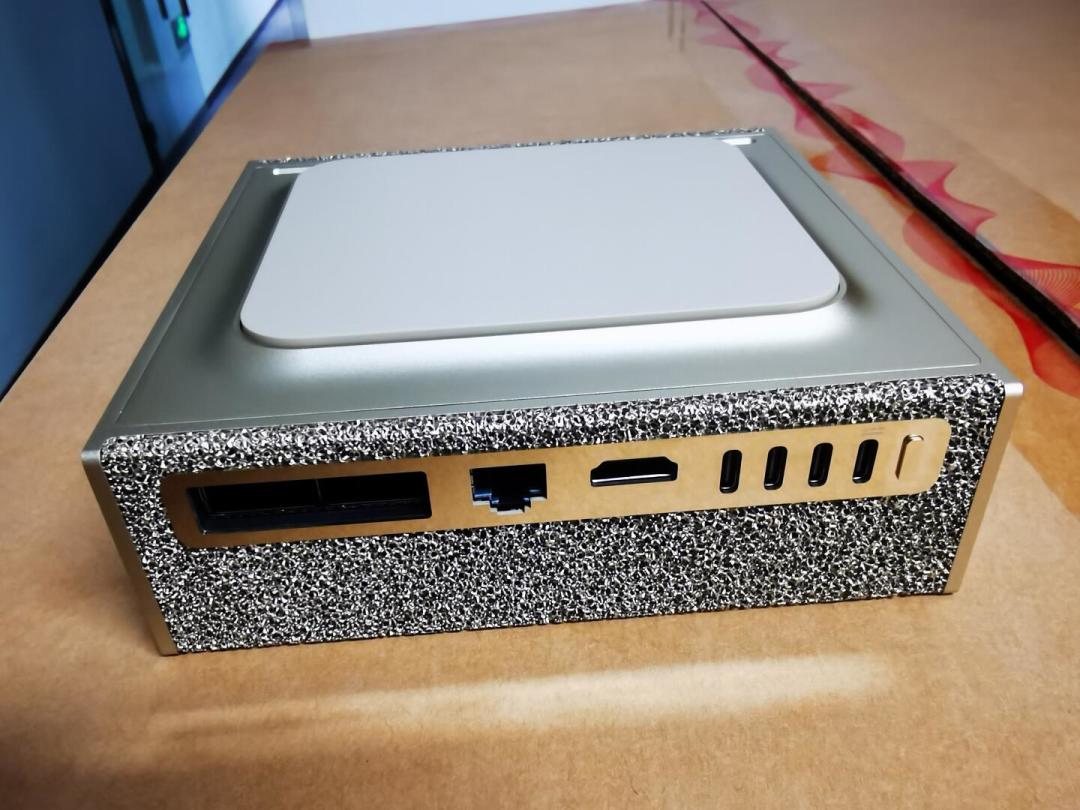
对"能不能用"的判断,圈里这个月的共识已经换了口径:不看"能装多大的模型",看"这台机器在你想干的活上,每秒吐多少 token、要不要干等"。修老照片、跑批量文档,40 tok/s 和 20 tok/s 是两种体验;拿它当编程助手挂工具链,还要再看工具调用稳不稳。
结论先摆这:拿"支持千亿参数"当卖点的商品页,都没有附带一张独立实测的速度表。 现阶段谁先交出可复现的整机实测,谁的溢价才算成立。
第三本账:知情权——那个替你做决定的,从来不是你
回到淘宝这条线。评论区一条 537 赞的高赞把问题说到根上了:往用户手机里偷偷塞模型,至少得给用户知情权和选择权。原帖评论里还有一句 471 赞的调侃更扎心:“御三家里面,淘宝塞个千问、微信塞个混元、抖音塞个豆包——你的 256G 空间就是这么被占完的。”小红书
笔记里几个细节值得每个安卓/iPhone 用户去自查:模型 5 月底被静默下载;藏在受保护的系统沙盒里,自带文件管理器看不到;App 设置里的"清除缓存"只把它当普通数据一笔带过;全程没人告诉过你下载了大模型。对照案例就在评论里:Chrome 的端侧 AI 至少给了开关,你可以选择不装。小红书
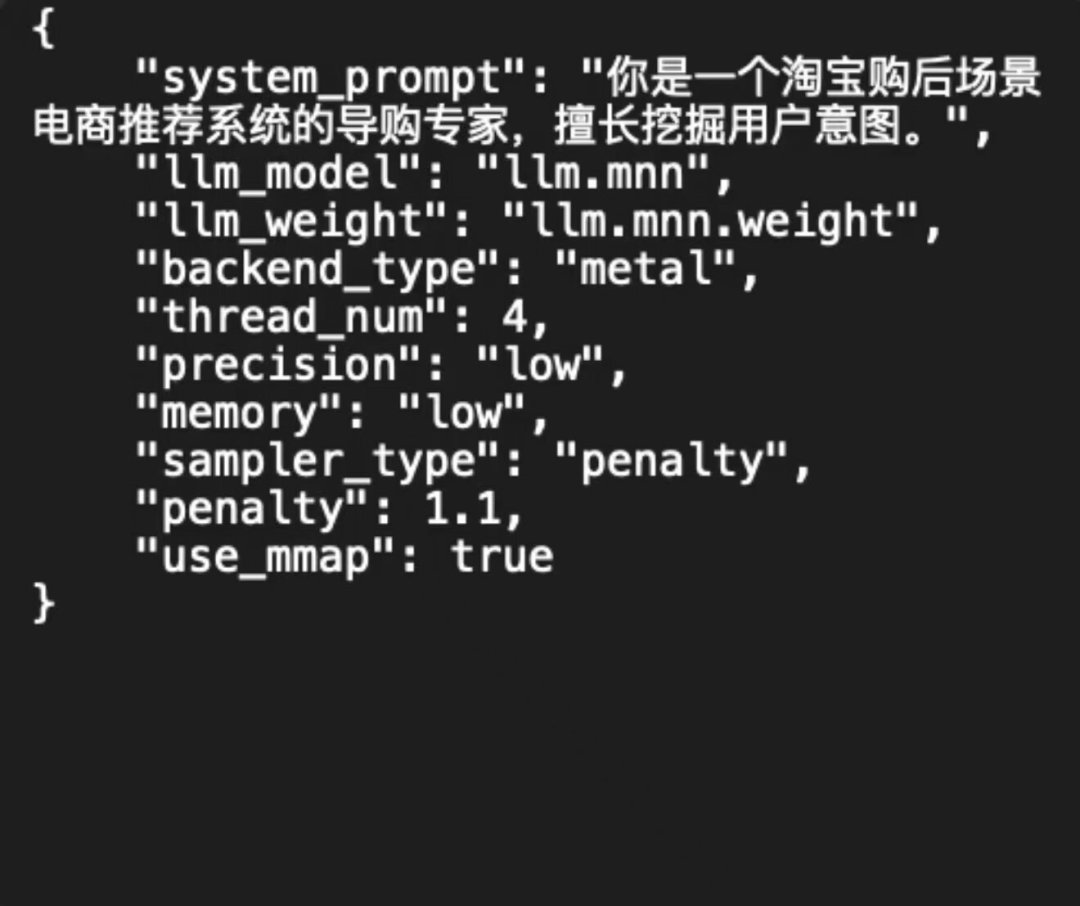
这里有个容易被带偏的点,掰开说:端侧推理对隐私的好处是"偏好数据不用全回云端"——但这个好处只在模型是你的、开关在你手里时才成立。 别人预装在你设备上的模型,受益方是它背后的公司:本地跑推荐意图模型,响应快是真的,省云端成本也是真的,“为你隐私"只是副作用。笔记作者自己也承认,端侧 AI 本身是大趋势,人脸解锁、相册识别都是本地模型——问题从来不是"该不该有端侧模型”,是"凭什么不告诉我"。
这篇账对谁有用、对谁没用
如果你想要的只是"本地跑开源模型": 这轮硬件潮跟你关系不大。旧卡+开源引擎+开源权重的路线,这个月反而更好用了:ROCm 驱动本月正式登陆 Windows,A 卡也能本地部署大模型了。三万块的溢价硬件,等第一份独立整机实测再说话。哔哩哔哩
如果你正在换新机/新笔记本,被"本地大模型/AI 主机"话术晃到: 看三件事——开箱自带的模型是多大、有没有你关得掉的证据;"千亿"是不是 OTA 期票;宣传的隐私卖点,在你自己的设备上做过一次开关检查吗(顺手去翻翻购物 App 占了几个 G)。
如果你有真离线、真合规需求(资料不出本机): "数据不出门"这次终于不只是 PPT——但请从 6999 元档的现成货开始试,而不是从期货模式的旗舰开始。
继续盯着的四个信号: 10 月 23 日 DGX Spark 64GB 开售后第一批第三方实测;YOGA"超能模式"OTA 的实际交付时间和规格披露;豆包手机助手被主流 App 围堵后会不会改走本地模型路线;淘宝对端侧模型目录是否给出可见/可关的选项——最后这条,是这轮商品化潮里最便宜、也最该赢的一次投票。