今晚(9月13日)知乎上一篇《本地AI越聊越慢?12G显卡的隐形账单》开始在各个本地模型群里流传。作者在自己那台12G显存的机器上算了一遍账,结论相当打脸,但每一步都有实测数字托底:让你变慢的,不是模型不行,也不是卡太烂——是上下文账单(KV cache)把"待命的专家"从显存里挤了出去,此后每生成一个token,都要从内存甚至硬盘里现叫人。
这篇帖子里最出圈的是那个包厢比喻:把显存想成一间固定大小的包厢,里面坐三拨人——“老板”(基础权重,永远在座,Qwen3.6-35B-A3B这个档位实测约1.6GB,赶不走也不用赶)、“记录员”(KV cache,你说一句他记一句,线性增长、全程不腾)、“待命师傅”(专家驻留区,MoE模型每层256个专家,每个token只叫其中几个干活,待命的师傅越多,喊一声立刻有人应答)。短对话时记录员只占几百MB,几乎无感;上下文一拉长,记录员开始抢包厢,被赶出去的永远是师傅。知乎
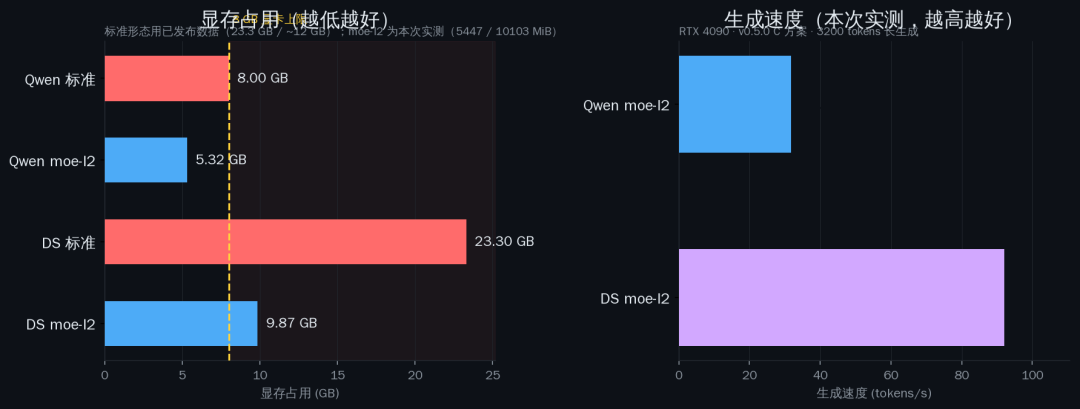
关键这是道MoE时代的通用算术——Qwen3.6-35B总参数35B、每个token只激活约3B,跑的就是这套预算。作者在4090上用两组实测斜率换算出来的结论一句话就能看懂:IQ2量化档、f16 KV精度下,你想开256K上下文,代价相当于把每层专家位从150个砍到20个——命中率从84%掉到64%,生成速度从32.8 tok/s掉到24.8 tok/s。"越聊越慢"不是玄学,是预算战的定量结果。知乎
第一本账:三个数字,让"越聊越慢"可以被算出来
把作者公开出来的实测锚点摆成一行账:
KV cache按20.48 KB/token(f16,Qwen3.6-35B-A3B是40层里只有10层持KV的混合注意力,在同类里已算省)折算:64K上下文约1.3GB,128K约2.6GB,256K一条就吃掉5.1GB——12G包厢,一半没了;
那台3060 12G跑moe-l2发布版的完整曲线:每多开128K上下文,多掏约2.6GB;从64K拉到384K,速度掉了约20%,规律干净得不像玄学;
量化档也在账单上:Q4专家权重约为IQ2的2.3倍,IQ2能开256K,Q4同一张卡只剩128K上限;Q4硬开256K会怎样?起服能过(10674 MiB),第一个请求生成到一半直接OOM崩掉——起得来≠用得了。
一个必须说清楚的前提:这套斜率是在3060/4090上量出来的N卡数据。机制本身长在llama.cpp这个引擎层,A卡走Vulkan后端是同一笔账;但落到每张具体卡上的tok/s绝对值,要按你的A卡实际水位折一下再看。知乎
第二本账:A卡的包厢能坐到什么模型(9-07显存需要表 + 两张RDNA3实测)
知乎博主"黑虾"9月7日那篇《2026年本地大模型,显存需要表》把消费级档位钉死了:
显存 | 能跑的最强通用模型 | 说明 |
|---|---|---|
8G/12G/16G | Qwen3.6-35B(MoE) | 智商明显高于4B/9B小模型,12G靠专家卸载方案可进 |
24G | Qwen3.8-27B Q4(稠密) | 消费级能跑的最强档 |
32G/48G | 同上 | 能跑的模型和24G一样,只是上下文多少的差异 |
95G起 | Qwen3.8-Flash-Next 180B Q4 | 27B之后直接断层,不是独显的活 |
博主的结论很直白:24G就是消费级本地模型的天花板,新装机想探索本地部署,优先考虑16GB显存。知乎
A卡这边不是纸面推演,有人真跑出来了。"清泓"8月18日用RX 7900 XTX 24G跑Qwen3.8-27B-Q4_K_M:显存占用21.3GB,初测33 t/s,调了一轮参数后稳定43+ t/s——提升的10 t/s全是调参白捡的。他特意注明后端用的是Vulkan不是ROCm("ROCm 6.x对RDNA3支持拉垮"是他的一家之言,而7900XT教程作者做了同样的选择)。知乎知乎
另一篇7900XT(20G)教程给的档位是:27B走IQ3_S量化、128K上下文、稳定40+ token/s,同时开"稳定版(显存约17GB)/加强版(约18-19GB)"两套脚本按任务切换——这就是给记录员腾1GB位子的现实版。知乎
教程里还有三个A卡新手必踩的坑:`–flash-attn`必须带值不能光写参数名;对话模板加`–jinja`就够不用下jinja文件;目录用纯英文,避免玄学报错。知乎
第三本账:不换卡,先调那三行参数
作者那台12G的机器最后从"只能开8192"变成"默认262144",中间没换硬件,只是把预算重新分了一遍。三个阀门:
上下文自动挡:moe-l2从PyPI 0.13.1起可以不填`–ctx-size`,引擎读模型原生窗口、再按你卡上实际显存预算收敛(3060上自动落在262144)。验证判据是起服后查引擎实际收到的上下文数——光看命令回显不作数。知乎
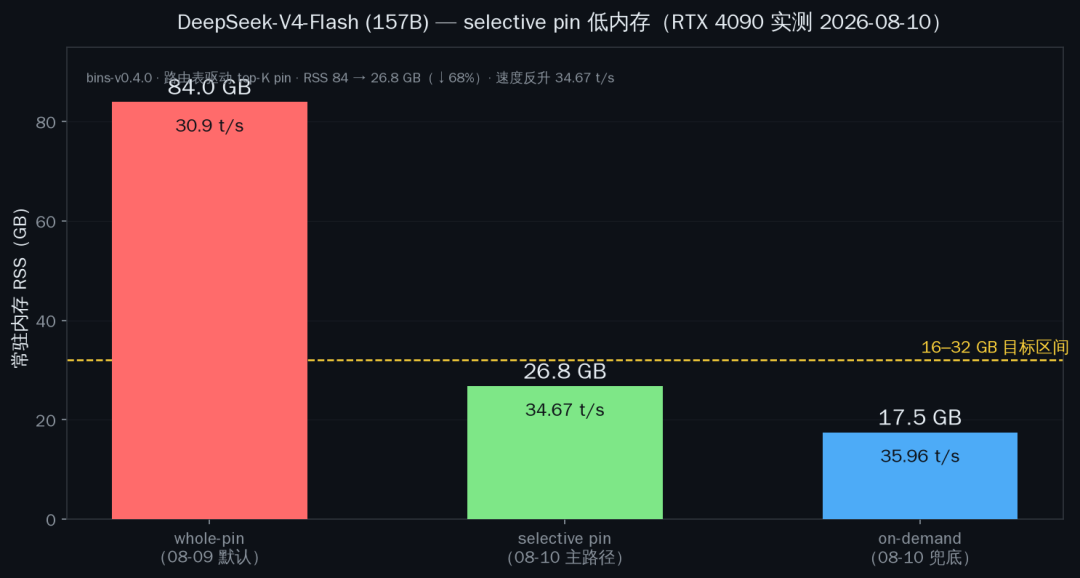
专家位可调:`–router-top-k`决定每层留多少专家驻留(默认75,覆盖约90%的调用)。要长文就调小,要速度就调大。同一仓库公开的demo数据(4090、DeepSeek-V4-Flash UD-IQ2_M)把第二笔账也算了出来:全量钉住专家要吃84GB内存,选择性钉住降到26.8GB,按需现拉只要17.5GB——在DDR5暴涨的2026年,"钉谁进内存"本身就是一笔新的成本。GitHub
3. 量化档自己选:IQ2和Q4差10.6GB权重,换算成上下文上限就是256K和128K的差别。
还有一档进阶操作:KV精度可以压——同样256K,从5.1GB压到1.4GB,省下的3.6GB按斜率够"养"91个专家位/层,速度反而更快,冷prefill快了近四成。但注意作者的自曝:质量只测了2轮定点检索没看到退化,样本太少不能当"无损"宣布;而且512K已超出模型256K原生训练窗口,能装不等于答得好。知乎
第四本账:内存暴涨风暴里,该不该掏钱、掏给谁
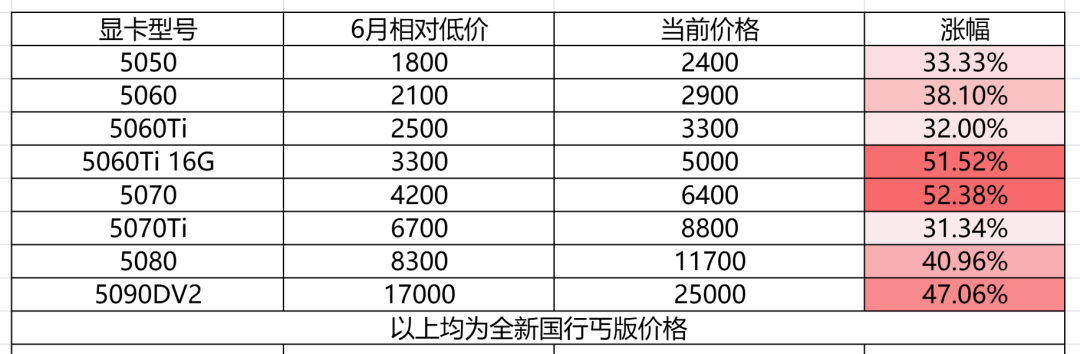
先把今天的行情摆上(9月12/13日硬件日报,淘宝最低价口径):9070 GRE(12G)3600元、9070 XT(16G)5270-5300元,是这波涨价潮里少数还没被抬走的位置。对面RTX 5080涨到12205元、又刷新了历史最高,5060 Ti 16G到了5000元(上周还有4900),5050 2400元。知乎知乎
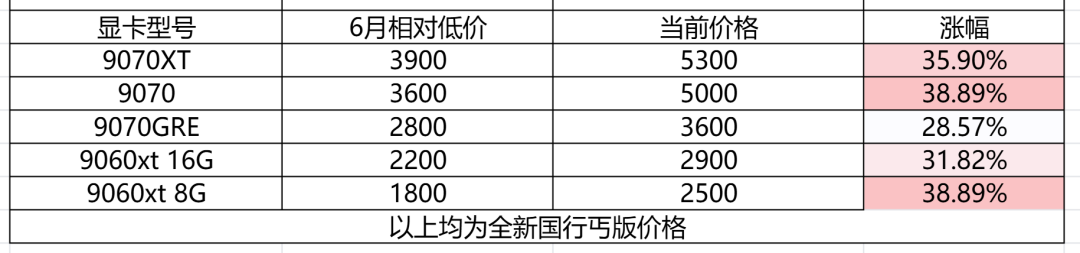
内存侧:杂牌DDR5 6000 16G双条2600元、DDR4 3200 16G双条1180元,大牌再加300-500;近一年内存涨了5-10倍,铠侠CEO这两天公开表态"芯片价格已经涨够",后面不打算再大幅抬报价。再过一个月多,双11(10月下旬开卖)就是下一个变量。知乎
对号入座:
手里是12-16G A卡、刚入坑本地AI:一分钱别花。先做第三本账的三行调整,"越聊越慢"九成是预算分错,不是算力不够。你的对手不是英伟达,是你自己开的上下文。
手里是7900 XT/XTX 20-24G:升级路径不在卡,在后端和参数——Vulkan路线跑通、调参白捡10 t/s。同理别为"接近Opus 4.6"的营销话术换卡,清泓8信源交叉验证的结论是:它在工程、浏览器、agent任务里超,在GPQA/HLE硬推理上仍落后。知乎
正在选一张"为AI买的卡":16G是水位线(9070XT 5270-5300),12G(9070GRE 3600)是带专家卸载的极限入门;至于24G"天花板"路线,RDNA3老卡全新货在日报里已经见不到价格线,基本只能走二手/尾货,溢价追高要谨慎。
想跑180B大模型:那是统一内存的活。知乎有人实测395(128GB)用unsloth量化的MTP版Qwen3.8-Flash-Next Q4_K_XL、262144上下文拉满、ryzenadj压到100W还得配强力散热,能稳在25-35 tps、完全可用。顺便说一句,那个"现在怎么没人提395了"的提问,本身就站不太住。但国行首波量极少、价格处于高波动区,冲进去前要接受溢价和折腾成本。知乎
这波"显存账单"的讨论,表面是72小时热点,里子是这两周集中落地的三件事:Rob Braxman 9月11日演示了Strix Halo通过llama.cpp+Vulkan后端把GPT-OSS-120B提速近7倍。LTX 2.5开源,B站UP主"全网首发AMD+Win11"跑通、标称最低8G显存就能生成视频。unsloth系MTP量化让180B级模型第一次在128GB统一内存上变成可用工作机。2026年本地AI的瓶颈已经不是算力,而是"权重、上下文、专家"三拨人往谁的包厢里塞。哔哩哔哩哔哩哔哩
所以,如果你的卡越聊越慢,先别急着换卡,把账打开:先算KB,再算专家位,最后才是算人民币。
继续观察的信号:①moe-l2启动器会不会把KV精度压缩从"参考数据"做成正式开关;②双11前7900XTX的二手价会不会被挤下来;③铠侠"涨够了"的表态能不能传导到内存现货价——传到了,整机党的账才能重算。