





18
11
智元机器人:一台苦学不如百台互教,百台互教不如群智成风
2026-11-02 18:28:17
1点赞
0收藏
2评论
➡️ 智元联合清华、无问芯穹发布CEL,96台真机集群验证:机器人互相教干活,两台新机600次测试成功率97.5%,五项任务均超人类远程操作员平均。但97.5%是固定工位实验口径,不是上岗验收,外推效果未公开是下一道坎。
文|一见 • 栏目|数字视线
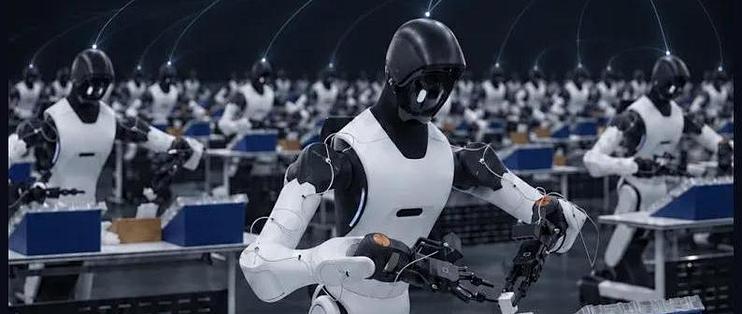
10月30日发布的CEL实验中,一支96台真机集群在五项真实任务上并行作业。、
插花、叠衣、给手机充电、组装凳子、包装手机。先别记97.5%,先记这三个字:固定工位。
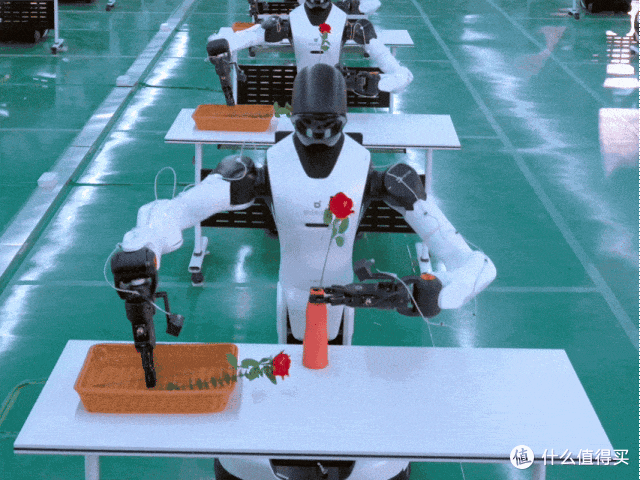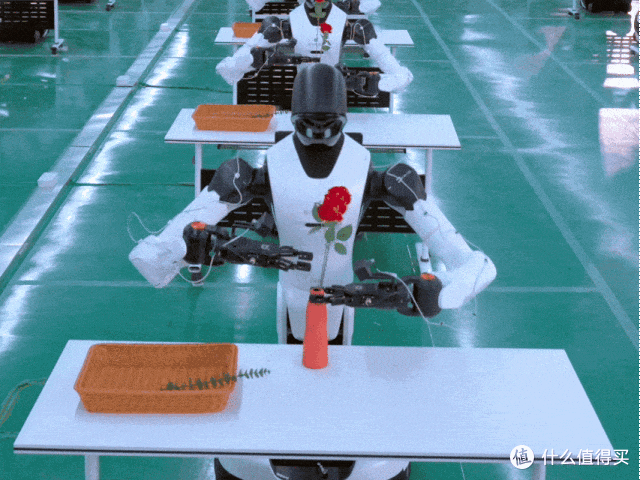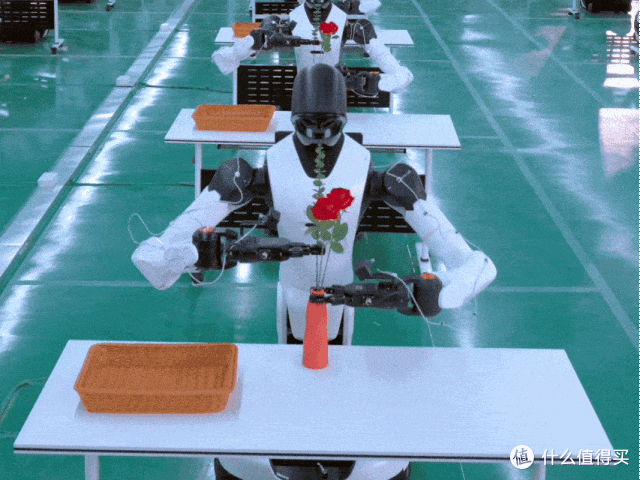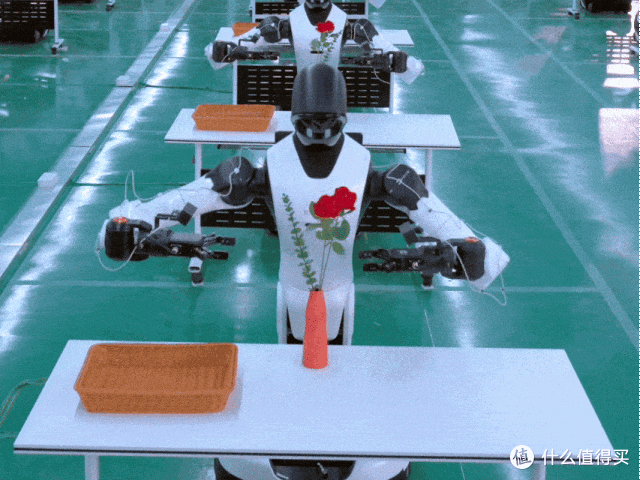
干完一轮,失败的片段被系统记下来,成功的片段被检索出来,喂给下一轮训练。
两天后,两台从来没参加过训练的机器人被拉出来考试,五项任务各开展120轮测试,合计600次,只失败了15次。这不是一台机器人在变强,是一群机器人在互相教。
一台苦学不如百台互教,百台互教不如群智成风。
下次有人再问“机器人会不会自己变强”,你可以先问他一句:你猜是一台聪明,还是一群聪明?
◆ 人不够用了,机器开始互相教
过去机器人学干活,靠人教。
工程师一遍遍示范,纠正每一个动作,记录每一次失败。
这套方法在小规模时管用,但有一个天花板:机器人越多,需要的人越多,而专家的人力是有限的。
这组数字能说明“人不够用”不是修辞。Scale AI累计收集的机器人数据约10万小时,最领先的具身VLA模型Pi-0也只有约1万小时真机数据,而大语言模型吞掉的token量是100万亿级别。这组对比仅作量级参照,不是同口径可比。
机器人的高保真交互数据,只相当于LLM的十万分之一。
另一项前置工作GE-Act 2.0(2026年9月发布)也验证了一个门槛:训练数据达到3万小时,模型才出现能力“顿悟”,3万小时以下,折叠毛巾、嵌套纸杯等精细动作在小规模数据训练的模型上无法被理解。
这是CEL发布之前、智元在另一项世界-动作模型实验中的发现,不是CEL论文本体。人要一台台教到3万小时,教不起。
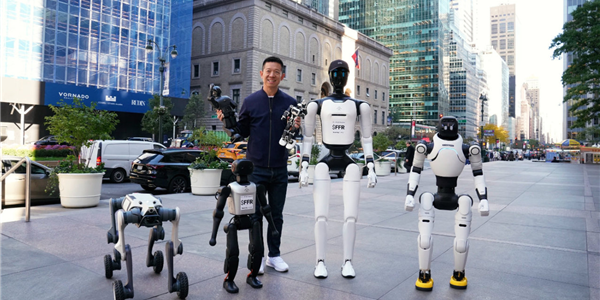
智元2026年3月量产破万台,9月第20000台下线。下半年进入规模化部署期。产线上的机器人数量在涨,能教它们的人没跟着涨。
这就是“人不够用”从修辞变成工程约束的节点。
10月30日,清华大学、无问芯穹和智元联合发布了一个叫CEL的方案,全称Collective Experience Learning,群体经验学习。
核心思路一句话:把经验来源从“人”换成“机器人同伴”。
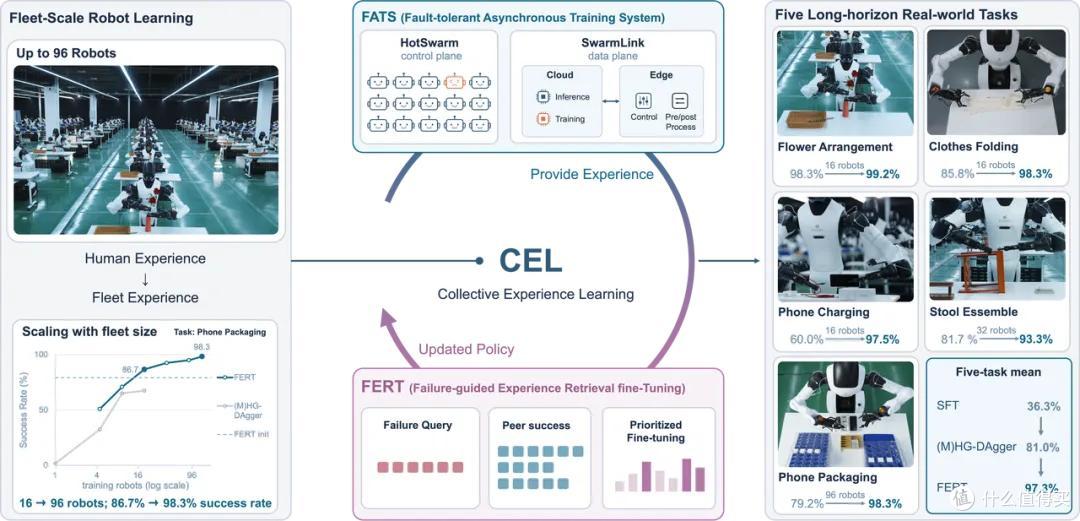
具体做法是:机器人在真实任务中执行的每一轮轨迹,包括成功的和失败的,都上传到集群经验池。系统从失败样本里检索出相似任务的成功片段,再用这些片段去微调策略。论文里管这叫FERT,失败引导的经验检索微调。支撑它在96台规模上跑起来的,是一套叫FATS的容错异步训练系统。
■打个比方,这就像一支新组建的施工队。以前每来一个新工人,都得老师傅手把手带。现在工地上装了一套记录系统,谁干得好、谁在哪一步踩了坑,全记下来。新工人进场,先看这套记录,不用等老师傅有空。老师傅没变多,但“被教过的人”变多了。■
◆ 96台,五项任务,97.5%是怎么来的
实验分两段。
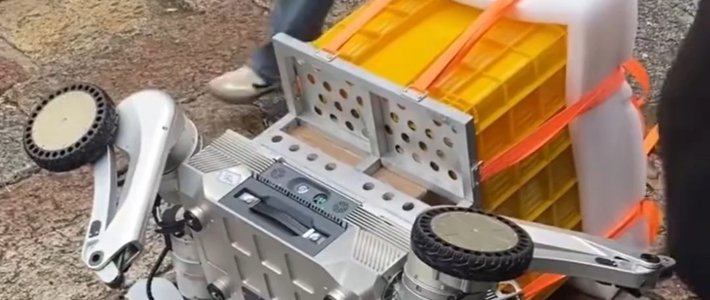
第一段是集群训练:96台机器人同时执行五项任务,插花、叠衣、手机充电、凳子组装、手机包装。每一轮的执行轨迹进入经验池,FERT从失败里找成功,FATS调度异步训练。集群累计采集9834轮执行经验,期间22台机器人共发生30次故障事件,故障时间损失只占全部运行机时的1.3%。
第二段是验证:两台完全没有参与过训练的机器人,被拉出来考试。五项任务各开展120轮测试,合计600次,失败15次,总体成功率97.5%。五项任务的成功率,全部超过6名人类远程操作员的平均水平,最高反超16.7个百分点。
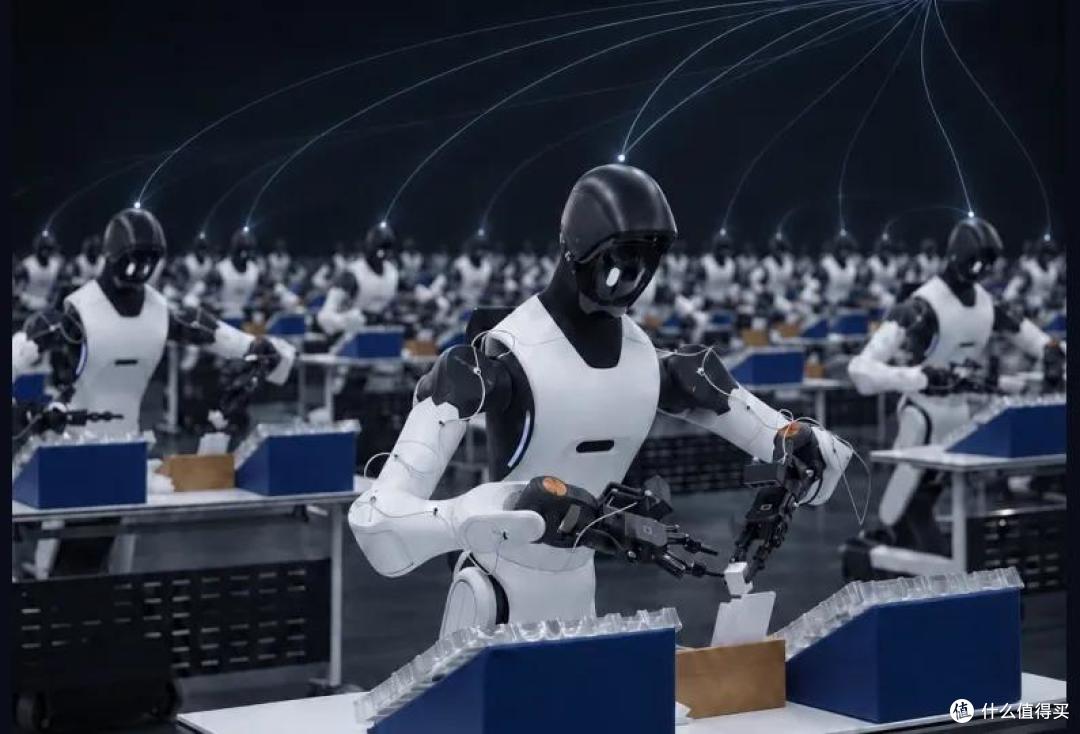
手机包装这一项有单独的数据:在16→96台扩规模下,成功率从86.7%升至98.3%;该任务在更早基线也曾以79.2%起步,最终同样到98.3%。两条数据不是同一横坐标,前者看的是规模效应,后者看的是长期迭代。
97.5%这个数字,有三个限定条件必须一起看:第一,测试对象是“未参与训练的机器人”,不是量产产品;第二,测试环境是“固定任务、固定工位”,不是开放场景;第三,600次测试是实验次数,不是生产可靠性指标。换句话说,它证明的是“这条路走得通”,不是“这条路已经到终点”。
这里有一个容易被略过的变化:人的角色变了。
上观新闻的报道写得很明确,“人类的角色也从动作示范者逐渐转向任务结果判定者”。论文里的口径是,人类反馈从“密集动作标注”转为“稀疏结果判定”。
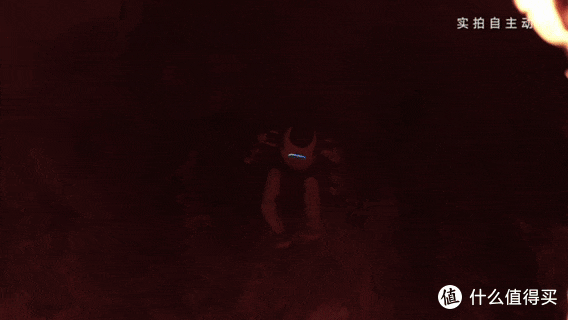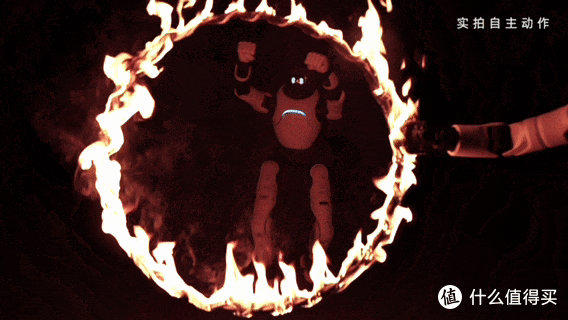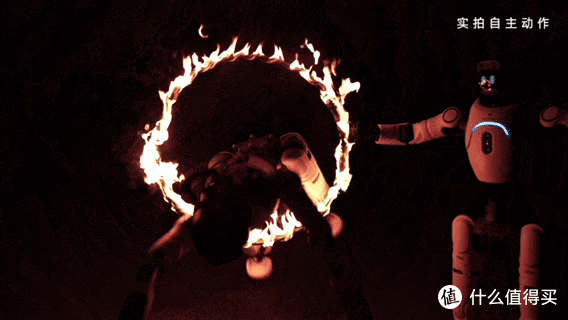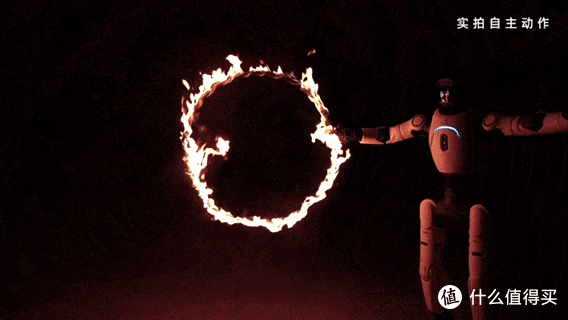
过去人要盯着每一个关节角度、每一次抓取力度;现在人只需要在任务结束时说一句“成了”或“没成”。
这不是分工的微调,是训练范式底层的位移:人从“教动作”退到“判结果”,中间的过程交给经验池和FATS去消化。人退到结果验收,不代表责任退出。
判结果的这个人,仍然要为“什么算成了”定标准。
如果你带团队,这篇文章值得看的是:它把“师傅带徒弟”变成了“班组共享错题本”。
◆ 群控不是群体智能,规模也不是无条件成立
有一个概念需要拆开。“集群控制”和“群体智能”不是一回事。
前者是中央系统发指令,N台机器人执行同一套调度;后者是分布式经验共享,每台机器人的成败都成为整个群体的学习素材。
一般而言,仓储AGV的调度、无人机编队,属于前者;CEL想做的事,属于后者。
为什么“群控”容易,“群体智能”难?
因为群控只需要同步动作,群体智能需要同步经验。
动作可以靠指令对齐,经验必须靠机制沉淀——哪些失败值得记、哪些成功可以复用、什么时候该检索、什么时候该微调,每一步都要设计。
恩典并不摧毁自然,而是成全自然。阿奎那这句话,放到群体学习里可以改一改:经验不取代个体,而是成全群体。每台机器人的失败不是损耗,是养料;每台机器人的成功不是终点,是教材。但前提是,经验池能装下、检索能找对、训练能跟上。
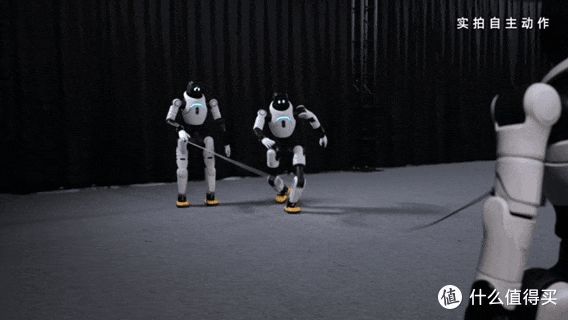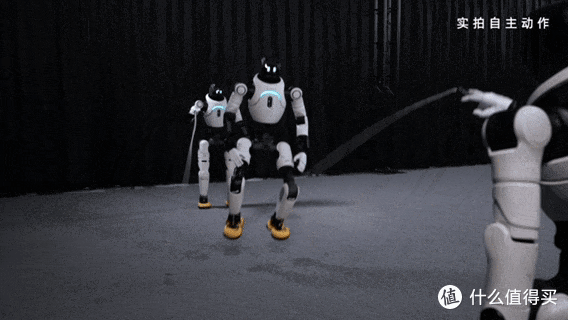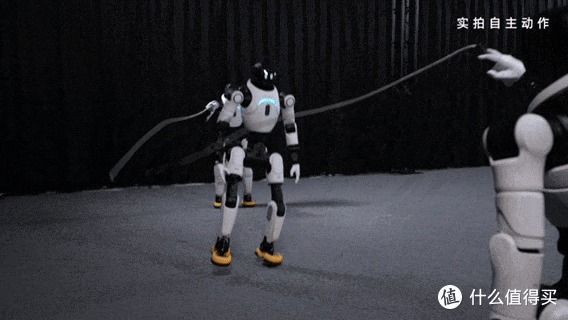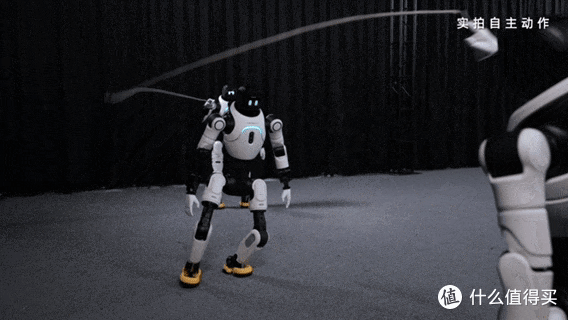
但“越多越强”有一个容易被忽略的限定条件:量的积累,不等于质的多样。
有报道指出过一个结构性问题:智元量产1.5万台机器人,部署场景高度集中,任务流程固定、操作对象统一、环境变量极小。
GE-Act 2.0的训练数据里,约2000小时的失败操作和实际部署回流数据,在3.2万小时机器人轨迹数据中占比约6%。
换一个环境、换一套操作对象,机器人就表现出明显的泛化短板。CEL解决的是“经验供给的量”,但“经验的异质性”是下一道坎。
规模能带来量的积累,不自动带来质的多样性。
还有一层边界必须说清楚。“机器人越多越强”成立的前提是:每台机器人的采集时长固定,只增加数量。
如果数量增加但每台的训练时长被摊薄,结论可能反过来。
从96台到数千台的外推效果,论文没有公开;跨场景的泛化能力,也没有公开。真正的门槛不在“96台”,在“96台之后”。
能互相教是一回事,教会之后能不能稳定干活是另一回事
CEL证明的是“经验供给可以规模化”,不是“机器人已经不需要人了”。前者是范式突破,后者是商业终局,中间还隔着外推、泛化、成本三道坎。
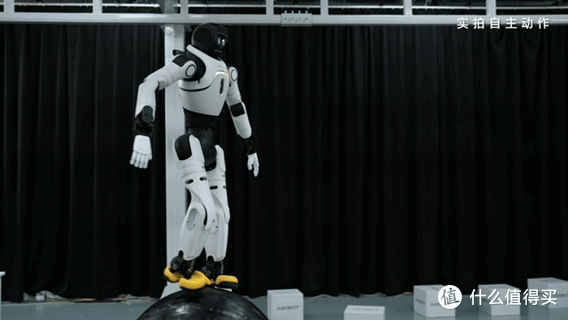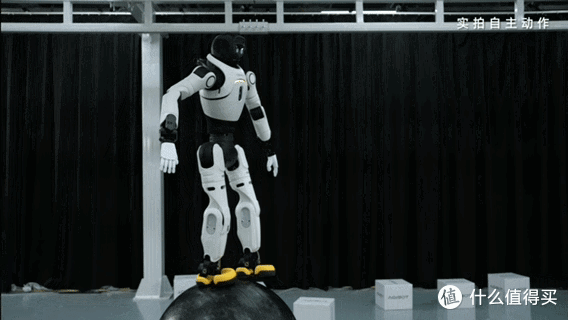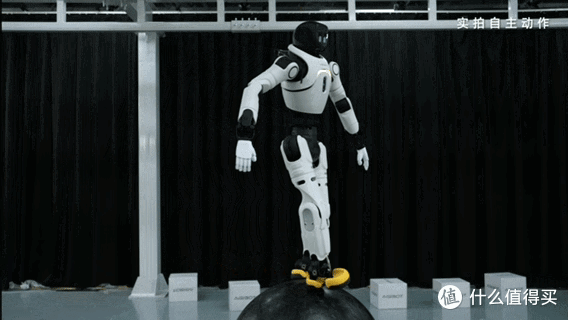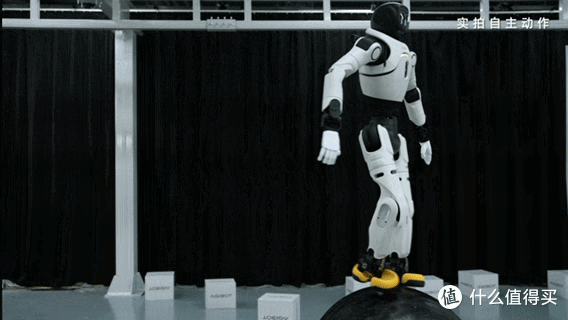
一台学,两台教,九十六台齐动脑。
九千轮,三十败,群经验里捡法宝。
莫喊替代先别闹,外推泛化还没考。
如果机器人真的能互相教干活,你最希望它们先学会哪件事?是工厂里的重复工序,还是家里那些非结构化的家务?
#智元CEL# #群体经验学习# #群体智能# #机器人集群# #群体经验学习# #具身智能Scaling# #智元机器人#
【免责声明】 :本文部分配图源自公开渠道或CC0协议素材,仅作行业交流与产业参考使用。如涉侵权,请联系后台处理。本文仅做行业科普与实操分享,不构成任何投资、消费决策建议。文中数据及案例均来自公开信源,仅供参考,具体以实际为准。
作者声明本文无利益相关,欢迎值友理性交流,和谐讨论~











校验提示文案
校验提示文案