先说结论:你手里那张 RTX 30/40 系显卡,过去可能一直只跑了半速。
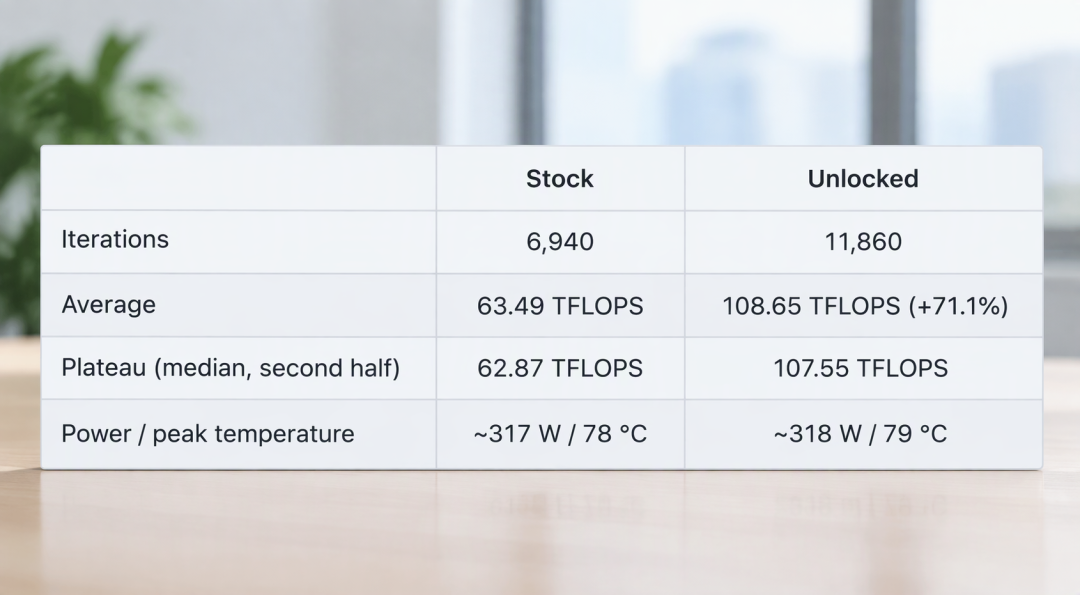
10 月 18 日,开发者 Zagitta 在 GitHub 建的一个仓库,七天攒下三千多星。这个叫 gpu-unlock 的开源项目,把英伟达"藏"在消费卡里的算力挖了出来:RTX 3090 Ti 的 BF16 吞吐从 87.5 TFLOPS 干到 157.4,接近 +80%。海外二手市场反应更快,3090 Ti 一周内从 1000 美元被炒到 2650 美元。知乎哔哩哔哩知乎
但"吞吐翻倍"的传言之所以容易翻车,是因为它藏住了细节。
撬开的不是核心,是一把固件限速锁。 3090 和专业卡 A6000 用的是同一颗芯片,CUDA 核心、Tensor 核心一个没少,没有任何物理阉割。差别在于英伟达在固件里写死了一组"速度选择器"寄存器(SS0/SS1),把"半精度输入 + FP32 累加"这条路径的指令发射速率砍到专业卡的一半——同样的肌肉,出厂要求你"每秒只能出一半的拳"。gpu-unlock 不动驱动、不刷 VBIOS,只在 Linux 开机时、驱动加载前的窗口里翻转那几个 bit,借 NVIDIA 自己签名的固件"自己动手解锁"。硬件一个字节没改,断电即失效。知乎知乎
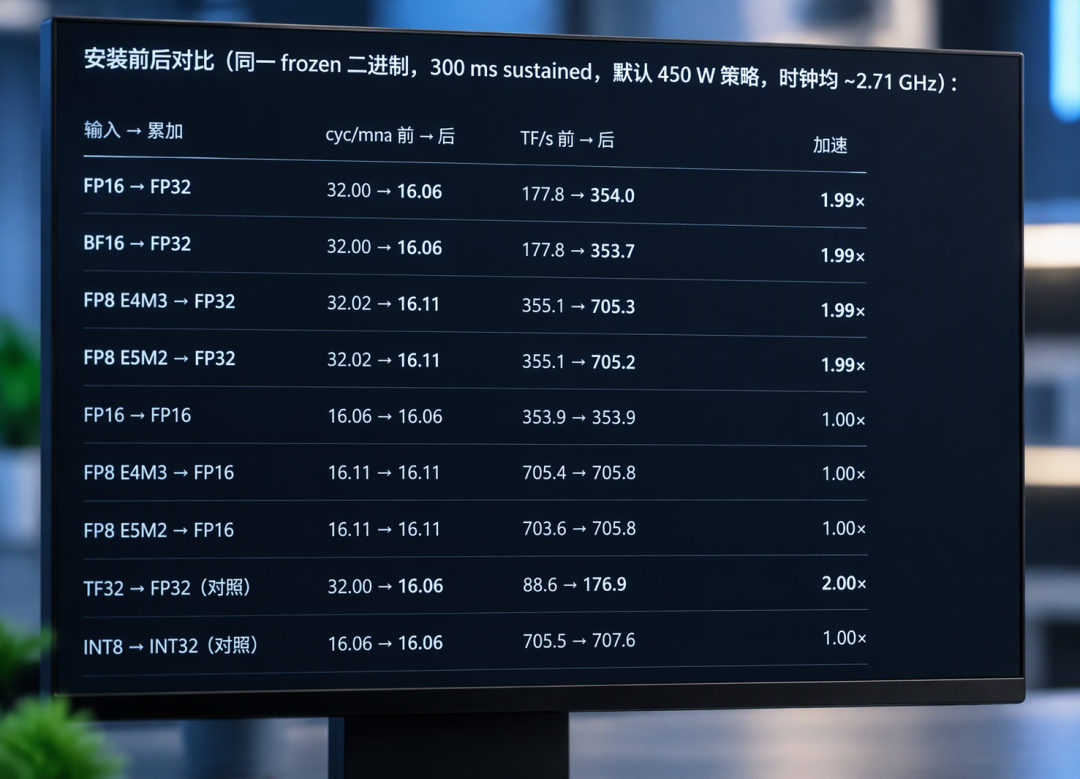
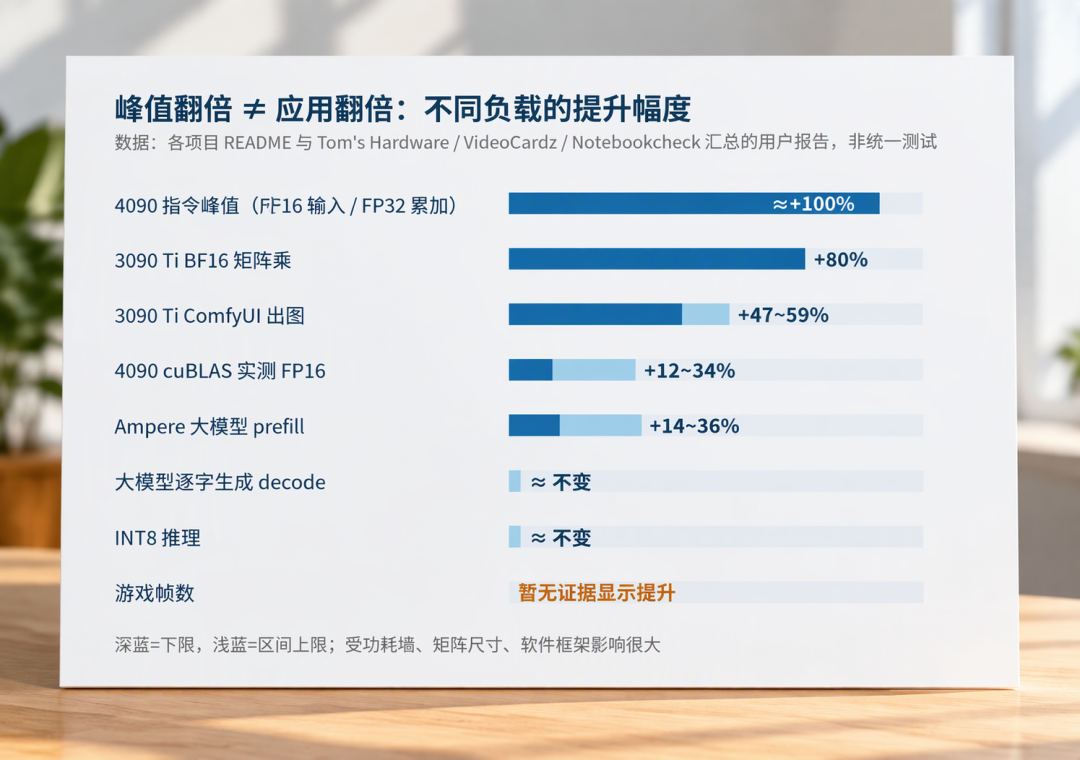
但跑分翻倍,不等于速度翻倍。 闸门只开在 FP16/BF16 + FP32 累加和 TF32 这两条路——恰好是大模型训练和推理 prefill 的主力场景;FP32、INT8 本来就没被限速,游戏帧数、大模型的对话生成(decode)环节,基本纹丝不动。实测口径很诚实:4090 真实 AI 任务普遍只涨 12%~34%。vLLM 长上下文 prefill 提升 33%~36%、首字延迟降约 25%,decode 无变化。ComfyUI 生图 BF16 快 20%~30%。如果你还把卡锁在 220W 功耗墙内,算得快反而更早撞墙降频,理论 2 倍到手只剩 1.5 倍左右。知乎知乎
谁适合上车,谁别凑热闹。 值得试的画像很具体:Linux 用户 + 30/40 系老卡 + 主要跑训练或 prefill 密集的推理。反之,纯打游戏的,这事跟你半毛钱关系没有。解锁目前只覆盖 20/30/40 系,50 系(5090)和 V100 不在范围。WSL2 架构上就够不着寄存器,别指望;至于 Windows,社区另有整机定制的 EFI 方案,但经过实机验证的机型 profile 屈指可数——主项目本身只是一个 Linux 内核模块,在 Windows 上一个字符都跑不起来。最多人追问的"会不会烧卡":它不碰电压、不碰频率。解锁前后计算结果逐位相同,真正的风险点在 Windows 路线要动 ESP 分区和引导记录,最坏后果是开不了机,不是卡坏了——保留原厂启动项,进 BIOS 就能选回去。哔哩哔哩知乎知乎
比"白捡算力"更有意思的,是这件事本身。 gpu-unlock 用几个寄存器证明:GeForce 和专业卡之间那道墙,很大程度上是固件画的,不是硅做的。只要"刀法"停留在软件层,就总有被反向解锁的那一天。