

一张 16G 的卡在手里,跑本地大模型慢得像 PPT。第一反应基本都一样:再加一张。
这个念头值两千多块。但按 11 月这几组实测看,大概率买错——真正该先掏钱的地方,是主板和内存。
先看主板第二根槽有几条通道
llama.cpp 的默认模式叫 layer split,两张卡轮流干活。Weights & Wonders 拿两张 RX 7900 XTX 实测:单卡约 36 tok/s,插上第二张变成 34;只有换成 tensor split 才有约 1.3 倍,前提是两张卡都插在快槽上。哔哩哔哩
不是坏了,是模式问题。这种模式下第二张卡只给你"空间"——更大的模型、更高的量化档、更长的上下文,就是不给你速度。而多数主板第一根槽给满 16 条,第二根只有 4 条,能拆成 8+8 的是少数。哔哩哔哩
通道少一截,代价立刻显形。佰年之玖拿双 V100 限速率实测 27B 模型:×4 时预处理只有 800 多 tok/s,×8 能到 1000–1200。哔哩哔哩
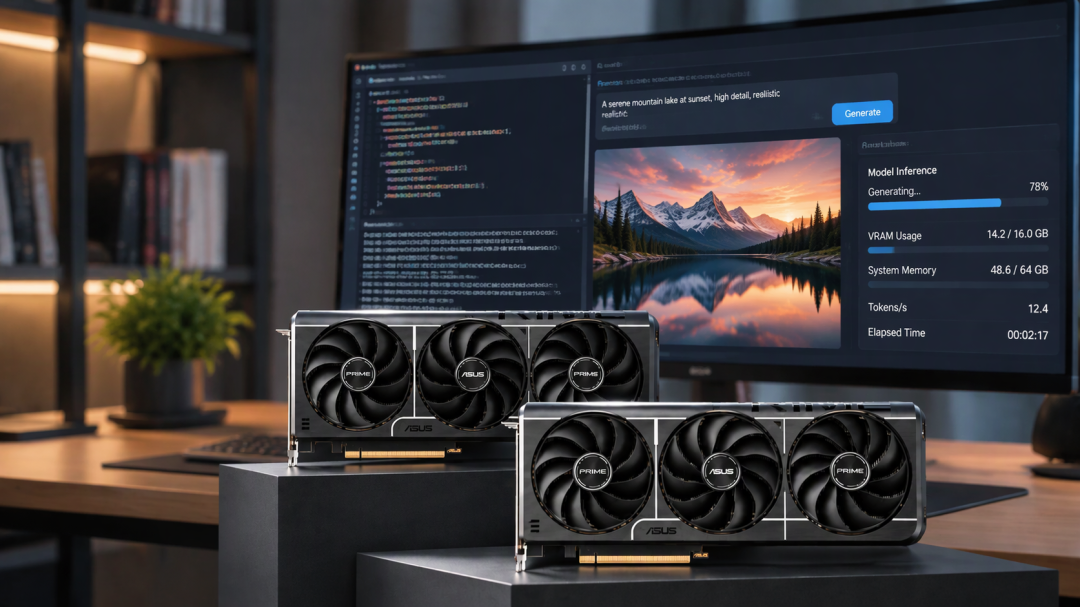
双卡真跑成的例子也有。74并不难 11 月那期用两张华硕 PRIME RTX 5060 Ti 16G 做测试平台,重点测长文本生成和 256K 上下文配置。配套也不便宜:一块能拆 x8/x8 的华硕创艺国度 B850-CREATOR 主板,电源直接上到 1200W 白金。哔哩哔哩
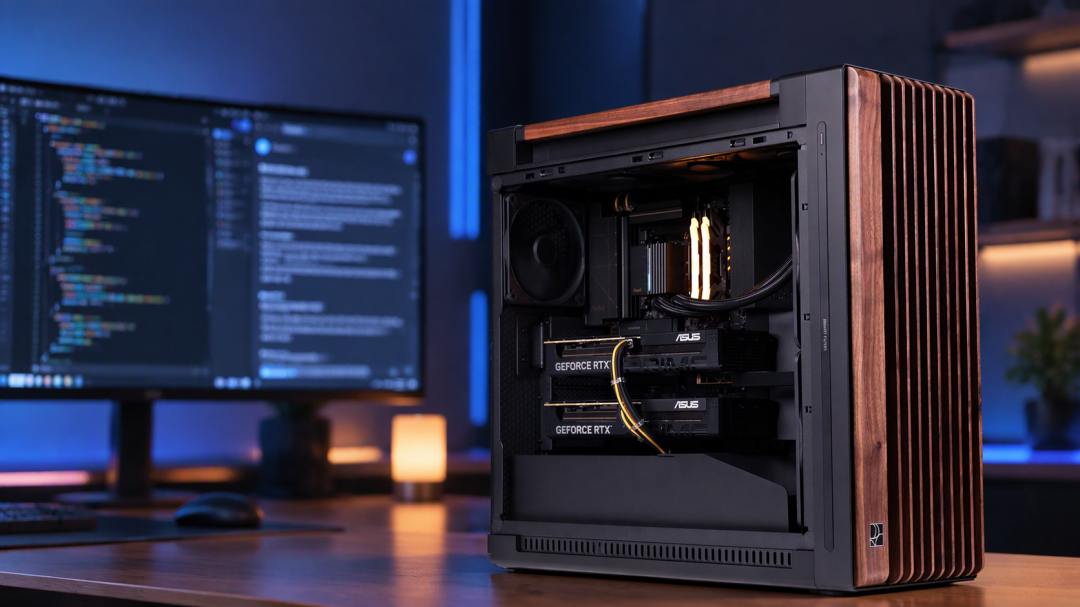
所以顺序是:先翻主板说明书,看第二根槽能不能吃到 8 条,再算电源余量。顺带记一句——两张 16G 从来不等于 32G 可用,驱动和系统要先咬掉一块。
改一个数字,比加钱快
11 月 20 日 Strata 更新到 0.2.17,没有新模型,只改了默认值:内存预算从 40 GiB 挪到 47 GiB。同一台机器(64 GiB 内存 + RTX PRO 4500 Blackwell + UD-Q4_K_XL),65K 提示的读盘量从 97.7 GB 掉到 37.0 GB,解码 57.7 → 84.2 tok/s。哔哩哔哩
硬件一颗没换,快了 46%。
司波图 11 月 19 日那期 10.2 万播放的视频是同一个路数:除了单双卡对比,还给同一台电脑分别装上 32GB、64GB 和 96GB 内存,专门测小显存跑大模型到底要多少内存来撑。评论区点赞最高的一条说得很直白——表面门槛在显存,其实门槛在内存。哔哩哔哩
宣传口径也得会拆。所谓"8G 卡跑千亿",官方那份说明写的是大卡限到 8G、再加海量内存工作站,才有 63–73 tok/s。换成真正的 8G 物理卡,只有 12.7–14.8 tok/s,差 5 倍。哔哩哔哩
显存不够,别硬塞
RTX 3050 6GB Laptop + Ollama 的一组实测:4B 模型 11.49 字/秒(86% 在卡上);8B 掉到 2.46 字/秒(一半权重还留在内存);同一个 8B 强制全走 CPU,2.80 字/秒。最反直觉的一条是,8B 上了显卡反而比全走 CPU 慢 14%。哔哩哔哩
原因很土:显存不够时权重要在内存和显卡之间来回搬,搬这一趟比直接在内存里算还长。这台机器空载就吃掉 5715 / 6144 MiB,真正能用的只有 429 MiB。显存一旦塞满,系统就开始往内存做页面交换,速度断崖式下跌。哔哩哔哩知乎
动手前先量一下自己那张卡:
```
nvidia-smi --query-gpu=memory.used,memory.total --format=csv
```
那钱按什么顺序花
翻主板说明书,确认第二槽通道数和电源余量;
加内存、把内存预算调对——MoE 模型的专家权重,本来就该待在内存里;
前两步都到位了还想加卡,先确认能开 tensor split。
有个社区实测的极端例子值得记一下:两张 750 元的 MI50 计算卡,加四条 288 元的 DDR3 拆机条,合计 2700 元,跑 125B 的 MoE 模型 decode 65 token/秒;同一张 4080 SUPER 只有 58,而那张卡的价格够配三台这样的机器。哔哩哔哩
几份互不相关的实测,最后都落在同一句话上:想快先加内存,比换显卡划算。带宽决定跑多快,内存决定跑多大,显存决定跑多稳。哔哩哔哩知乎

当前文章无评论,是时候发表评论了