全网评论区都在问:我这电脑能跑啥?一个开源工具直接测给你
折腾本地大模型的人,八成都在评论区问过同一句话:“我这台电脑能跑啥?”
B站一条本地实测视频的评论区,前15条里约8条只回了四个字符——“7900”,UP主置顶的"私信领配置单"口令。小红书那边更典型:一个求助帖标题就是问题本身——“本地大模型选哪个?”,底下攒了125条评论,有人劝"至少4070 16G显存",有人说"没六位数预算下不来",最高赞直接开药方:“买张5060+64G DDR4跑125B的qwen3.8 flash next,没有之一”。没人说错,只是谁都没先问:你想干嘛,手头什么机器。哔哩哔哩小红书
这股热度在知乎同样直观:"本地部署门槛高,有哪些适合本地部署的小模型"一条回答播放2.7万。"为什么ollama运行不调用GPU"的提问播放23.8万。知乎知乎
新手真正卡住的地方出奇一致:不是装不上软件,而是装完之后面对一堆模型不知道该 pull 哪个、不知道自己这台机器到底跑不跑得动。这道判断题过去只能靠经验做:你得知道显存能撑多大参数、Q4和Q8差在哪、MoE不能按总参数算。小红书知乎
把"得懂"变成"跑一下就知道"
11月2日刷屏知乎的开源工具llmfit(介绍文称它在GitHub上攒了38k star),就是冲这道判断题来的:Rust写的本地模型适配检测器,支持Ollama、llama.cpp、MLX、LM Studio等后端,跑一下直接给你一张表——哪些模型能跑、预估多少tok/s、推荐什么量化,用作者的话说,是"把这道判断从’你得懂’变成’跑一下就知道’"。知乎
几个设计确实对症:
MoE按激活参数算,不按总参数:Mixtral 8x7B总参数46.7B,每个token只激活约12.9B,照总参算显存会吓退一堆人;
量化从好往差找:不是写死推Q4,而是从Q8_0质量最好的档往下试,找你的硬件能跑的最高质量版本,跑不动的标Too Tight沉底,不混在列表里误导你;
速度按带宽估算:内存带宽÷模型大小×效率因子,带宽库覆盖约80张GPU。
最实用的是"买前买后"两个键。按S键模拟硬件,设好RAM、显存、核数实时重算评分——“想买一张3090看看能跑什么,用这个就够了,不用真买”。按p键反过来问"我想跑这个模型需要什么配置",它直接吐出最低和推荐配置。知乎
理论分不敢全信的话,还可以看社区排行:评分之外,它接的是别人在相同硬件上实际跑出来的tok/s、TTFT和峰值显存。这些数据来自localmaxxing.com;不满意就按I键对自己机器发真实请求。知乎
但先别急着加钱
工具给的是"能不能",钱花得值不值还得看用途。还是那条4000块二手7900XTX实测,"近200 Tokens/s"被评论区拆了层:那是24K输入下的单次峰值,50多轮平均约150、解码中位83.4,还挂着MTP接受率六成的前提。另一位UP主的账更直观:花8000元把内存从32G加到96G,评论区高赞算完发现钱买的主要不是解码(32G时解码已能跑到180),而是预填充从11.4秒降到3.9秒;有人现身说法,agent内存一满整机卡死,QQ、微信都不敢挂后台。哔哩哔哩哔哩哔哩
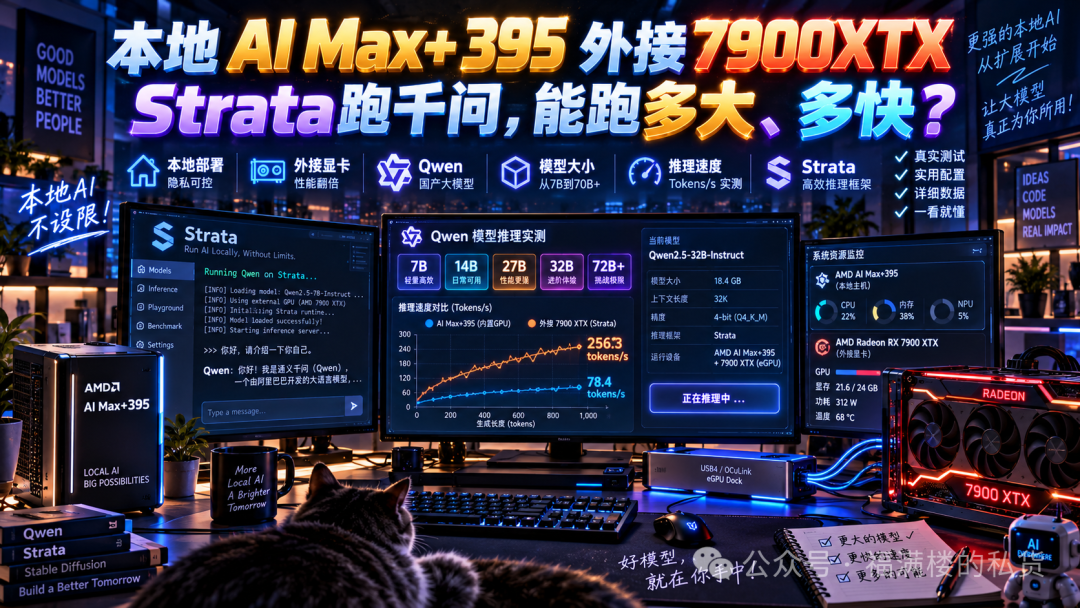
所以顺序应该是先定用途,再定配置:只是聊天问答,小模型加普通内存绰绰有余;要写代码、挂agent、开长上下文,才轮到谈显存和带宽。
纯新手连入口都没选对也白搭。同期知乎一篇工具横评把话说得很清醒——入口选错比模型选错更耽误时间。LM Studio图形界面最省事,点几下就能下载模型打开对话;无显卡的普通笔记本,可以先试文档里写明针对3到13B模型优化的GPT4All,跑通了再谈命令行那条路。知乎
也别忘了原文划的边界:本地模型跑得动,不等于跑得和线上大模型一样好。难问题,还是要留给更大的模型,或者留给人核对。知乎
下次在评论区求配置,先把这两句话打出来:我要用它干什么,我现在有什么机器。问得出这题,才接得住答案。