本地AI电脑进入上新密集期。
全球首批 RTX Spark 笔记本 10 月 16 日晚全面开售:联想 YOGA Pro 15(128GB 统一内存)参考价 42999 元,华硕 ProArt 创16(64GB)美版折合约 2.94 万元、国行价待定;微星也发布 EdgeMesa N AI+,把同款平台塞进 1.3L 的桌面盒子,11 月上市。AMD 那边抢跑——极摩客 EVO-X5 Pro 在 10 月 9 日发布会后开卖,46999 元,卖点正是 192GB 统一内存、「本地运行 320B 大模型」。芯东西微型计算机微星GAMINGGenima

表面看是内存军备竞赛:64GB、128GB、192GB,一个比一个大。但刚出炉的实测数据,揭出了一个广告里几乎不提的参数:带宽。
内存决定「能不能跑」,这是入场券。EVO-X5 Pro 的 192GB,才让 DeepSeek-V4-Flash-0731 启动起来——上一代 128GB 机器连权重都装不下;RTX Spark 这边,英伟达官方给的配方是:128GB 版跑 78GB 的 Qwen3.8-Flash-Next(1250 亿参数),64GB 版降一档,只装得下 36GB 的 Qwen3.8-27B。Genima芯东西
带宽决定「跑多快」,这是体验。而这一项,两条新路线短板得相当一致:AMD 约 273GB/s,英伟达峰值 300GB/s。于是 EVO-X5 Pro 上那个 320B 级 DeepSeek,每秒只吐 14 个 token,能用,但谈不上快;RTX Spark 笔记本跑 27B 稠密模型是每秒 23~34 个 token,和先上市的 DGX Spark 一个水平。原因不玄学:稠密模型每生成一个字,都要把整份权重从内存里读一遍,解码本质上就是带宽游戏。芯东西微型计算机Genima

真正把带宽当命根子的是苹果。Mac Studio M5 Ultra 带宽 1.2TB/s,是上面两位的四倍:跑同一个 Qwen3.8-Flash-Next,单台每秒 129 token,两台 DGX Spark 联手也才 29.6。但 Mac 路线的短板同样明显——没有 CUDA,很多开源模型的适配要靠自己折腾。Uno WhoiamGenima
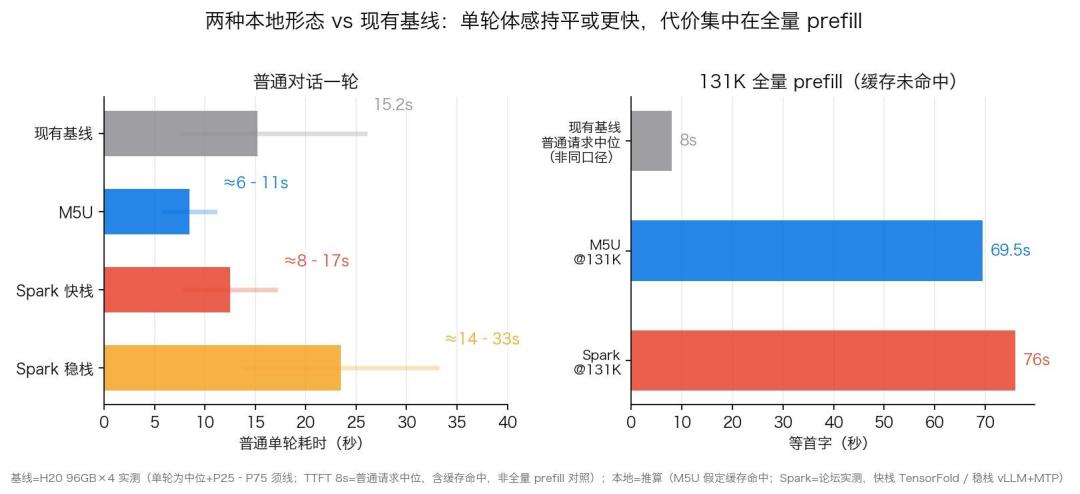
所以三条路线卖的其实是各自的长板:英伟达卖生态,CUDA、Windows、外加 1440p 百帧的游戏能力,赌的是「一台全包」;AMD 卖容量,46999 元 192GB,单位内存价格优势明显;苹果卖带宽,推理最快,但生态是代价。芯东西Genima
下单前先想清楚你每天跑什么模型:主力是 35B 级小 MoE,AMD 实测 90 token/s 已经相当好用;要 CUDA 做开发、还想兼顾游戏,RTX Spark 目前是唯一解;纯推理不想折腾,Mac 仍是速度天花板。Genima
再提醒两句。一是 Windows on Arm 兼容性还在补课:Prism 转译层能兜住大部分 x64 软件,但 GPU-Z 这类工具仍会翻车。二是营销数字别照单全收——微星标题写「本地运行 200B」,官方正文口径是「120B 流畅」;英伟达说重度智能体用户「几个月收回硬件成本」,这笔账得自己算过再信。微型计算机微星GAMING芯东西

内存军备竞赛已经卷到 192GB,带宽军备竞赛还停在 300GB/s。在带宽翻倍之前,本地「跑大模型」永远还有半句「跑得慢」。掏钱之前先问自己:这半句,你接受吗?









