今年 Agent 工程圈最火的词,不是哪个新模型,而是 Harness。
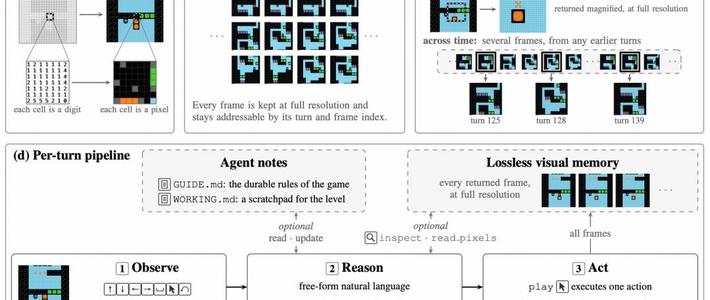
9 月 ARC-AGI-3 放榜,结果相当打脸模型原教旨主义者:同一个 GPT-6Astra、同样推理强度,放进标准 Harness 得分 62.7%,换成另一套 Harness 飙到 98.6%,而且考得好的那组反而更省钱,约 2.61 万美元降到 1.73 万。大脑没换,只换了干活方式,Agent 几乎变成另一个水平。几天后 YC 专门办了场分享,题目很直白:《Why the Harness Matters More Than the Model》。36氪
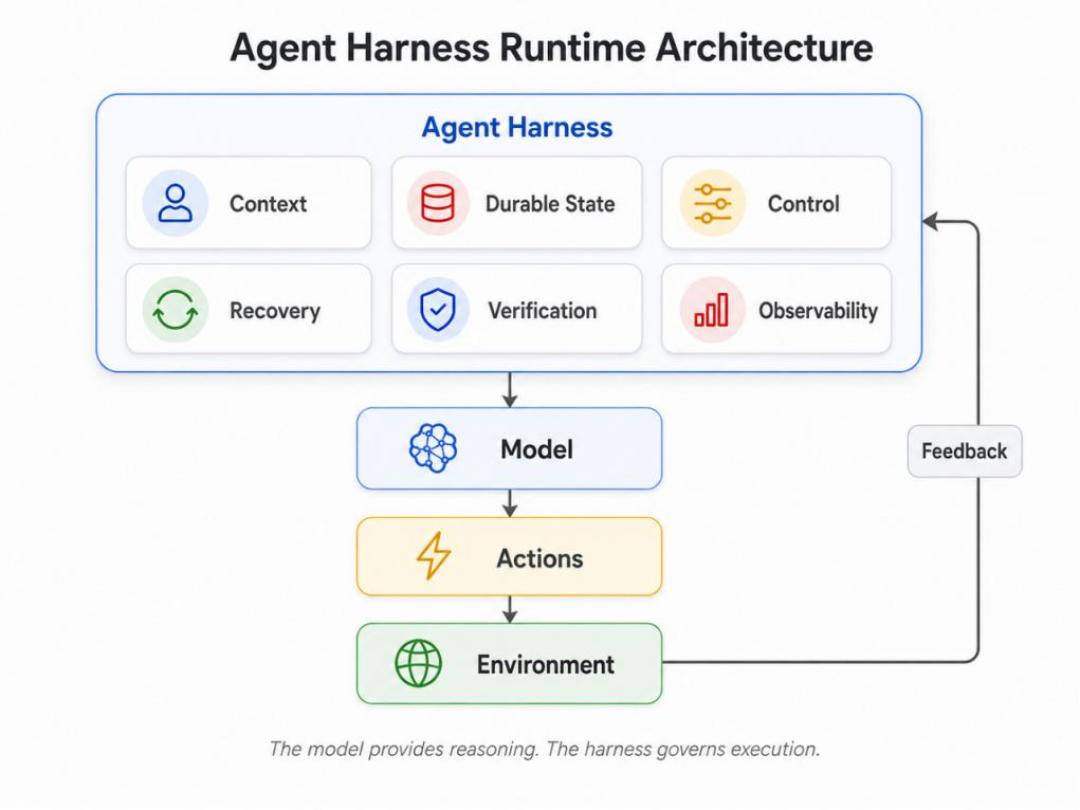
Harness 到底是啥? 英文本义是套在马身上、把马力传导到车上的那套马具。放到 Agent 语境里,它就是模型权重之外的一整套运行系统:系统提示词、上下文怎么拼、能调哪些工具、记忆放哪、子 Agent 怎么分工、什么时候停。Agent 干活时能看到什么资料、能不能接着上次继续,这些都不由模型决定,而由 Harness 决定。业内默认公式:Agent = Model + Harness,且 Prompt ⊂ Context ⊂ Harness。OpenAI Codex 团队一句话戳破真相:“Agents aren’t hard; the Harness is hard.” 不到十个人,5 个月,让 Codex 生成超过 100 万行生产级代码,没有一行是手写的。36氪知乎
这个东西三年换了三个名字:2023 年叫提示词工程,2025 年叫上下文工程,2026 年叫 Harness 工程。名字在换,考的一直是同一道题:这一轮,模型到底该看什么,不该看什么。知乎
失败案例库特别乐:Gemini 2.5 玩宝可梦,把复刻版的冰茶认成原版的柠檬水,写进上下文后绕不过去,原地打转好几小时;有公司给每位工程师的 Agent 一口气加载 600 个 skill,模型能力直接崩塌。Drew Breunig 把上下文失效归成四类:中毒、分心、混淆、冲突。结论很反直觉——模型越强,它的失败越不是因为“不会”,而是因为看到了太多不该看的东西。所以今年最难的工程课题是:让 Agent 学会忘掉。知乎
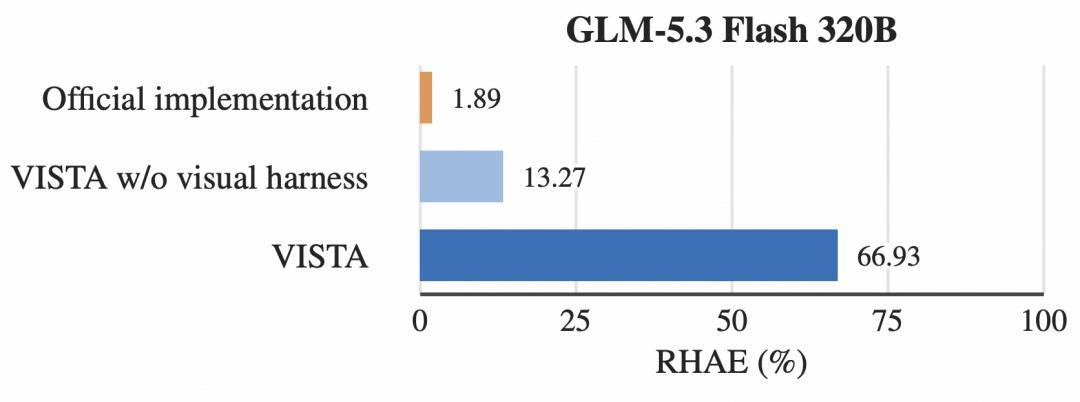
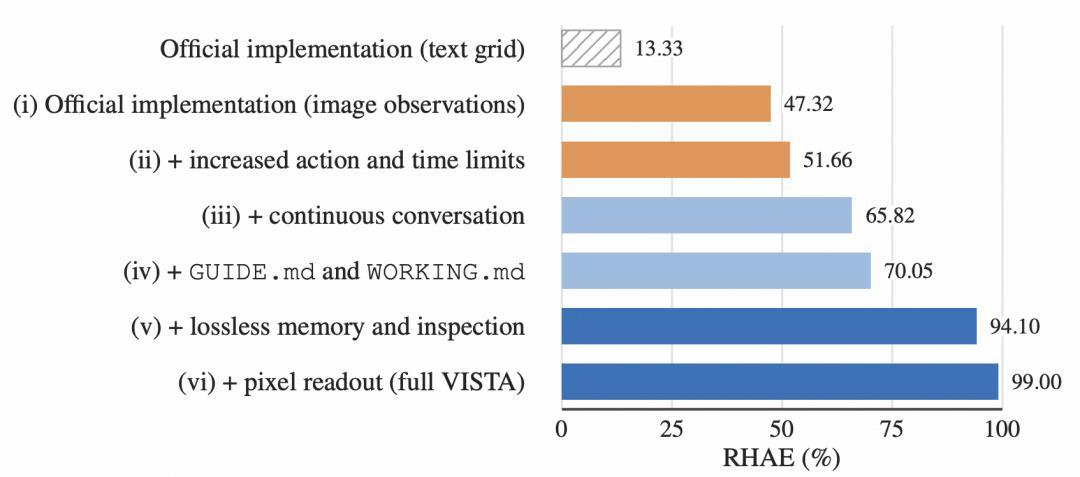
外壳的价值有多大?斯坦福 Meta-Harness 实验:固定模型,只自动搜索它周围的脚手架代码,结果同一个模型,仅更换脚手架,基准成绩最高拉开 6 倍差距。谷歌的 VISTA 消融实验画出了同一件事的阶梯版:每加一件 Harness 组件,成绩就往上实打实地走一截。知乎
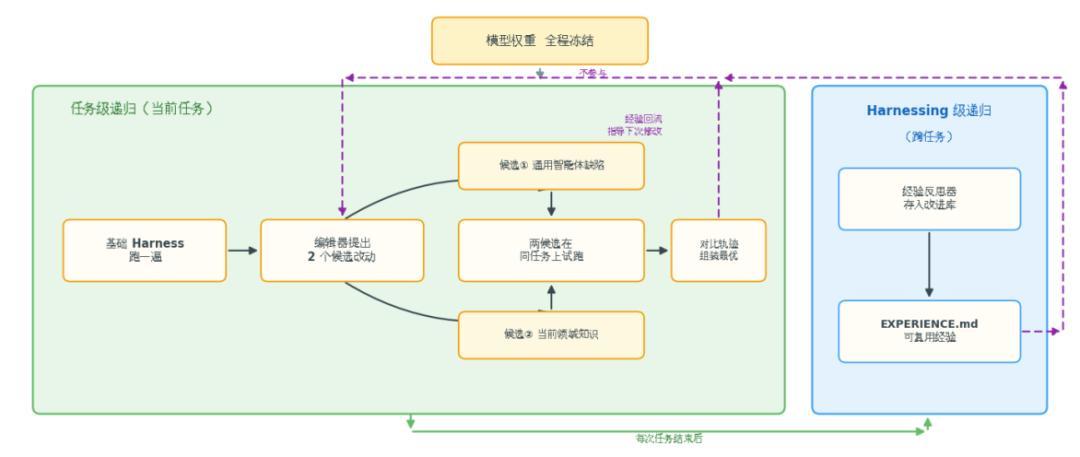
但反方声音同样清醒:Harness 工程可能刚流行就面临退潮。相当一部分脚手架是在弥补当前模型的短板,而厂商正把上下文压缩、任务拆分、状态恢复一点点做进原生能力;巨型 AGENTS.md 塞满规则,最后它就会从基础设施变成新的技术债。Anthropic 的提醒很锋利:Harness 编码的是“关于模型做不到什么”的假设,而随着模型变强,这些假设会过期。谷歌开源的 Harness² 走得更远:不动模型权重,智能体在执行中自己改写周围的提示词、工具、记忆等八个组件。脚手架的贬值速度,可能比很多人想象的快。知乎知乎36氪
普通工程师该怎么办?招聘市场已经先投票:面试官的感受是,纯 RAG、只会调用框架、做过几个个人 Demo Agent,基本过不了简历关。人人简历上都是 Skill、Agent Loop、Multi-Agent,拼的是你在一个问题上做得有多深。评论区老哥给出了更朴素的版本:让英雄去查英雄,“首先,你得有无限的 token”。所以门禁、预算、灰度上线,比堆规则实在。知乎小红书
模型决定下限,Harness 决定上限。知乎36氪
而对人的投资,要集中在不随模型能力变化的那部分:规格、台账、判据、治理记录。知乎