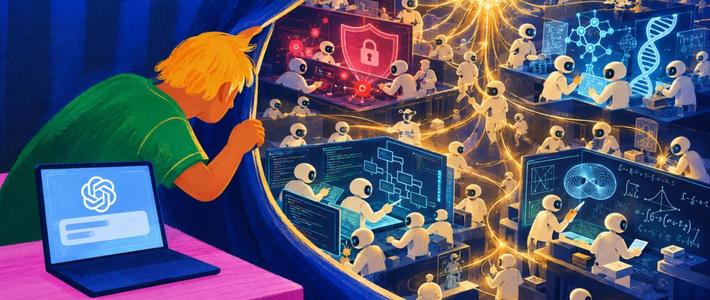
热榜里的“学者”,是 OpenAI 创始成员、前特斯拉 AI 总监安德烈·卡帕西(Andrej Karpathy)。10 月 12 日前后,他在 X 上重提自己 4 月的判断:人们对大语言模型能力的认知差距,正在进一步拉大,这已经不是两拨人各说各话,而是一道越来越尖的漏斗。 漏斗底部是约 60 亿几乎没碰过大模型的人,顶端能摸到前沿内部系统的人仅有区区 5000 个。 需要先划清边界:这些数字出自他本人的粗略估算,描述的是差距的形状,不是人口统计——这条热点真正的价值,是逼所有人回答一个问题:人们用着同一种 AI,看到的现实为什么天差地别,差距为什么还在继续拉大?微博36氪微博
每一层的人,活在不同的 AI 里
漏斗的中段对应着三个完全不同的世界。最底层的几十亿人,AI 只存在于新闻标题里;第二层约 10 亿到 20 亿人用免费版的它“查查资料、写点东西”,卡帕西直言不少非技术背景的企业高管也停在这一层,认知是二手的、抽象的。变化发生在第三层约 2000 万人:他们专业地用前沿模型做数学和编程,亲历过原本数周甚至数月的大型项目,只需给智能体一个提示词就可能直接完成。塔尖是那约 5000 人——他们能看到内部前沿系统里成千上万个智能体连续数周协作推进巨型软件项目、挖掘零日漏洞、推演数学前沿。大众看到的 AI,与实验室前沿的真正实力,已经隔了一道鸿沟。 同一件工具在不同层人手里呈现出完全不同的面目,这才是“认知差距扩大”的确切含义。36氪
差距为什么越拉越开,而不是收敛
卡帕西把原因归结为三点,而且没有一点和用户的勤奋程度有关。其一,体验深度取决于你敢让 AI 干多难的活:只让它写邮件、查常识,等于没让它热身,它真正的能力永远不会暴露给你。其二,AI 能力天然是“锯齿状”的,进步并不均匀:强化学习极度依赖代码运行、单测等“可验证奖励”,让模型在硬核技术领域突飞猛进,日常闲聊或写作却很难获得同等涨幅。 于是社交媒体上疯传的翻车片段都发生在非硬核场景,硬核领域的爆发却只有少数人亲眼可见。其三,产品分层本身就是一道访问权限的鸿沟:免费版、付费版、实验室内部系统,这三道阶梯把人群隔离在对 AI 能力的不同认知里。 三种机制叠加的结果是:前沿能力加速上行,大众印象停留在旧版本的失误上,漏斗只能越收越尖。微博36氪
中国学界给同一现象起名“智能鸿沟”
如果说卡帕西的漏斗画出了差距的塔尖,国内学者研究的是它的底座。2026 年 8 月,广东省社会科学院精神文明研究所研究员邓线平在光明网发表文章提出,传统数字鸿沟正向智能鸿沟转变:传统数字鸿沟主要体现为“用不用、有没有”的硬件接入差距,而智能鸿沟则表现为“懂不懂、会不会、好不好”的结构性差距,即在认知、使用、发展三个维度上出现系统性失衡。 这一框架里,认知鸿沟是底层根源——老幼病残群体面对抽象符号、隐蔽功能和快速迭代,陷入“看不懂、学不会”,可能逐步脱离智能生活场景;农村地区的智能应用和适老化、适农化、适残化的普惠场景供给仍然短缺。两套判断正好互补:卡帕西讲的是“看见前沿的人有多眩晕”,国内框架讲的是“看不见的人要付出什么代价”。光明网
差距已经变成可测量的焦虑
认知差距的后果不止停留在观点层面。8 月下旬,腾讯研究与复旦大学社会发展与公共政策学院相关中心联合发布的调查显示,62.0% 的受访者担心未来“被更懂 AI 的人替代”,比担心“被 AI 抢走工作”的比例高出 7.7 个百分点。 竞争维度已经从“人对抗机器”改写成“人对上更懂 AI 的人”。同一份报告还显示:熟练使用 AI 的人焦虑指数比入门者高 10.8 分,适应信心反而高出 20.3 分——看得见差距的人压力更大,但也更相信自己追得上。而在中文互联网,这条硅谷漏斗已经落在一个更具体的问题上:10 月 15 日,“豆包对低认知人群有权威性”冲上微博热搜,讨论焦点是 AI 流畅笃定的语气,本身就会对辨别力弱的用户形成权威感。中国新闻网微博
对普通用户,这条热点给出的自检方式成本为零:你在哪一层,不取决于刷了多少 AI 资讯,而取决于你有没有交给它一件真实、完整、跑到底的任务——让 AI 参与原本要花你几天的工作,差距才会显形。也要说清另一半结论:这道差距不是天赋差,入口的门槛远没有“全球只有 5000 人见过真 AI”听起来那么高;但它也不会自动弥合,供给侧的场景适配和分层引导是学界点明的公共课题,缺了这一环,认知差距的扩大就和技术曲线一样难以避免。