

11月12日,前 OpenAI CTO Mira Murati 创办的 Thinking Machines 把 Inkling 2 Small 的权重放上了 Hugging Face。名字里带 Small,实际 594B 总参,官方推荐的 NVFP4 版本要 500GB 显存起步——两张 B300,或者四张 H200。单卡和笔记本,当时压根不在讨论范围里。小红书
八天后,同一家公司放出了 Inkling 2 Mini。这一次,主权重是一个 19.53GB 的文件,整个仓库 20.19GB,协议 Apache 2.0。哔哩哔哩
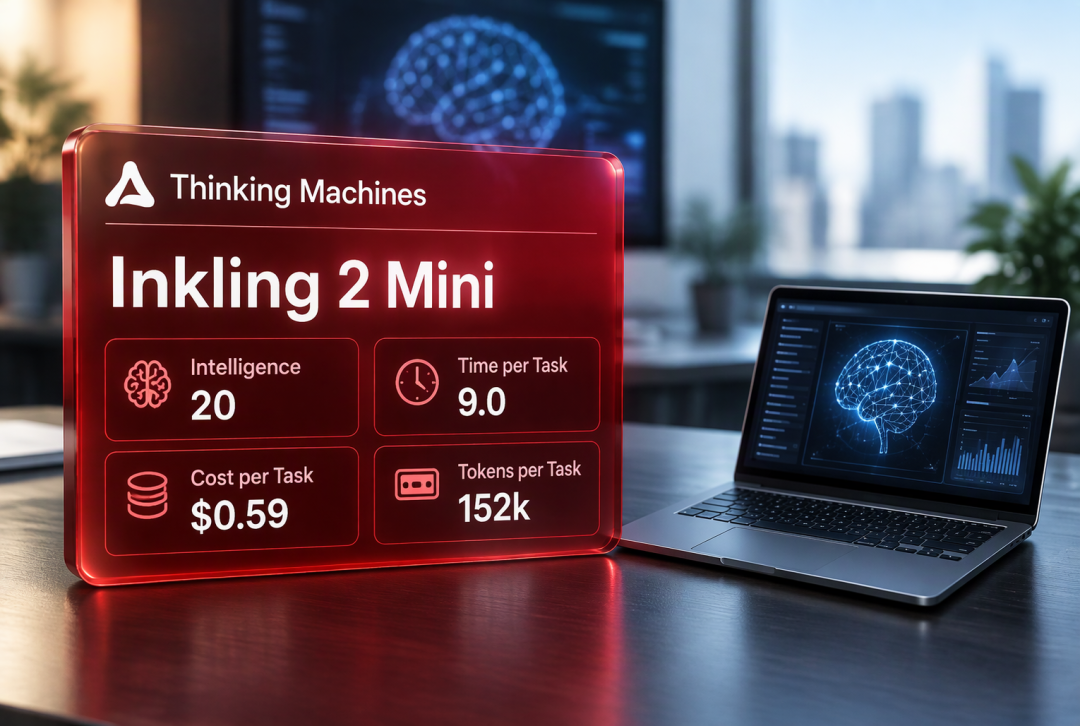
20GB 是怎么装下 26B 的
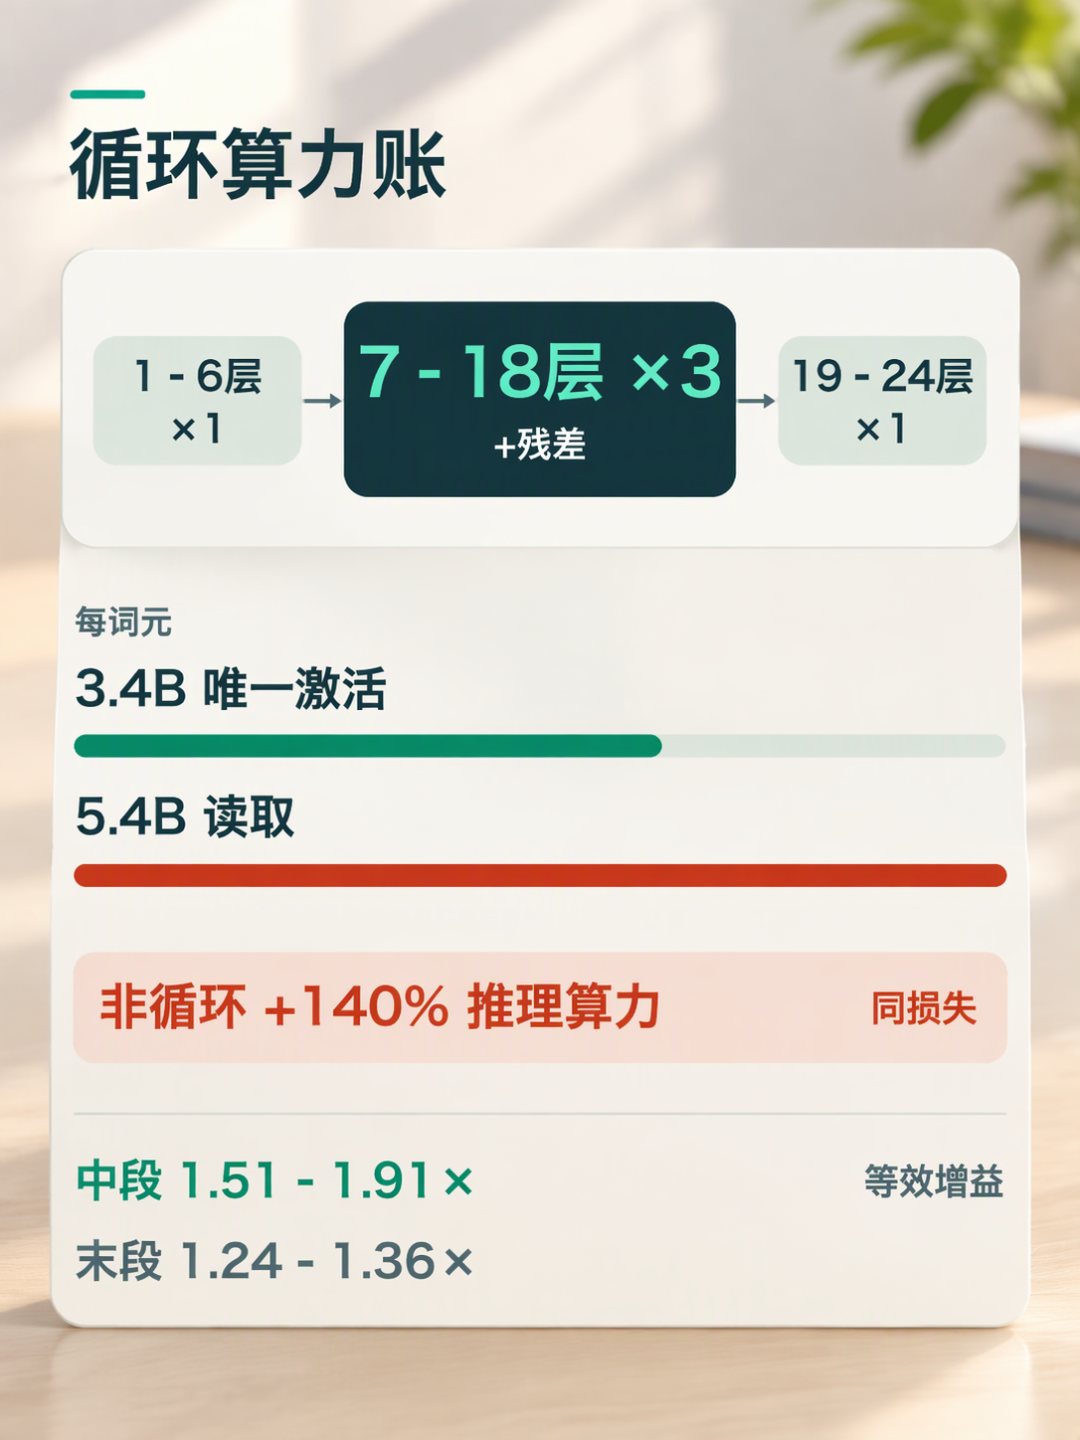
它没有砍参数,是让模型把同一道题想三遍。
物理只有 24 层,中间 12 层循环跑 3 次,计算深度等效 48 层;总参 26.4B,每个 token 只激活 3.4B。低比特也不是事后量化:前 20 层原生 NVFP4(4bit)训练,后 4 层 MXFP8,官方说几乎不掉点。小红书哔哩哔哩小红书
消融数据更直白——在 512K 的 Agent 轨迹上,非循环的基线要多花 140% 推理算力,才能追到同样的 loss。小红书
对本地党来说,这条路线的意义是:用计算换参数,而不是把钱换成显存——不把模型养得更胖,只让它把题想得更透。小红书
内存门槛分了三档。32GB 内存的 Mac 可以直接跑官方权重(Ollama / GGUF),DGX Spark 同样在支持列表里。Unsloth 的 GGUF 量化版让 16GB 内存的机器也能跑,条件是收窄上下文、先别喂图。再往下就是量化档的取舍:4-bit 的 UD-Q4_K_XL 是 17.63GB,对照 8-bit 参考档的 token 一致率 98.0%;压到 8.49GB 的 UD-IQ2_XXS,一致率掉到 90.6%。哔哩哔哩小红书哔哩哔哩小红书
跑分很猛,官方自己先泼了冷水
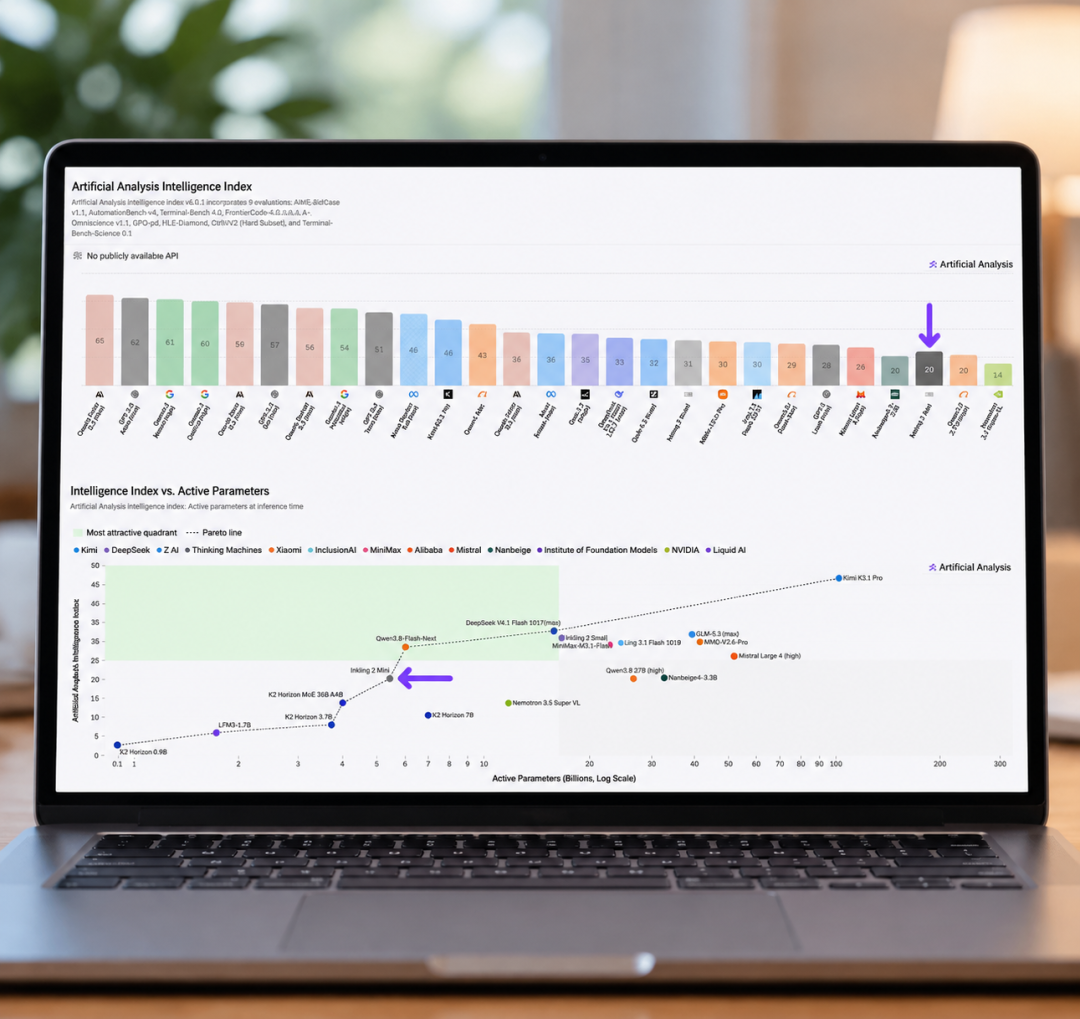
编程和 Agent 这块,它确实把同档位打穿了:DeepSWE v1.1 拿到 48.2%,Qwen3.8-27B 是 42.2%;SWE-bench Pro v2 Hard 77.9%;AA Index 20.1 分,和 Qwen3.8-27B 持平。小红书哔哩哔哩
第三方评测机构 Artificial Analysis 把它放进了“智能 vs 激活参数”的帕累托前沿,Intelligence Index 得分 20。小红书
但模型卡里的 Limitations,写得比跑分诚实。
循环只能提升多步推理和长上下文检索,不会让权重里多记住任何东西——事实性那一项 AA-Omniscience,官方给的数字是 -8.6;多轮复杂约束也打不过 27B 稠密模型,MultiChallenge 50.0%,ComplexConstraints v1.1 只有 33.4%。官方页面另外提醒了两件事:中文输出有时会被截断或混进英文,本地要用的工具链目前还是预览版。翻译成人话:这是个要外接工具干活的模型,不是一本离线百科。哔哩哔哩小红书
现在还该不该下
有个坑得先说清楚:循环架构省的是参数,费的是带宽。每个 token 唯一激活 3.4B,但同一批权重要读三遍,等效读取 5.4B,单请求解码更容易卡在带宽上。小红书
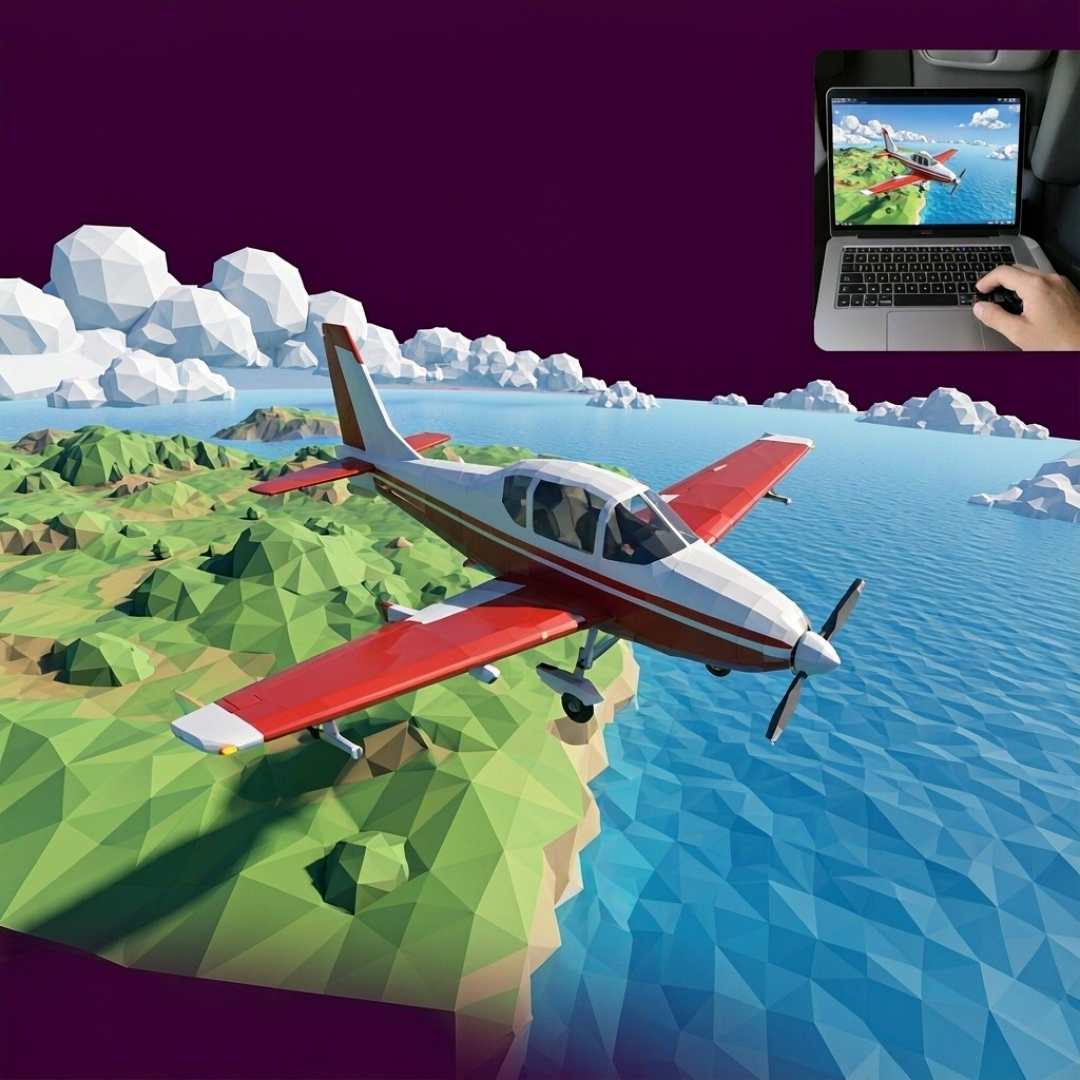
而目前能查到的速度线索,只有官方那一场演示——M5 Pro 48GB 笔记本开飞行模式,现场写出一个能玩的 3D 飞行模拟器,外加一个 20 村民的像素小镇。B站评论区有人说出了大家的疑问:“20G 的整包权重加 Apache 2.0,这个组合对本地党确实太友好了,就是不知道拿普通笔记本真跑起来能到几个 token/s。”哔哩哔哩
所以建议分两种人。
32GB 内存的 Mac,今天就可以拉 4-bit 档试,但别拿跑分当预期,直接喂你自己的活:代码库、长文档、接上搜索,这是它的主场。
16GB 内存的,或者想拿它当离线问答机的,先等两件事——社区实测的 tok/s,以及循环层支持从预览版转正式。至于闭卷答事实、盯十几条格式约束写中文长文,27B 稠密模型眼下还是更稳的那个。小红书
八天,从 500GB 显存集群到 20GB 单文件。本地部署的门槛确实在塌,只是塌下来的那块,官方已经提前告诉你踩上去会晃。
当前文章无评论,是时候发表评论了