




 深耕数码、汽车、AI兴趣领域


3
2
DeepSeek V5或用华为昇腾,这次真要动英伟达的蛋糕了?
2026-11-05 10:45:01
0点赞
0收藏
0评论
对于一家大模型公司来说,什么东西最昂贵?是动辄数万张的GPU,还是被显卡耽误的模型迭代时间?
 deepseek插图.png
近日,DeepSeek V5计划采用华为昇腾芯片进行预训练的消息冲上热搜。然而用国产芯片训大模型,早就不是头一回。早在今年6月,美团LongCat-2.0就在五万卡国产集群上完成了从零预训练;科大讯飞星火X2.5也确认,训练和推理都用国产算力。那既然有人跑过,DeepSeek这次为什么还受人关注?
小编的看法是:跑得通和跑得划算,是两码事。
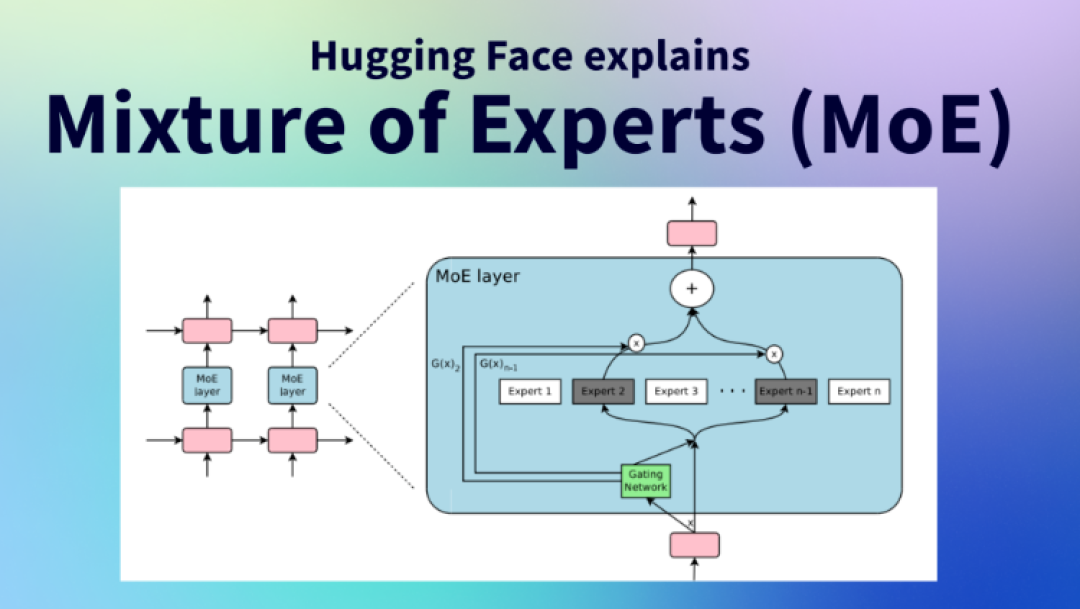
首先,大集群不是卡堆得越多越好。MoE模型每次处理数据,只激活一部分“专家网络”;可这些“专家网络”分散在不同芯片上,数据就得跨卡来回传。通信一旦跟不上,卡再多也只能干等。集群越大,故障恢复、任务调度越麻烦。这些事不显眼,但很吃时间。
 微信图片_20261104175204_16_186.png
更麻烦的是软件生态。CUDA攒了这么多年,英伟达的壁垒远不止单卡性能这么简单了。算子库、编译器、通信框架,以及出问题后能不能快速找到成熟的解决方案等等。都会落到最终的研发效率上。
 英伟达.jpg
所以,国产算力平台眼下要补的课,一是集群调度效率,二是软件生态。DeepSeek也清楚这一点。
所以在今年9月底,DeepSeek开源了面向昇腾平台的TileLangP等基础设施组件,相当于从底层软件开始适配。这些事虽不如万卡集群响亮,却决定训练能不能顺利往下走。
 Deepseek开源2.jpg
毕竟,如果每家模型公司用国产芯片,都得自己拉班子重做算子、通信和训练流程,那这个项目就算跑通了,也很难让别人跟着用。国产算力要抢的,正是这块市场。
因为对于真正做大模型的企业来说,支持国产算力是一回事,能不能用合理的成本持续训练出有竞争力的模型,则是另一回事。
而这,才是DeepSeek V5接下来最值得关注的地方。
作者:段多美