










 深耕数码、AI、游戏兴趣领域




20
25
YOGA Pro 15 RTX Spark评测:本地AI性能拉满,创作游戏全兼顾
2026-10-16 14:47:23
0点赞
0收藏
0评论
随着RTX Spark笔记本正式开卖,一款全新的笔记本品类正式进入消费者的选择范围。RTX Spark打破了两个领域的壁垒,一个是Windows on Arm硬件在过去很长时间中没有任何性能强劲硬件,另一个则是端侧AI设备长时间依赖受众较小的Linux或者macOS系统运行。是的,一款既能普遍适配Windows程序、Steam游戏,并且机身轻薄,续航表现,GPU媲美独显的笔记本就此诞生。
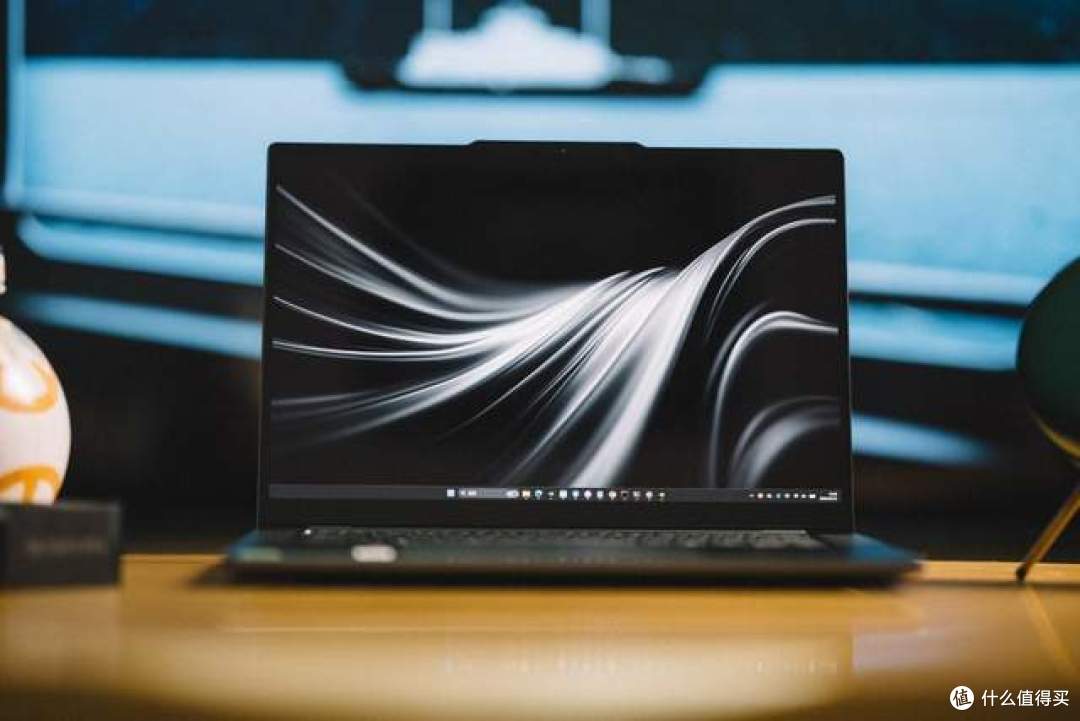
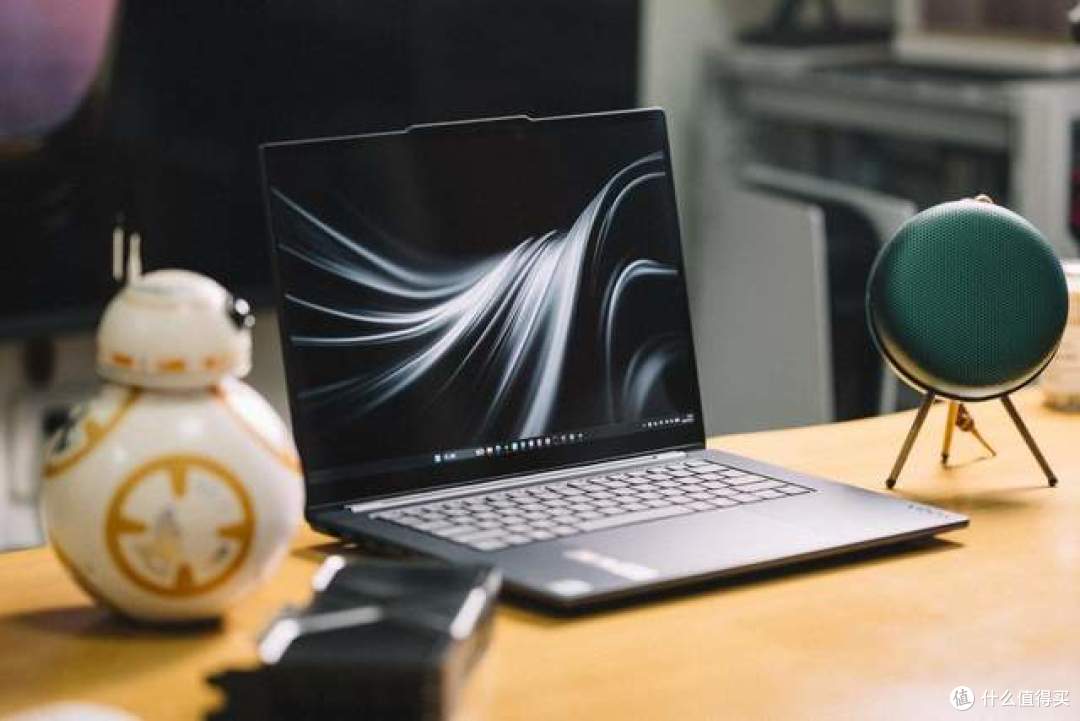
联想 YOGA Pro 15 RTX Spark笔记本正是首发RTX Spark产品中非常值得关注的一款,它采用NVIDIA RTX Spark N1X超级芯片,最高拥有20核的CPU,6144个CUDA核心的GPU,以及最高128GB LPDDR5x 9400MT/s统一内存,并且用上了2TB SSD,165Hz刷新率的15.3英寸OLED触控屏,完完全全是顶配微软Surface Laptop Ultra的联想版。
在此之前,我们已经进行了联想YOGA Pro 15 RTX Spark的开箱。并且在这篇评测上线的同时,同步更新了上万字的《RTX Spark笔记本浅析》,这里让我们直接专注于笔记本的测试结果,重点看看NVIDIA RTX Spark N1X超级芯片的性能究竟如何。
游戏:轻松100FPS+
先说大家最关心的游戏。虽然统一内存带宽相对独显GPU有所压缩,但是联想 YOGA Pro 15 RTX Spark运行游戏也是毫无压力的。老规矩先上3DMark。
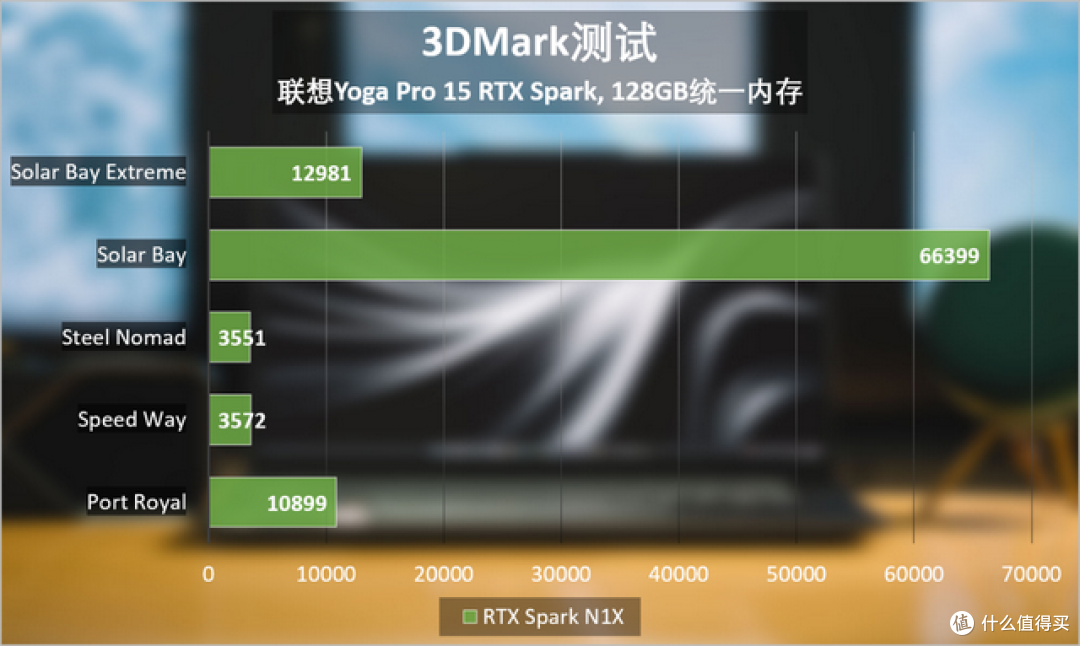
RTX Spark拥有完整的Blackwell GPU技术,因此光线追踪、路径追踪、DLSS 4.5和DLSS 5都提供了完整支持。同时依靠笔记本的性能,创作者可以在RTX Spark笔记本上实现RTX Remix老游戏重置,以及NVIDIA ACE这样的本地运行辅助对手。
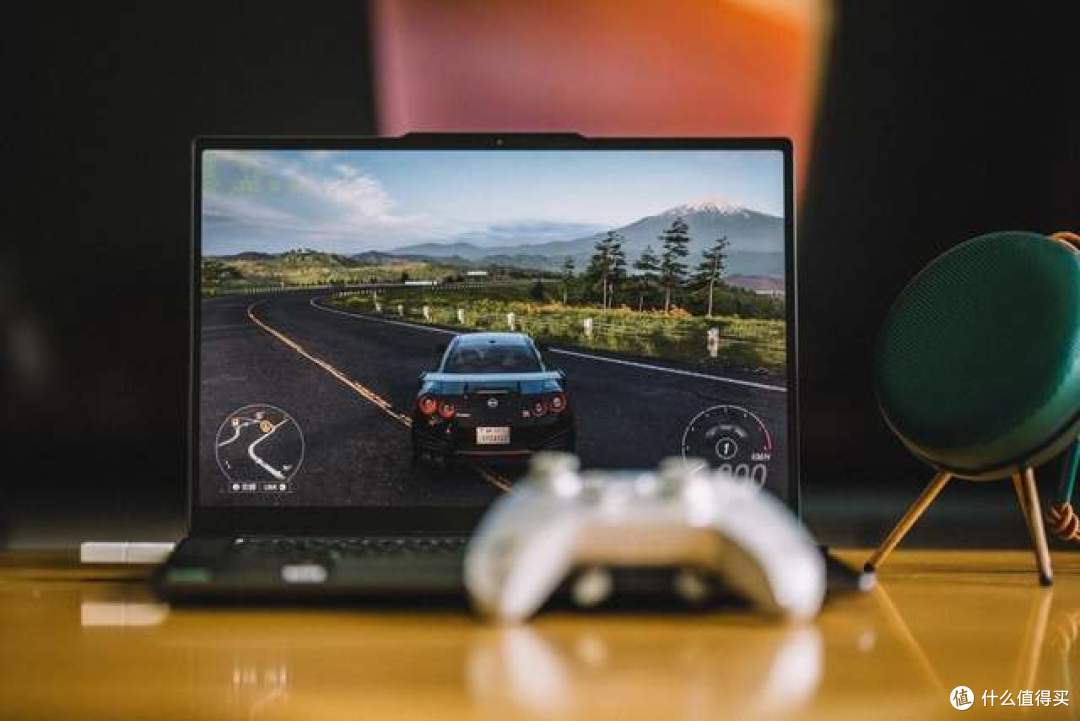
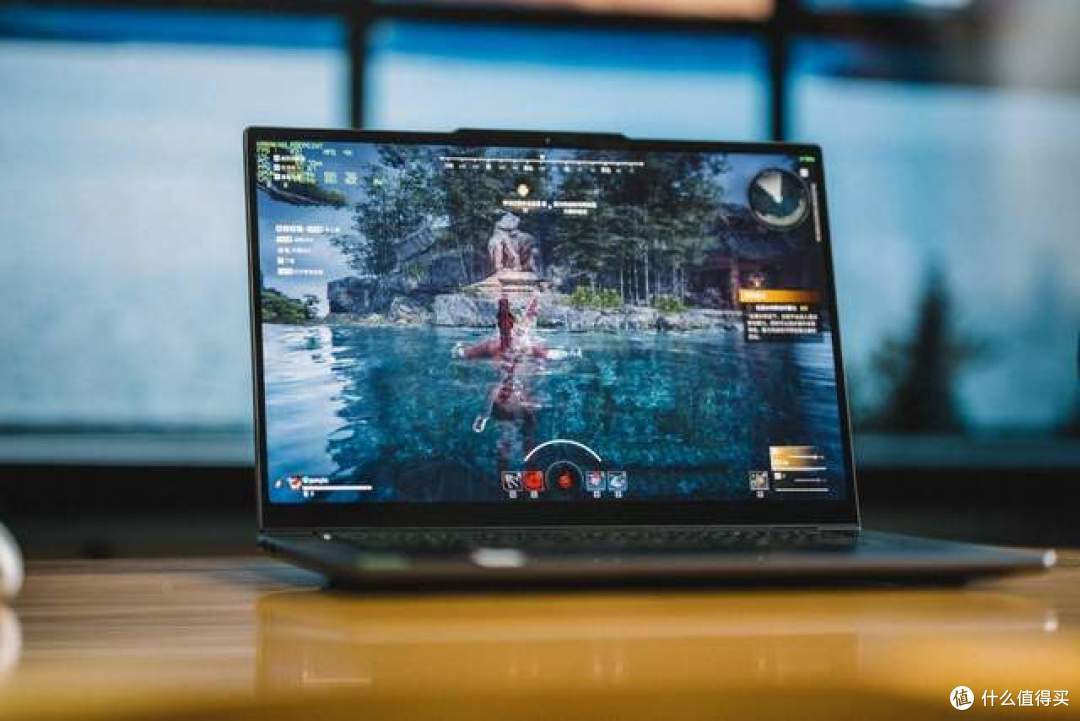
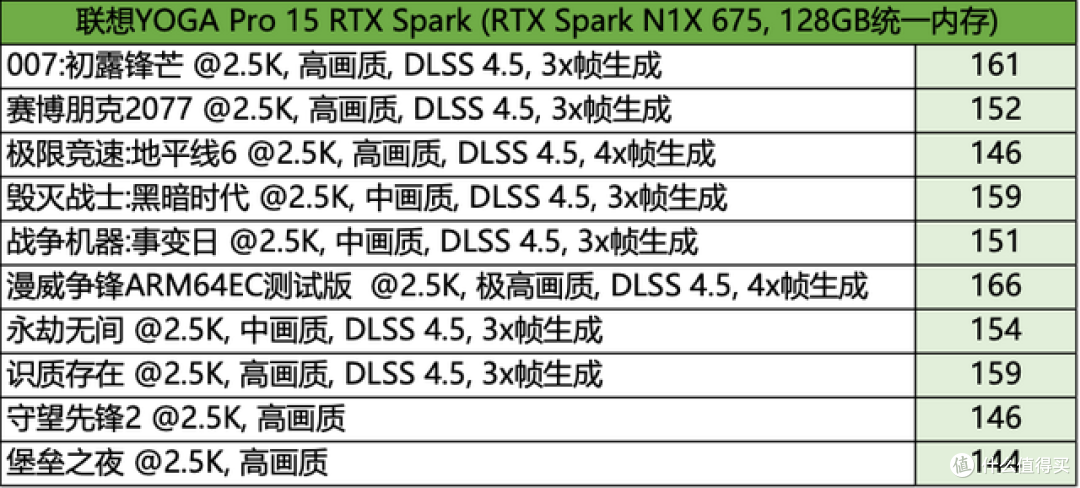
在实际游戏体验中,我们使用联想 YOGA Pro 15 RTX Spark屏幕的2560x1600分辨率,DLSS平衡档,选择3倍或者4倍多帧生成,目的是吃满笔记本的165Hz刷新率,当然也可以最高开到6倍多帧生成,将帧率进一步拉高,只不过超出屏幕显示范围,基本没有什么收益。
这里我们先对《漫威争锋》进行测试,感谢网易给我们优先提供了ARM64EC Beta版本。在2.5K分辨率,最高预设下,开启DLSS 4.5,以及4倍多帧生成,游戏帧率可以做到160FPS以上。
重点是,我们在联想 YOGA Pro 15 RTX Spark插电和不插电状态下,对《漫威争锋》前后进行了对比,RTX Spark N1X整体功耗都是稳定在50W左右,远没有达到80W的上限,游戏帧率稳定在160FPS左右。
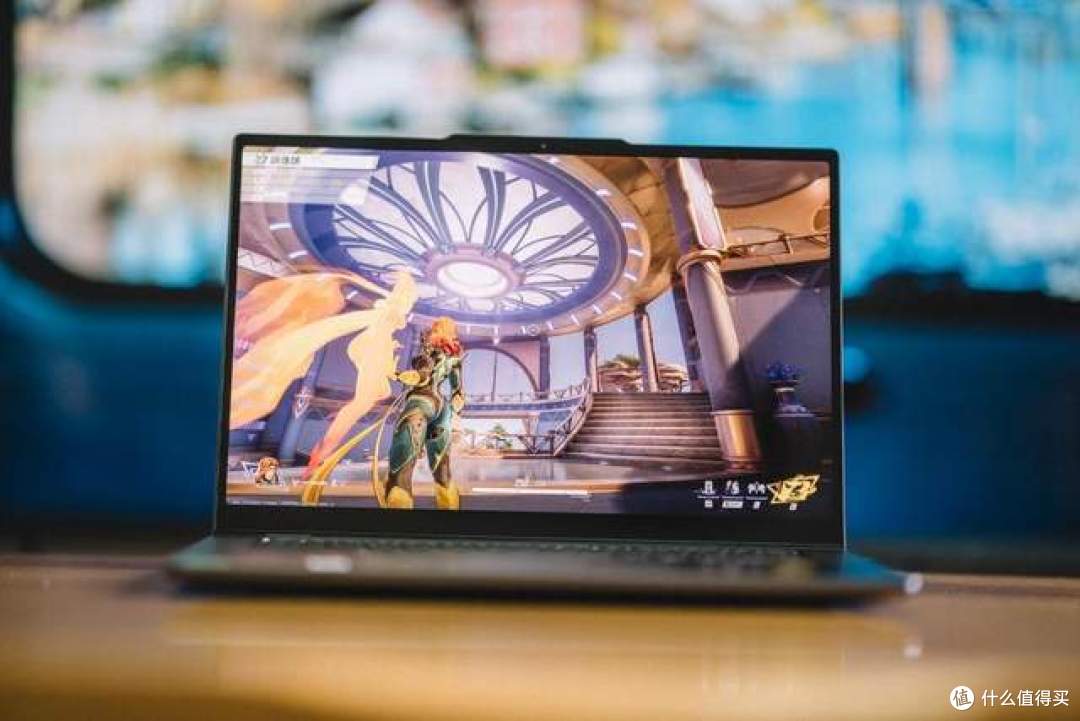
更重要的是,RTX Spark目前已获得15家反作弊方案的原生支持,包括Easy Anti-Cheat、BattlEye、Denuvo Anti-Cheat、Anybrain、Elytra、Valve VAC、nProtect GameGuard、XIGNCODE3、Hyperion、Viking、HoYoKProtect、网易游戏安全、Nexon游戏安全,以及我的世界基岩版和僵尸毁灭工程的内建反作弊。
意味着诸如《反恐精英2》《彩虹六号:围攻》《漫威争锋》《绝区零》等多人游戏已经可以正常游玩。同时包括动视、Riot、腾讯ACE、EA Javelin以及PUBG相关的反作弊支持已经蓄势待发。如果你是《无畏契约》《英雄联盟》《使命召唤》的重度玩家,那么可能需要再等上一段时间。
另外我们对数款游戏进行测试,罗列对比。
在游戏状态下,我们也对笔记本的发热和噪音进行了测试。联想 YOGA Pro 15 RTX Spark的模具应对RTX Spark N1X的极限80W功耗没有任何问题。在24℃的环境温度下,键盘、触控板均保持清凉,出风口在笔记本下方。
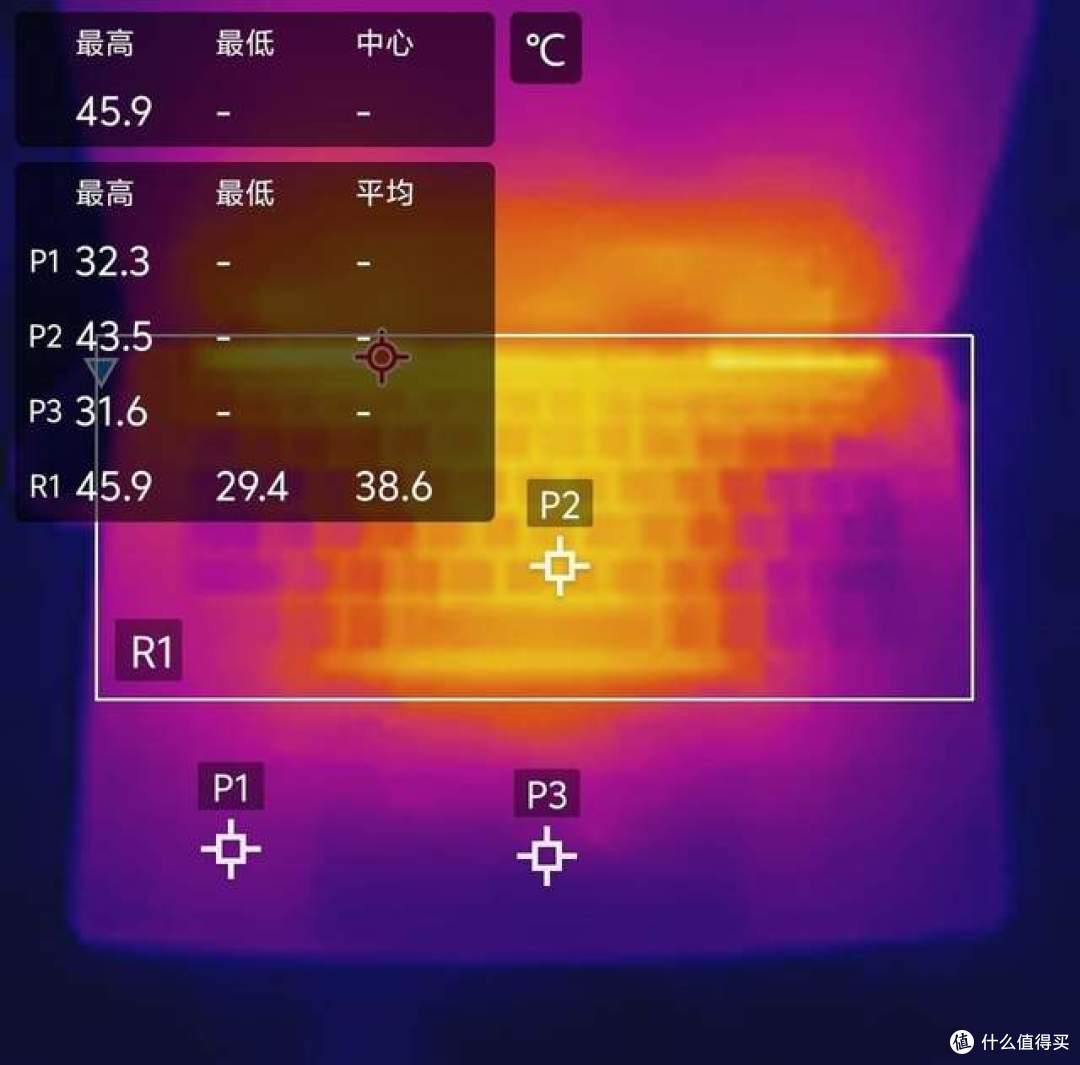
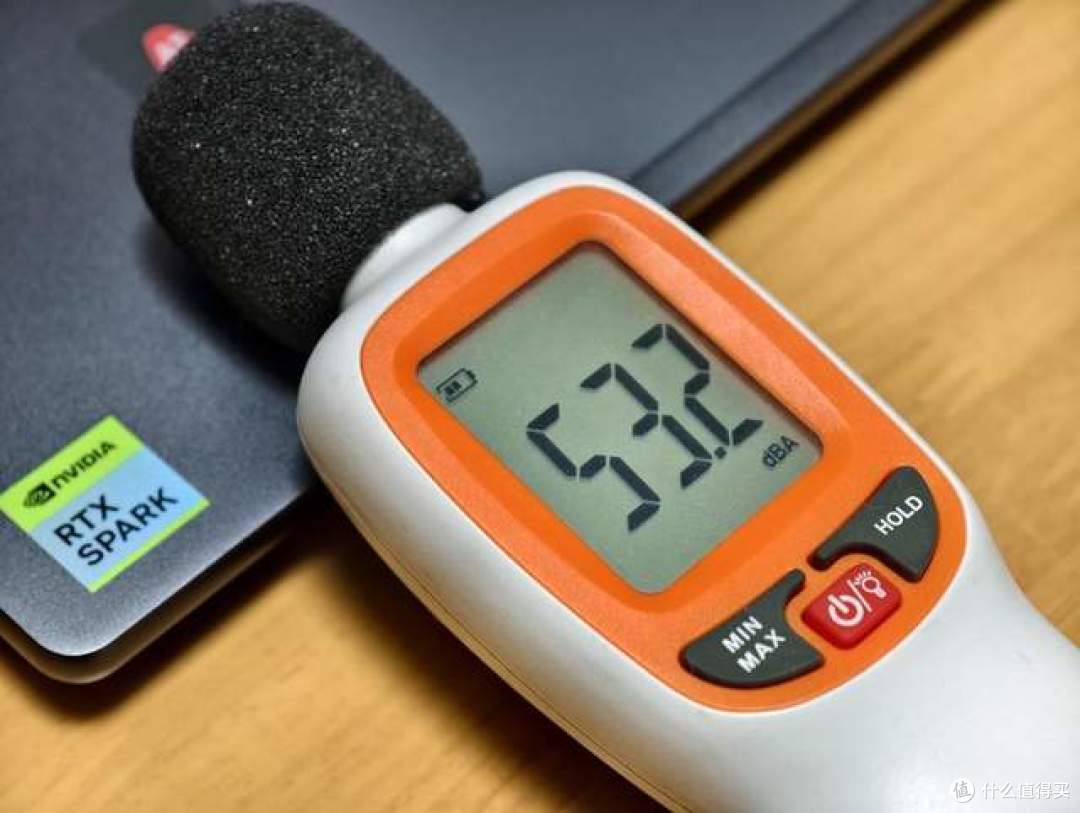
噪音浑厚不刺耳,53dBA属于有噪音,但是不戴耳机也不会受到影响的范围,比大多数独显笔记本运行噪音都要低。
由于笔记本可以离电全速运行游戏,我们也尝试离电运行《漫威争锋》,内置92.5Wh高密度电池可以支持我们游戏运行3小时左右。如果是日常工作,Windows on Arm不错的供电管理,实际可以让笔者坚持8小时的日常文档办公。事实上这篇文章就是笔者在联想 YOGA Pro 15 RTX Spark完全离电下完成的。
本地AI与智能体:海量内存就是爽
这个章节我们重点测试RTX Spark N1X主推的端侧AI性能表现。本地AI与智能体的核心是由本地部署的大语言模型,例如Llama、Qwen等,搭配RTX Spark这样足够算力的硬件,再加上工具调用与记忆管理框架进而实现自主决策与任务执行。这里我们使用llama.cpp加载Qwen3.8-27B Q4_K_M量化,外加DFlash投机解码草稿模型,进而构成一整套测试环境。
事实上,量化精度、是否启用投机解码、上下文长度、GPU 内存分配比例等任何一项改变之后成绩都不可对比,这个部分我们更倾向于展示现有阶段RTX Spark的表现。正如我们架构浅析时所言,本地模型的功能表现与云端头部模型距离可能只有4到6个月的时间,越往后,RTX Spark笔记本的端侧AI功能会变得更易用,效率也更高。
需要说明的是,参与测试的联想 YOGA Pro 15 RTX Spark笔记本为顶配版,拥有128GB统一内存,这意味能实现64GB版本机型无法做到的超长上下文场景,例如分配78GB统一内存实现Qwen3.8-Flash-Next测试。不过实际的响应速度仍然取决于RTX Spark中GPU的表现,内存的多少更多是决定模型的规模。
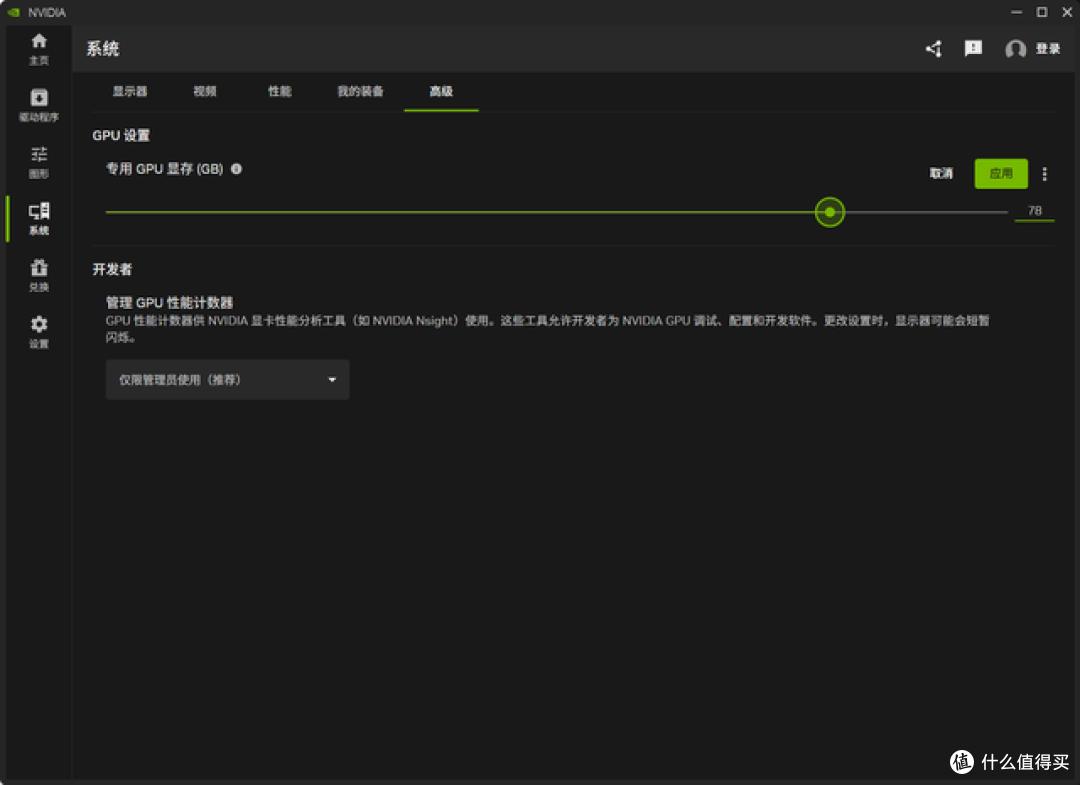
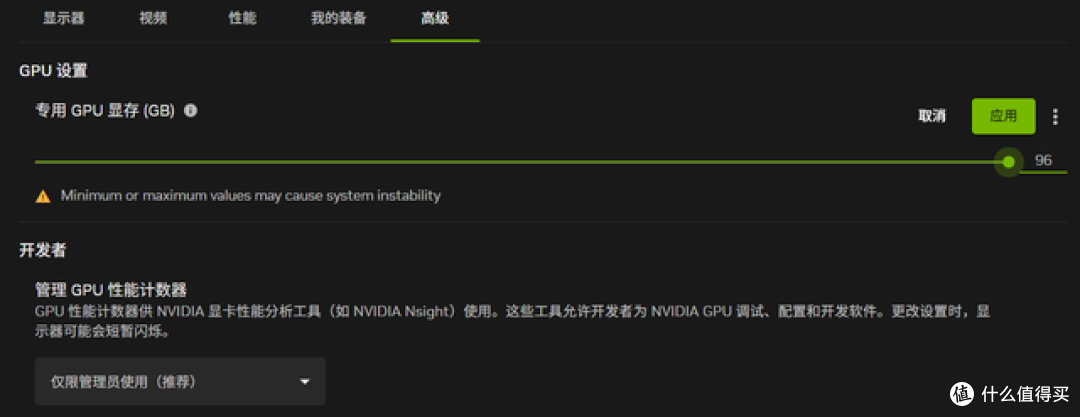
当然,更猛的是直接扩展到96GB,这是富裕的象征。
AgentPerf Local是Artificial Analysis 推出的本地智能体性能基准,把真实AI智能体在SWE-bench和PinchBench上解题的完整运行过程录成轨迹,在PC上原样回放,包括168轮、约250万输入 token、3.1万输出token,进而检测整套 agentic工作流的端到端耗时而非单轮问答速度。结果以归一化端到端完成时间和解码速度(tok/s)呈现。
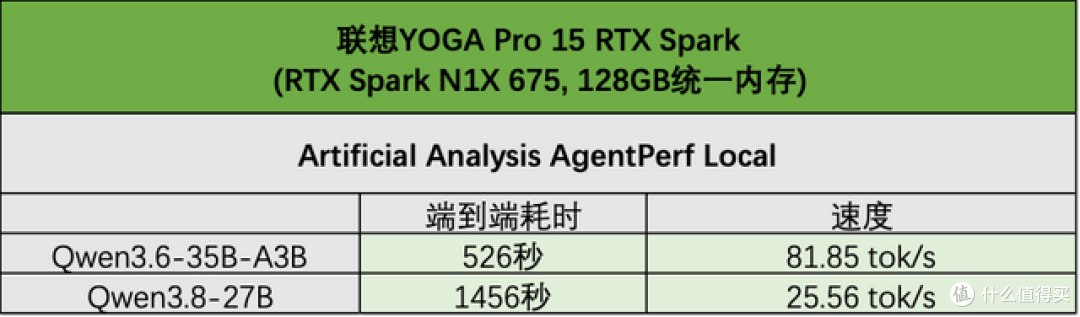
在实际测试中,联想 YOGA Pro 15 RTX Spark表现不错,Qwen3.8-27B端到端耗时1456秒完成,速度25.56 tok/s。同时Qwen3.6-35B-A3B端到端耗时526秒,速度81.85 tok/s,这个表现优于NVIDIA给出的官方指导参考,可进一步证明RTX Spark N1X的释放潜力,以及联想 YOGA Pro 15 RTX Spark有不错的性能释放。
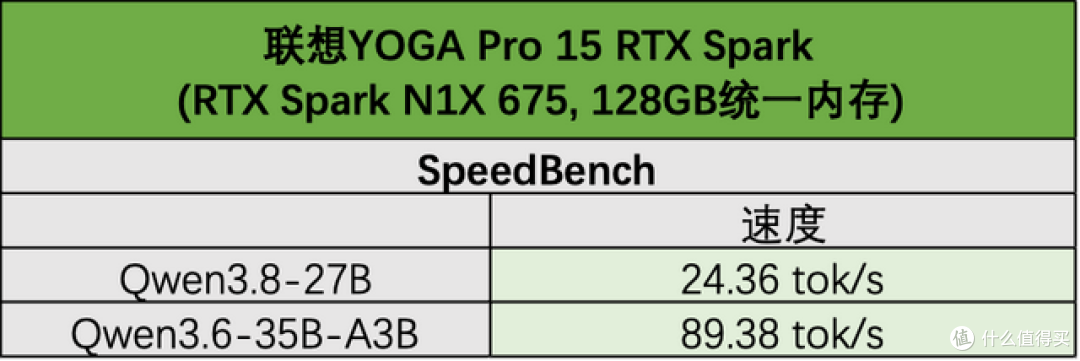
SpeedBench通过编程、问答、多语言等类别的真实语料数据集,配合MTP多token预测测纯解码速度来反映真实性能。
这里联想 YOGA Pro 15 RTX Spark在Qwen3.8-27B中可以做到24.36 tok/s,Qwen3.6-35B-A3B可以做到89.38 tok/s。这部分统一内存容量不会对测试造成太多影响,主要考验内存的带宽瓶颈。
AIPerf ISL/OSL做的是经典的输入/输出长度扫描,通过16k/32k/64k的输入,强制输出1k,测试首次token延迟(TTFT)和端到端时间。虽然这个测试对现代多轮agentic场景代表性有限,但它是唯一能把预填充(prefill)性能单独暴露出来的项目,而预填充吃算力不吃带宽。
这里得益于联想 YOGA Pro 15 RTX Spark使用的是满配版的6144核GPU,算力会直接在TTFT上展现。
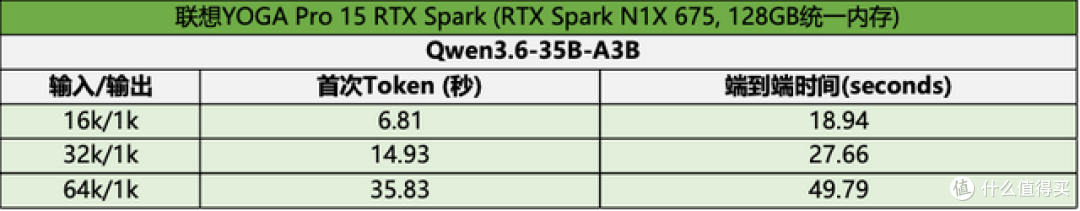
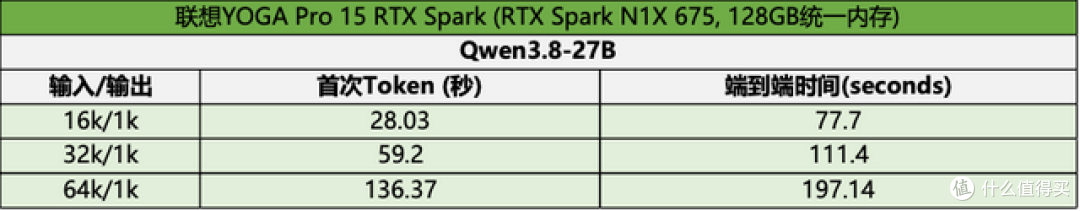
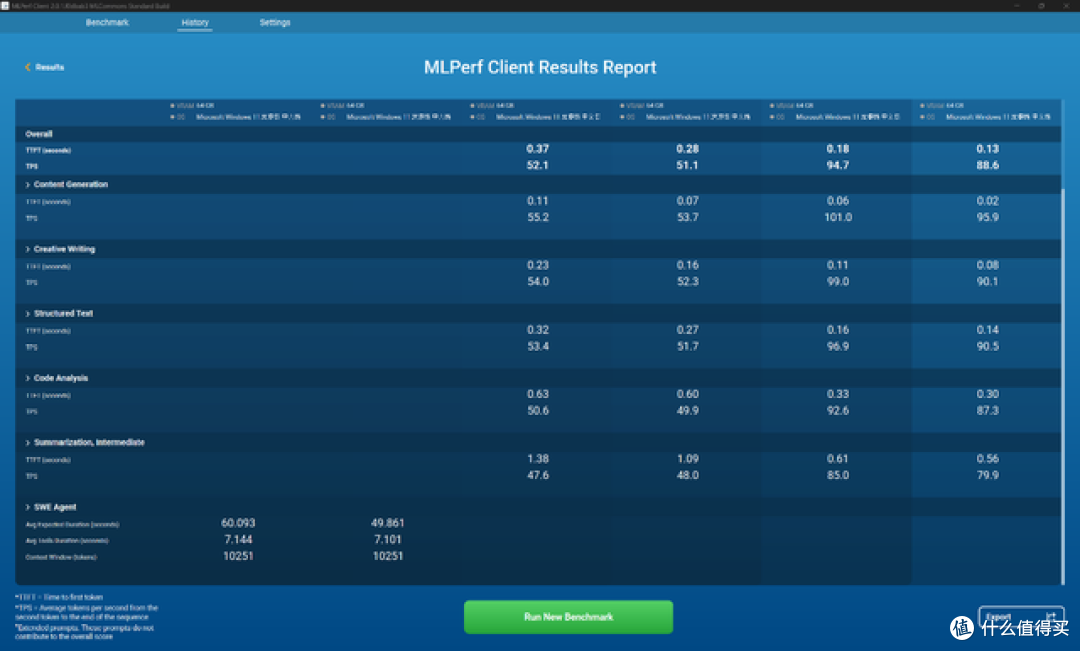
MLPerf Client 2.0.1则是测试中标准化程度最高的一个,它由MLCommons开发,主要进行4轮的短agentic循环,以及FLUX.2 Klein图像生成。这里是联想 YOGA Pro 15 RTX Spark的强项,得益于Blackwell天生对NVFP4的原生支持,图像生成性能也很猛一些。虽然目前我们还没有测试同级别的RTX Spark机型,但通过前面的测试来判断,有理由认为联想 YOGA Pro 15 RTX Spark的性能释放是充足的。
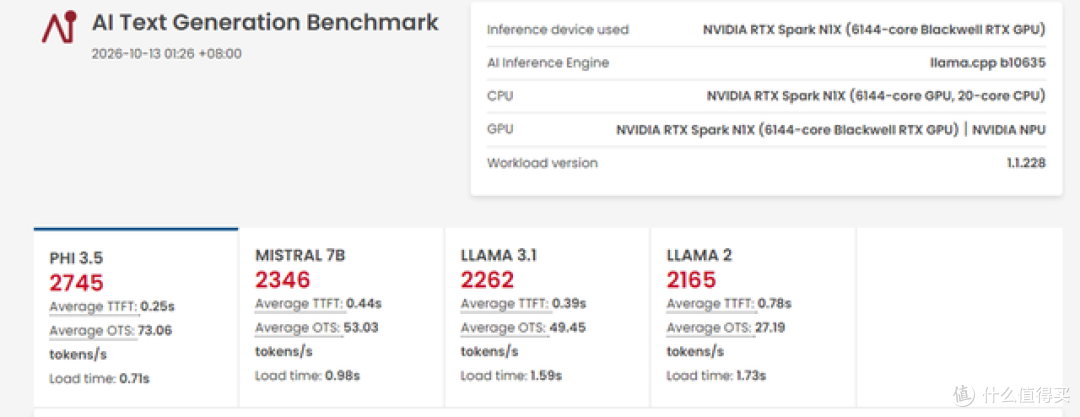
喜闻乐见的UL Procyon主要执行文本生成进行测试,文本生成测试在推出之初对于大量的独显笔记本已经是沉重的负担,但是对于拥有海量KV Cache的RTX Spark笔记本电脑而言,已经不是任何问题,13B甚至还差点意思。
实际测试中,联想 YOGA Pro 15 RTX Spark表现优于NVIDIA给予的参考指导,也进一步证明了这款笔记本的性能释放更猛一些。
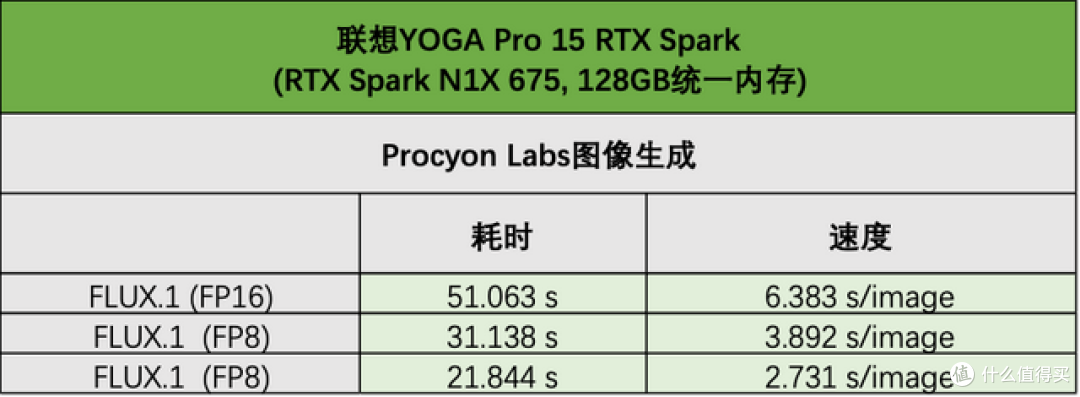
图像生成对于联想 YOGA Pro 15 RTX Spark而言也毫无压力,这里参考Procyon的FLUX.1 Demo测试,因为这项测试可以分别使用FP4 / FP8 / FP16进行对比, 其中FP16硬件要求至少要有35GB显存才能实现,FP8需要23GB,FP4只需要15GB。从速度来看,FLUX.1 FP4着实快上不少,也更省显存。
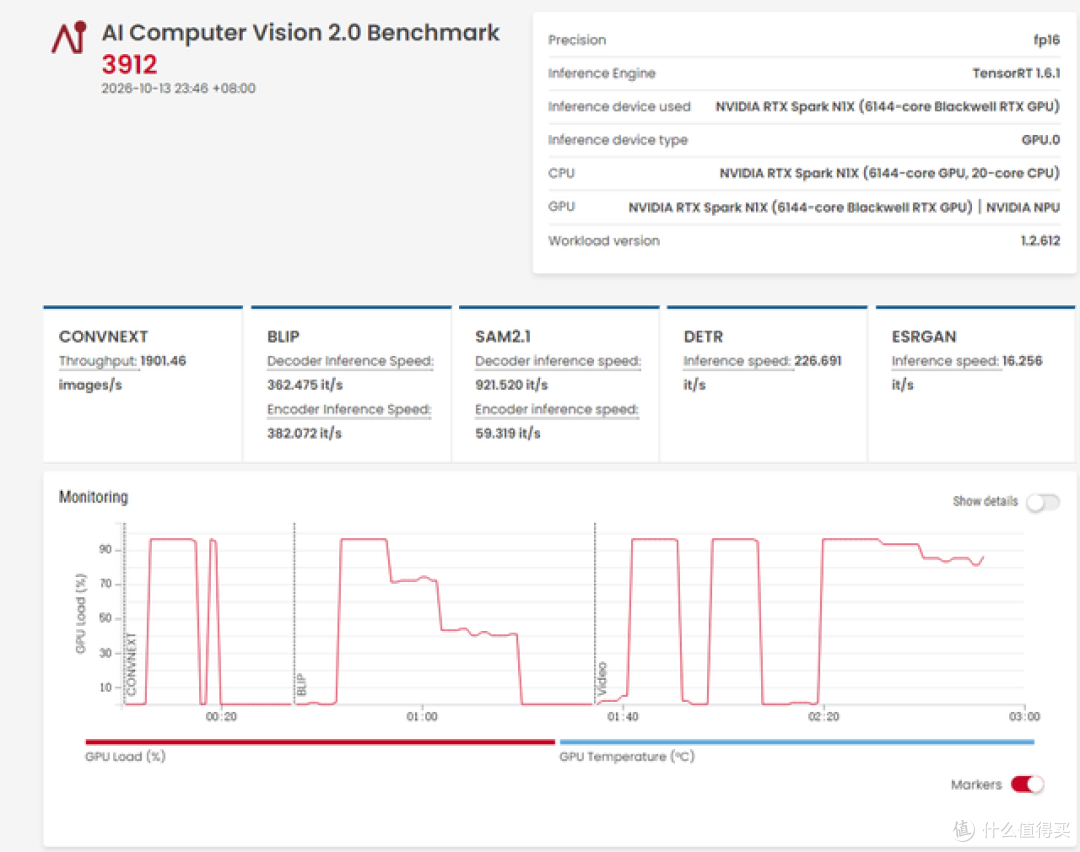
然后是更基准的AI Computer Vision 2.0测试,对于RTX Spark而言不存在任何压力。
然后是Unsloth Studio免代码界面对Qwen3.5-9B做LoRA微调,有375步、3 epochs,前后对比回答质量。以往这套流程要在AI工作站和云端才能实现,在本地是不可能的。而在联想 YOGA Pro 15 RTX Spark上,这份工作包含模型加载保存只需要5分钟左右就能完成了。
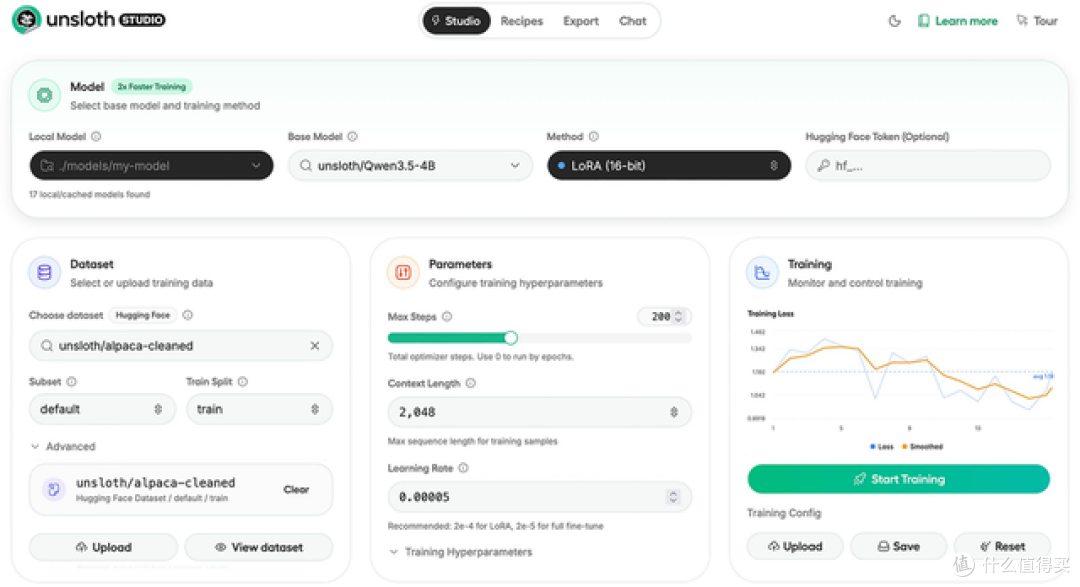
如果是128GB统一内存,还意味着可以加载14B、27B模型做LoRA,这个优势是64GB统一内存机型未必能完全实现的。这也是顶配联想 YOGA Pro 15 RTX Spark真正厉害的地方。
最后是落地到本土的腾讯WorkBuddy,它主打办公生产力场景——文档处理、课件与文献整理、报表生成、会议纪要、PPT制作等重复性桌面工作的自动化,面向企业办公与个人用户,已覆盖PC及移动多平台,此前也与英特尔合作推进端侧能力落地,PC端月访问量已达千万级。
在RTX Spark上,NVIDIA将WorkBuddy列为与Hermes、OpenClaw、Perplexity等并列的头部合作智能体,为其做了本地AI深度优化,包括首次开机即可一键安装,自动推荐针对RTX Spark优化的本地模型与配置,几击即可完成部署,并可通过OpenShell和微软MXC获得安全沙箱能力。
因此在联想 YOGA Pro 15 RTX Spark上配置WorkBuddy非常简单,登录之后,在设置中选择模型,并勾选本地模型,等待下载完成后即可完成配置,本土的网络下载加速就是快到感动。
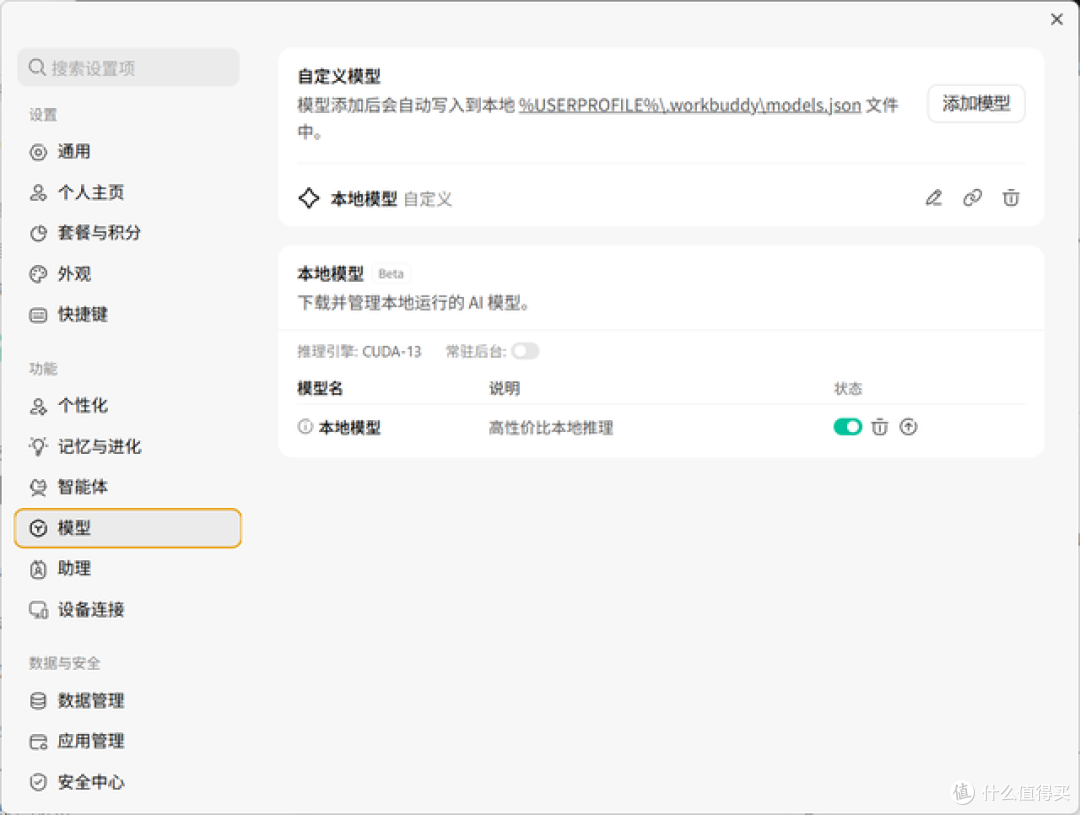
如果你是之前WorkBuddy的用户,都知道每次操作都会消耗Token,一不小心就会把积分用光。但是在RTX Spark上,这已经不是问题。通过一键本地部署的CUDA-13推理引擎,初步处理138页、140MB的图文混合的文档的时间为13分钟,而后围绕文档内容和信息再度进行问答和分析,速度进一步加快。
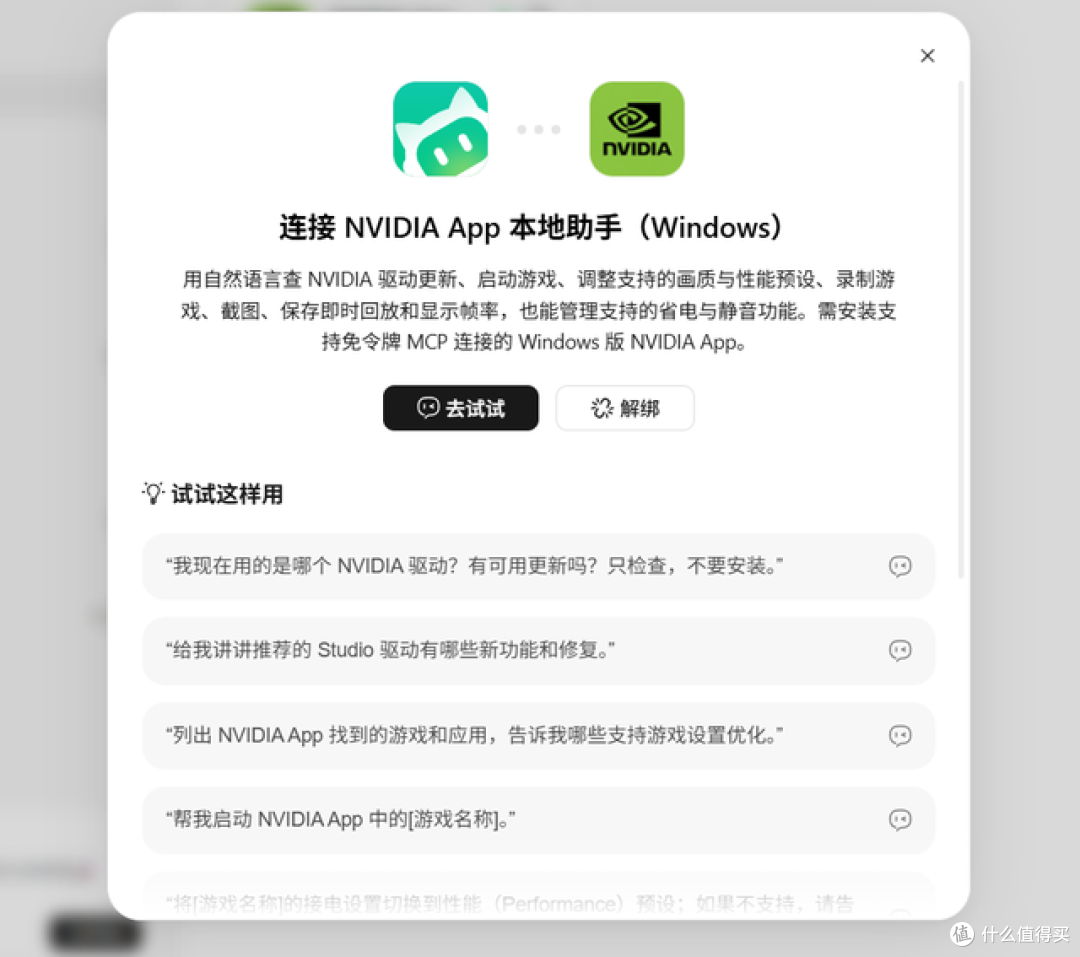
不仅如此,WorkBuddy还提供了NVIDIA专区,只要在连接器中搜索NVIDIA App,就能通过WorkBuddy对RTX Spark笔记本进行控制。比如用自然语言询问是否有最新驱动,对驱动设置进行调整。属于通用型的桌面优化助手了。
内容创作:不插电满负荷运作
内容创作是RTX Spark笔记本最擅长的领域之一。这里我们先用ComfyUI实现图片和视频的工作流,通过内置的Performance Tests功能计时,并且先预热跑一轮,再测5轮取平均值作为参考。
值得说明,ComfyUI已经提供了对NVFP4精度的支持,这是Blackwell GPU第五代Tensor Core的专属优势,同时这里执行BF16和FP8工作流来进行对比,情况类似于前面Procyon的图像生成测试。
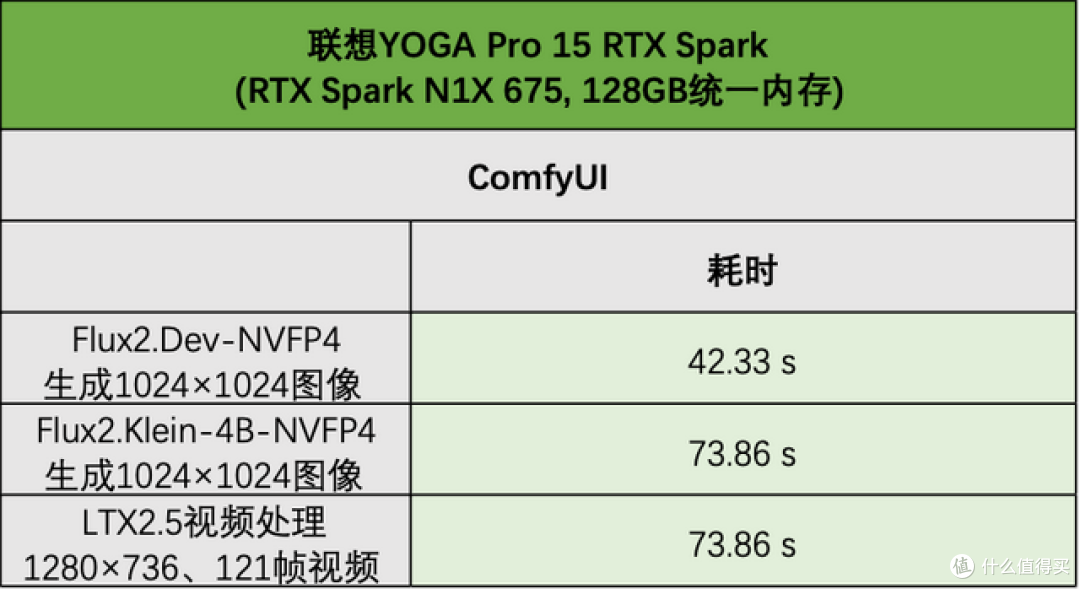
其中Flux2.Dev-NVFP4生成1024×1024图像需要42.33秒;Flux2.Klein-4B-NVFP4为15.19秒;1280×736、121帧的LTX2.5视频处理时间为73.86秒。
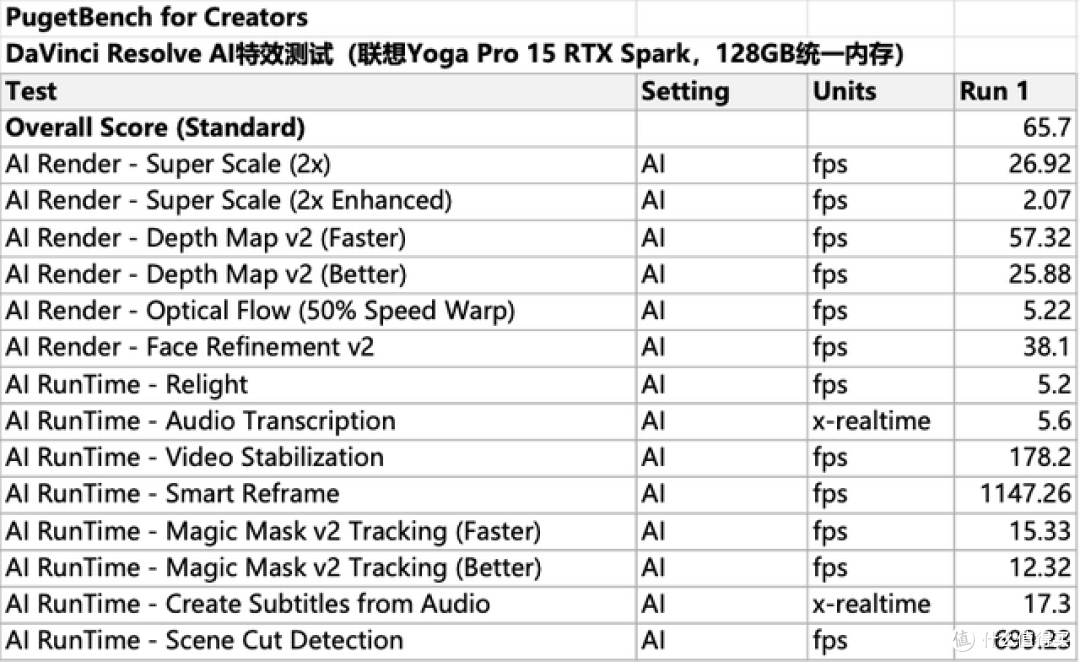
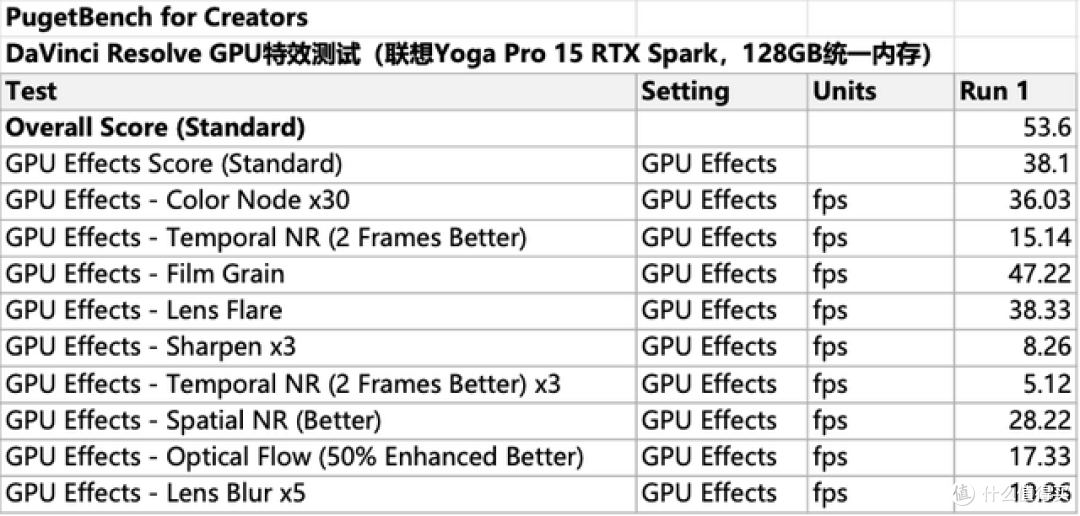
与我们日常较多的DaVinci Resolve,主要参考PugetBench for Creators测试,这是PugetSystems出品的真实应用驱动型基准,直接驱动真实的DaVinci Resolve进行GPU特效、AI功能操作,并获得最终分数。DaVinci Resolve分数为66392,具体参考如下。
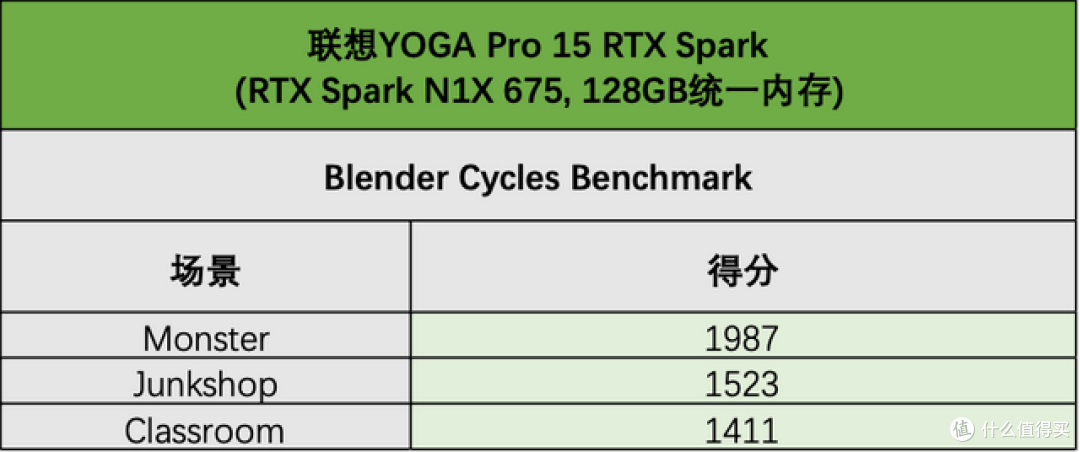
Blender Benchmark是Blender官方推出的开源渲染跑分工具,用固定生产场景测试GPU在Cycles路径追踪下的渲染速度。同时Blender 5.3已经支持DLSS 4.5光线重建降噪,在快速移动模型的时候,可以很快获得干净画面,并在停止后迅速收敛。实际表现中,RTX Spark N1X表现大约与GeForce RTX 5070 Ti 笔记本电脑 GPU相当,但实际笔记本整机TDP只有80W,并且可以离电运行,这一点是常规独显笔记本无法做到的。
V-Ray是Chaos出品的商业专业渲染器,主打基于物理的光照、材质、全局光与光线追踪,可输出照片级静帧和动画,并支持GPU及混合渲染。 它深度集成3ds Max、Maya、SketchUp、Rhino、Revit等主流 DCC/CAD 软件中,结果如下。
写在最后:
因为时间仓促,我们还没有来得及对部分新增的端侧AI创作功能进行尝试,例如Photoshop Beta已经增加了针对Tensor Core优化的本地移除工具,以及Premiere Beta也增加了对象蒙版AI跟踪、增强音频、场景剪辑检测、自动重构,外加GPU加速的32位Color Mode,所有的功能都是端侧运行,不依靠云端,而这些功能以往都是需要联网混合运行的。
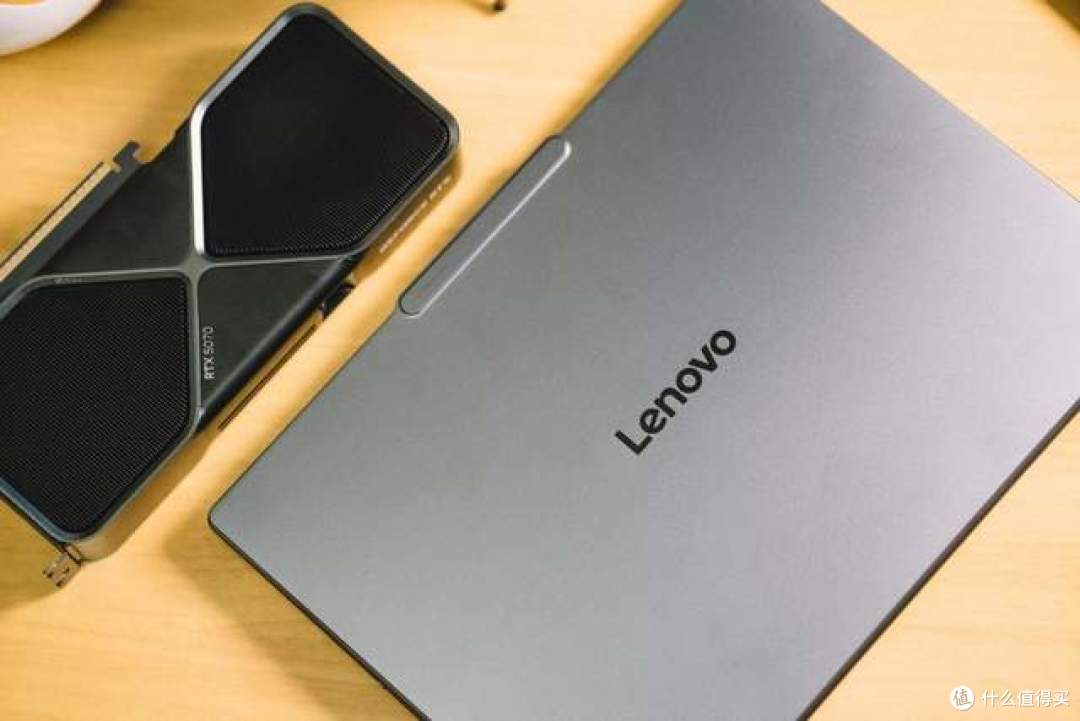
即便如此,依然可以通过联想 YOGA Pro 15 RTX Spark感受到RTX Spark N1X满血版恐怖的战斗力。它擅长把过去必须依赖云端或台式工作站的事搬进包里,128GB统一内存让它能在本地流畅运行300亿到700亿参数级别的大模型和智能体、完成模型微调,也能从容应对Blender渲染、达芬奇4K视频剪辑、ComfyUI图像生成这类创作负载。
游戏方面,RTX Spark N1X原生支持DLSS,路径追踪,Reflex,所有技术都已经准备妥当,现在只需要等待剩下的几款腾讯系的反作弊软件支持,几乎就可以应对当下所有能看到的竞技类游戏。而3A级大作没有压力,配合DLSS超分辨率和多帧生成,吃满联想 YOGA Pro 15 RTX Spark的2.5K 165Hz OLED触控屏没有任何压力。
我们也尝试了诸如官方明确表示支持《极限竞速:地平线6》,依然可以顺利运行,并可以将游戏帧率拉升到160FPS以上。当然过程中也会有一定概率会遇到游戏错误退出的情况。即便如此,首发的当天就能让Windows on Arm玩上这么多大作,未来相当可期。
你可以把RTX Spark笔记本定位成一款端侧AI的全能本,海量的内存所构建出的广阔KV Cache空间,让那些即使有16GB独立显存的GPU们都相形见绌。同时,它还可以用三分之一的功耗高帧率运行游戏,并且内容创作和端侧AI应用所向披靡,再加上轻薄的机身设计,只要你有充足的预算,或者是能通过产出快速回本创作者,这款笔记本的吸引力是拉满的。