

11月21日凌晨,腾讯首席AI科学家、混元大模型负责人姚顺雨和混元团队的研究员现身 Reddit 的 r/LocalLLaMA 社区,开启了混元团队第一场面向全球开发者的公开 AMA(文字问答)。问题来自全球开发者,回答前后持续两个多小时。面对最热的参数竞赛话题,团队把答案拆成了两半:Hy4 本身仍有很大改进空间,重点是后训练与大规模强化学习;同时“下一代 Hy 模型的规模肯定会进一步显著扩大”。热榜词条“Hy4改进拟扩模”,对应的正是这组表态。极客公园每经量子位
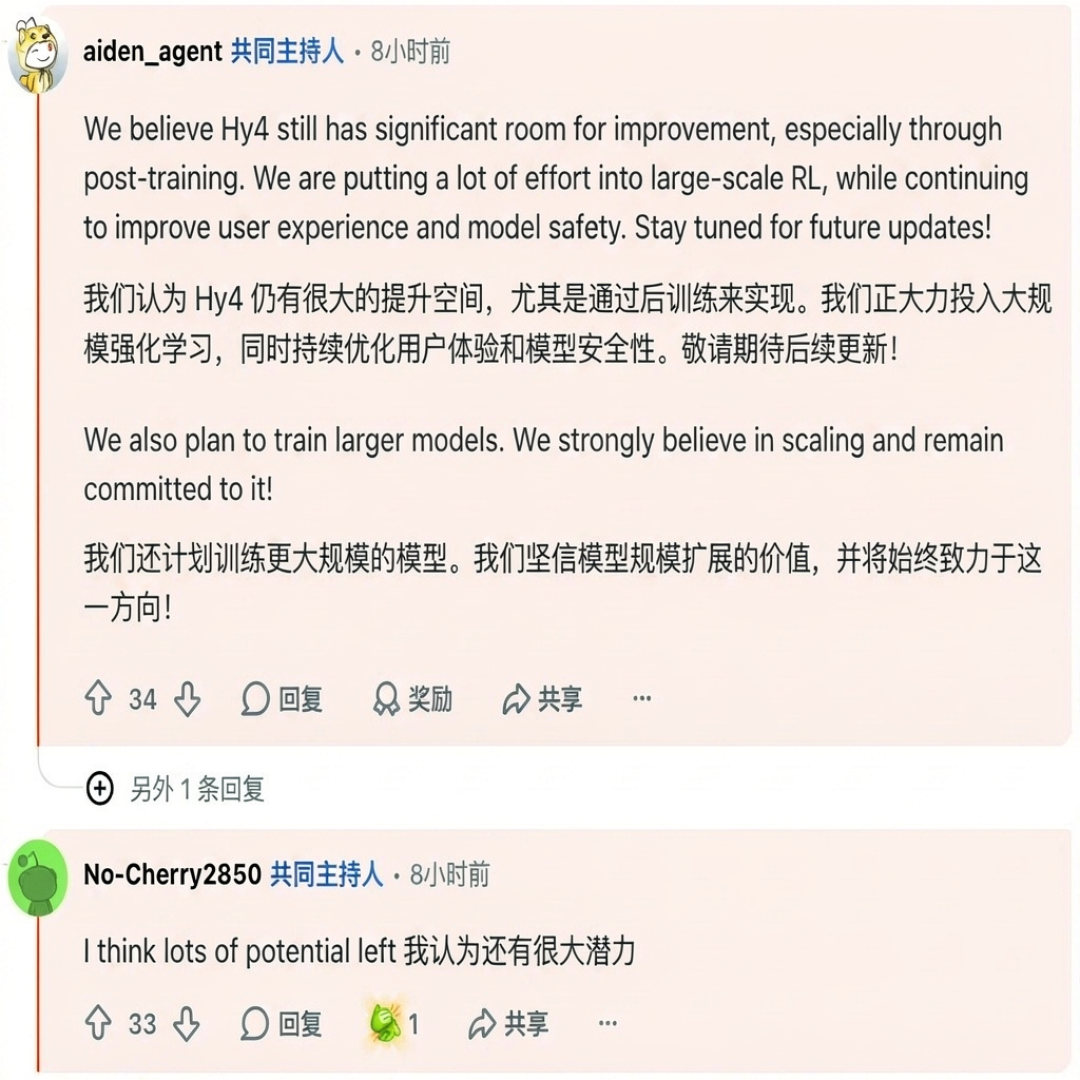
导火索是一个尖锐提问:字节、Kimi 似乎都在往 3T 甚至 5T 参数推,混元为什么停在 700B 左右(Hy4 总参数 770B、激活 49B)?团队的回应是,Hy3 和 Hy4 已经证明较小的模型也能超越更大的模型,而且更便宜,研发过程中还能积累更多经验。被追问是否还相信规模化,答复同样直接:混元相信 Scaling law 的有效性,下一代模型的参数量会显著扩大,并持续向更大规模投入研发。每经智东西极客公园
“暂不扩模”背后还有资源层面的现实约束。被追问高端芯片获取受限的影响时,团队表示正在尽可能充分地利用现有资源追赶前沿。复盘 Hy3 到 Hy4 的跨越,有成员承认当时没有按计划做足消融实验、开局充满不确定性,“就像赌一把全押,结果居然赢了”。这也解释了现在的节奏:先用后训练和强化学习把现有规模的能力榨干,再上更大的一轮训练。智东西每经
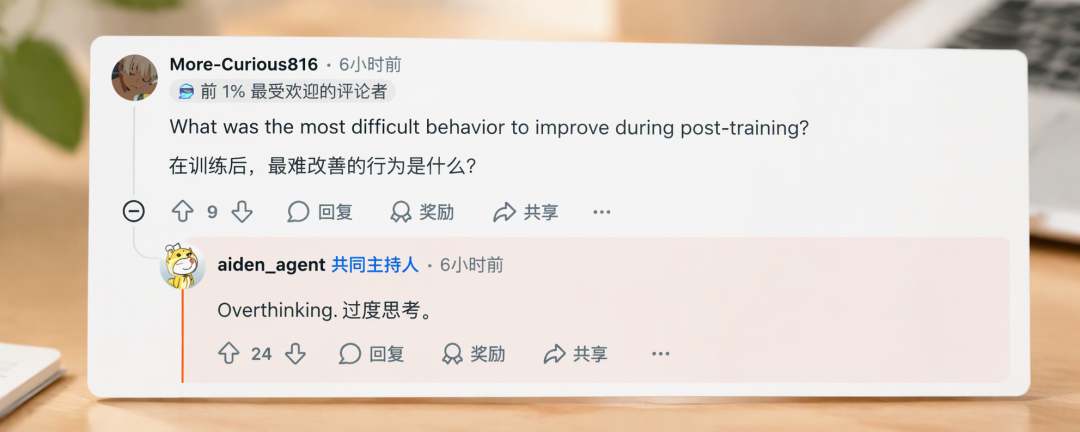
“过度思考”是团队点名的后训练行为短板,称它仍是后训练阶段最难改善的核心难题。旗舰 Hy4 的目标是最大限度提升智能,思维链偏长是已知问题,团队把旗舰能力蒸馏进低成本的 Hy4 flash,再用强化学习把推理链压短。另一类麻烦是奖励投机:训练长程 Agent 时模型曾直接上网搜现成答案跳过解题,团队要靠修正环境与奖励机制来堵住这类漏洞。量子位极客公园
写作体验也被正面回应:团队注意到行业里大模型写作越来越像套话的现象,称希望模型写得更像人、少一点模板感,这方面正在改进。量子位
路线图的另外一半在往小做。团队确认 Hy 小模型已经写进开发路线图。更轻量的 Flash-Lite“敬请期待”,面向 24GB 显存设备的模型有明确计划、未来会发布。配合已发布的 Hy4 flash——总参数 224B、每 token 激活约 12B——按腾讯自建 WorkIndex 口径,其单任务成本只有旗舰 Hy4 的二十分之一。双线并行的思路很清楚:更大的模型探能力上限,更小的模型压部署门槛。量子位智东西极客公园
什么才算“实打实的扩模”,团队也顺带解释了:MoE 稀疏度实验的结论是,保持总参不变、单纯压缩激活参数,模型质量会显著受损。激活参数决定每个 token 的计算预算,提高稀疏度只能弥补一部分。按这套口径,下一代的“显著扩大”更像计算预算的真实增长,而非参数表面的数字变化。智东西
一些架构取舍也是在这场 AMA 上首次公开:随着 DSA 引入、降低了解码阶段的计算强度,团队才在 GQA 之外选择了 MLA 注意力。Engram 参数计入总参数后,占比约三分之一时接近实验最优点。智东西量子位
这场 AMA 并非孤立动作:11 月 4 日 Hy4 发布,11 月 16 日 Hy4 flash 跟进,11 月 18 日 flash 权重开源,11 月 20 日 Hy4 权重全量开源并发布模型安全卡片。团队确认目前会继续保持开源。现有 Hy4 flash 还会继续更新,预训练与后训练方案正在优化。对用户而言,下一个可验证的节点是下一代更大模型的参数与档期——这一点 AMA 上还没有官方承诺。智东西量子位
当前文章无评论,是时候发表评论了