新模型发布一场接一场,演示却几乎共用一张脸:打开浏览器,贪吃蛇、打砖块、赛车,一句话生成、即点即玩。于是很多用户的疑问是:AI号称能写大项目,为什么演示永远是小游戏?答案恰恰相反——浏览器小游戏不是“能力不够”的妥协,而是眼下唯一同时满足成功率高、验收即时、分发零门槛、成本可控这四个条件的演示形态;而复杂大作的成败,偏偏取决于演示证明不了的隐形工程。看懂厂商为什么“只做小游戏”,才能看懂AI编程的能力边界到底卡在哪,以及这条边界正在以多快的速度后退。
小游戏是AI时代的“必过题”
贪吃蛇、打砖块很可能是全网被实现次数最多的程序,教程、源码、讲解铺天盖地,模型训练时早就看过无数遍。一位从业者的说法很直白:让AI做贪吃蛇,不是在创造,更像是在回忆。演示是不能NG的发布现场,选成功率最高的题目,是所有厂商的第一优先。知乎
这也解释了行业惯例为什么长成这样:以前测试一个大模型会不会写代码,可能让它做个网页、画个SVG。如今代码成了“万能中间层”,模型写代码、用户只玩结果,浏览器小游戏就是这道老考题的游戏化版本。机器之心
厂商把这块直接做成了产品。谷歌与Unity合作推出实验性平台Playground,用户可以游玩他人创作的游戏,也能通过简单的提示词亲手做游戏,创作门槛被压到一句话。国内厂商选了同一形态:百度官方账号发布的演示,主题就是“把脑海里的游戏做出来”的一句话小游戏生成。雷科技哔哩哔哩
这种形态的传播效率被反复验证。人生模拟器《80亿分之一》在Opus 5.5 Extra帮助下,从输入第一句提示词到公开链接只用了四小时,链接传开之后24小时体验次数破100万。链接即演示,小游戏给了厂商最短的分发路径,大作永远做不到。游戏葡萄
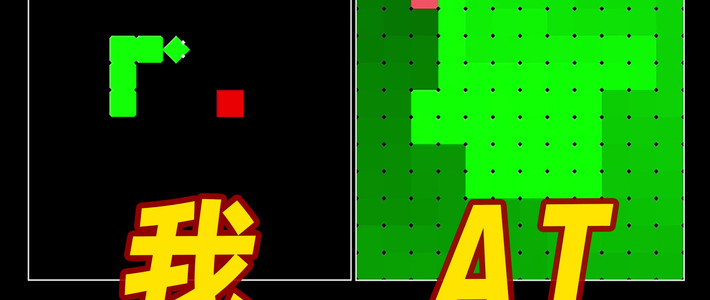
小游戏还固化成了模型能力的横评标准题。“AI像素擂台”给10个主流模型一字不差的同一份提示词,各写一个贪吃蛇程序,再放进同一赛场真实对战8470局,排名全按成绩算。连第三方横评都用同一把尺子,说明“演示选什么”早就不只是厂商偏好,而是整个行业的默认协议。哔哩哔哩
演示证明不了的部分,恰恰是大作本身
浏览器里跑起来的只是“看得见的部分”。一位实测多个模型做3D场景的从业者点破了关键:战斗判定、存档读档、关卡节奏、异常恢复,在一段演示里全看不出来,好不好玩还得真玩。大作的体量,恰恰是由这些“看不见的部分”堆出来的。知乎
最权威的证词来自引擎侧。10月23日的UnrealFest上海站,Epic Games创始人Tim Sweeney公开复盘:在内容开发方面,今年1月的AI表现甚至更糟,它在3D内容生成方面完全派不上用场。在他的描述里,视频模型对世界的理解,短期内迁移不到3D资产生产上。钛媒体
补上这块缺口靠的是工业级投入:OpenAI花三个月微调模型、用大量强化学习任务训练它做3D内容;Epic则向美国前四、中国前五共9家大模型公司提供虚幻引擎完整源代码、文档和训练示例,其合伙人Robin Wang强调这些训练数据完全免费。大作不是“一段更长的代码”,而是一条资产、工具链、流程互相咬合的产线——模型要进产线,得先被专门训练,这是发布会现场给不出来的。钛媒体
信任问题同样卡在复杂工程上:开源引擎Godot宣布封禁Vibe Coding式贡献、收紧AI生成大段代码,官方理由是AI不会为代码负责,我们也无法相信高度依赖AI的开发者能真正理解自己提交的代码。小游戏演示不需要任何人“接手维护”,所以它是安全的。CSDN
让AI“玩”复杂游戏,同样很贵
反过来,让AI直接去玩现成的复杂大作,成绩单并不好看。一场《星际争霸》AI横评里,GPT、Claude、Grok三家共19个模型打了171局,最高推理档位的Grok从开局苦思到结束也只有43分钟、11138个推理token、6批指令——0个作战单位;全胜夺冠的模型,也打不过人类新手。新智元
另一头,谷歌DeepMind把4个Gemini 4 Argon智能体扔进《我的世界》:没人教攻略、没人分工,累计死亡605次之后,它们自己写了2783段程序,打了27小时14分钟,击败末影龙。小游戏是“生成完几十秒就能玩”,复杂任务是“几十小时硬磨出来”,中间隔着的不只是代码能力,而是验收成本与账单量级——演示选择本质上就是成本选择。爱范儿
但演示的边界正在肉眼可见地后退
先看“浏览器”与“低画质”的解绑。创作者烧风把全局光追、焦散、高动态范围的互动泳池装进浏览器,自称手机也能60FPS运行,而代价是百亿级token。再看体量:有创作者用Kimi两天复刻出《皇牌空战》式3D空战玩法,标题干脆反问——Kimi也能做3A了?还有网友拉来Opus 5.5、GPT-6 Astra和Fable 5.1,不用现成引擎、从零重现《塞尔达传说:时之笛》的开场场景——尽管距离真正完整的塞尔达还非常远。哔哩哔哩哔哩哔哩机器之心
人机协作的一侧甚至已经“溢出”演示形态:零代码背景的创作者Nenly用约3个月让AI完成《群侠传:幸存者》的代码、美术、音乐并上架Steam,自述评测2115条、97%好评、约12.8万人实际玩过,而他特别强调,这并非一个只为证明模型能力而生的小Demo。这类案例与“一键生成”的共同点是:架构和验收始终由人兜着——AI演示给不了这一段。知乎
另一条不用代码的路线同样没捅破窗户纸。谷歌世界模型Genie 4创建世界通常不到30秒、约24帧实时交互,但单次生成的交互体验最长约2分钟,只是从上一代1分钟的上限翻倍。像素路线用“即时成像”换“短”,代码路线用“一直可玩”换“糙”,两条路线卡在同一道题的两端:怎么低成本地验收一个完整世界。AI前线
该盯的是尺子后退的速度
结论回到标题:AI演示齐刷刷选择浏览器小游戏,是成功率、验收、分发和成本四件事共同选出来的,不是能力天花板。因此判断模型何时真正跨进“复杂大作”,不用等某场发布会的惊天一秀,只需盯三个信号:横评的尺子从贪吃蛇升级到“能打完一关”的游戏;引擎公司向模型开放的那条产线(Epic已经拉上了9家厂商)开始出现在公开演示里;演示叙事从“30秒能玩”换成“十万人玩通关”。哪天浏览器小游戏不再是演示的唯一正确答案,AI才会真的在发布会上做复杂大作。