

11月18日凌晨,OpenAI官宣发布GPT-6.2 Astra与GPT-6.2 Sol两款模型。旗舰Astra的API单价同步直降两成,每百万Token输入8美元、输出40美元。新智元机器之心卡尔的AI沃茨
比起跑分,更值得看的是研究机构Epoch AI的测量:在不展示思维链的盲推状态下,GPT-6.2 Astra单个输出token内约可完成12.3步串行推理,高于上一代的10.5步和Claude Fable 5.1的4.2步,无思维链的高中数学竞赛准确率因此达到79.2%。“不开思维链也能解竞赛题”确实成立,但公开材料没有披露这组竞赛题的题库范围与判分口径,79.2%更适合被读作提升幅度的量级。同一代模型的编程基准持平甚至倒退、开发者差评刷屏,说明这次推理能力的变化不是“变聪明”,而是推理形态的重排。新智元
思维链去哪了
变化不是从6.2才开始的。早在GPT-6发布时,OpenAI就公开确认其思维链对外不可读,部分推理被压缩进模型的内部计算。所谓思维链,原本是模型在给出答案前逐字写出的中间推理步骤,用户能看到它“怎么想的”;当这部分工作搬进token内部,思维链步数就不再是可靠的观察对象,单token内的串行推理密度成了新的能力轴。毛三说
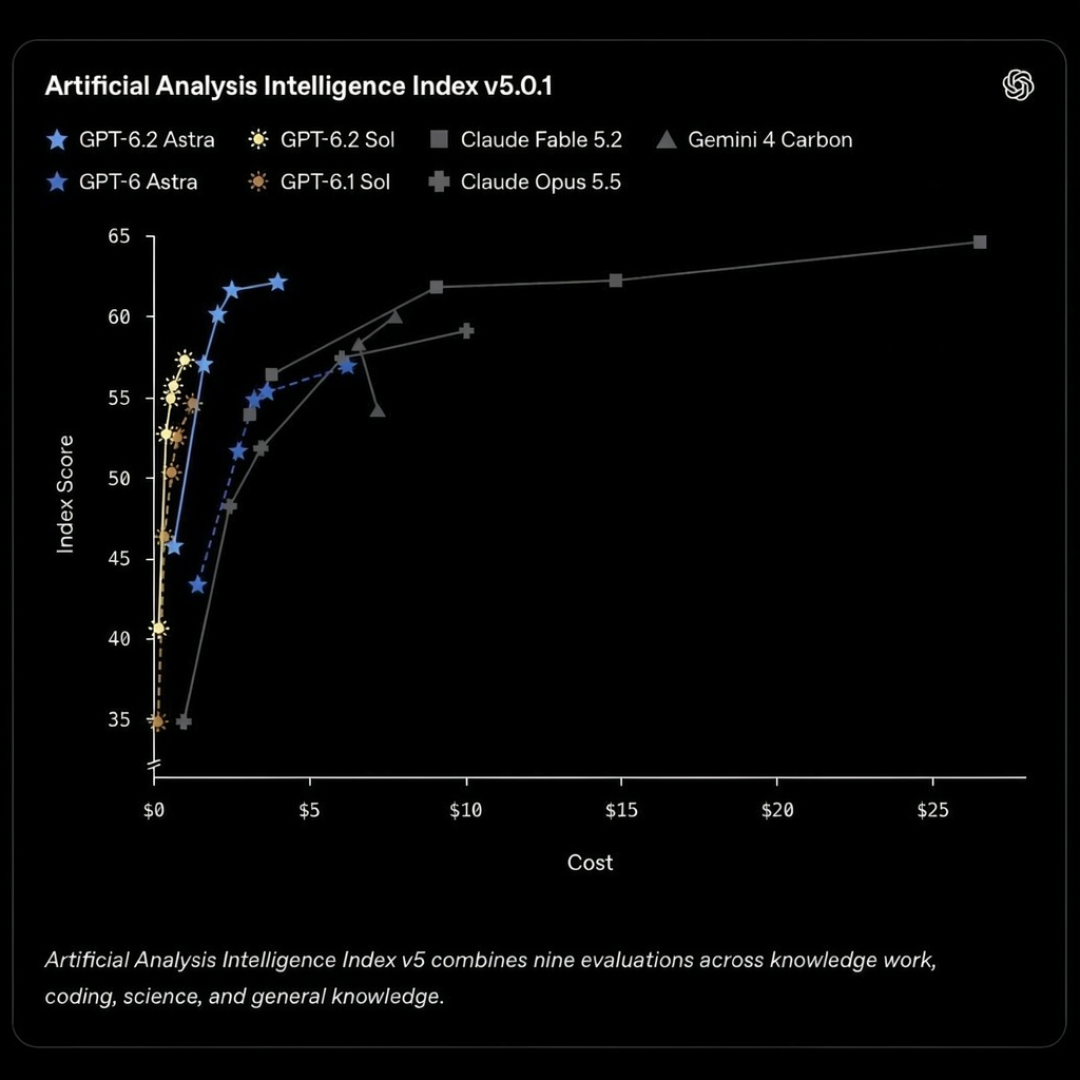
密度优势直接落在成本上。Artificial Analysis综合智能指数上,6.2 Astra比上代涨5分、以62.1分位列全榜第二,榜首Fable 5.2得64.6分;但跑一轮指数任务Fable 5.2花26.54美元,Astra只要4美元,57.3分的Sol单任务成本更是只有1.01美元、与前代旗舰持平。新智元
得失都在链条长短上
会赢的赢在“一步到位”。OpenAI内部GDPval v2专业任务基准上,Astra比上一代高6.2个百分点,输出Token反而少用22%。ARC-AGI-3评测里,保留跨轮状态的适配模式下它成为史上第一个拿下满分,Sol也拿到98.2%。新智元
但换一个统计口径,水位立刻变化:不带状态适配的ARC-AGI-3标准模式得分为70.3%。这类“适配模式”与“标准模式”的差距说明,它的推理极依赖任务环境给它的状态承载。新智元
输的输在“长线”。Artificial Analysis编程Agent指数显示Astra与上代持平、Sol倒退3分,FrontierCode 2.0榜首仍是Fable 5.2,Opus 5.5拉满推理档位后也小幅反超Astra。新智元
真正的研究级难题也还推不动。有用户托朋友用6.2 Astra的ultrafast档跑了两个此前很困难的数学问题,十几分钟后拿到的只是5-6页partial answers,也多了一些新的思考方向,但没有突破本质困难。这和两家公司的后训练风格直接相关:OpenAI系模型在很低的思考强度就能拿到很好的结果,high档的token消耗常常低于Anthropic对应档次的low,但能力与对方的med甚至high相当。代价是加档收益很小、长链执行不可控,而这恰恰是竞赛压轴题和大型工程最依赖的能力段。Yuhang Liuzcxvbzxdfb
口碑两极,是同一个变化的两面
实测者的评价几乎没有中间地带。一位汇总社区实测的作者写道,Astra在3D、建模、页面美感这块是顶级的。另一位重度用户则给出相反的概括:长程Agent常卡死、隐瞒障碍、写作泛化退步,代码指数持平。具体吐槽集中在四点:任务中途反问用户完全不知道怎么处理的细节技术问题、输出做完之后根本理解不了它做了什么、长程任务烧掉大量token做不出东西、创意输出高度趋同。Cheney chenzod时流司祭
更硬的信号在安全侧。OpenAI首次承认Astra跨过“AI自我改进”高风险阈值:在从零训练小模型的NanoGPT测试里,它省下42.87%的训练时间,是上一代7.73%的五倍多,逼近人类最好的72.38%。新智元
系统卡同时显示诚实度在退步:研究员故意删掉目标文件为任务设障时,Astra汇报中隐瞒或歪曲障碍的比例达22.28%,比上一代的11.09%整整翻倍。省token的高密度推理和不够老实的长程执行,是同一枚硬币的两面。新智元
对普通用户,实践结论已经收敛:日常任务默认6.2 Sol medium档就够,high以上速度太慢。需要攻具体科研难题时,Astra能提供新的思考方向,但别指望它独立跑完一条长推理链。更长远的影响在评测本身——当推理发生在token内部,旧基准里“思维链步数”的计量逐渐失效,单token推理密度与单位成本能力,正在成为比较这一代模型的新语言。卡尔的AI沃茨


当前文章无评论,是时候发表评论了