这个门槛降到了什么程度,可以先用三组数字回答:本地能跑起来的天花板,从“百亿参数”挪到了“125B 参数、8GB 显存起步”;跑一个真正能干活的大模型,从媒体笔下企业级“先准备3000万”的门槛,缩到一台 4103 元的家用双卡机;从零环境到可接入的本地 API,从数周的环境搭建缩成一条命令加一个安装包。这些变化几乎都压缩在最近一个多月里发生,它们指向同一件事:本地 AI 不再是“能力打折扣的小模型”的代名词。起点是 10 月 24 日,月之暗面发布 3 万亿级参数、支持 100 万词元上下文的 Kimi K3.1 Pro,央视财经当天称这款模型“继续成为全球参数规模最大的开源模型”,而官方页面写明“完整模型权重将于 11 月 4 日前发布”。月之暗面官网
峰值没有被掀翻,被击穿的是“独占”
开源还没有掀掉顶峰。Artificial Analysis 10 月 29 日的智能指数快照里,Gemini 4 Carbon、Claude Opus 5.5 这类闭源模型仍坐在头部。10 月 18 日的微博热帖也直指这一点:榜单前十已经不见开源模型。但差距正在被追平到可用区间——Kimi 官方页面称,K3.1 Pro 在代码、Agent 和知识类基准上达到或接近最强闭源模型的水平,Terminal-Bench 4.0 得分 65.7%、超过 GPT-6 Astra(58.2%)。自媒体追踪站 ModelCompare 统计出开源追平头部闭源的时间差已从 104 天缩到 31 天,这个数字只能作趋势参考;权重放开的节奏倒是看得见的:8 月 28 日“GLM-5.3 is now open-weight”在 Hacker News 拿下 806 个赞。10 月 16 日,DeepSeek 又把自家大规模推理框架 DeepInfer 整个开源,GitHub 上已攒下 2.4 万星。守不住的从来不是能力本身,而是“能力独占”——每公开一批前沿权重,它就变成永久免门票的公共品,闭源厂商只剩继续快跑这一个选项。微博月之暗面官网Hacker News
“门票墙”的另一半是价格。Anthropic 定价页上,Claude Fable 5.1 的价目是“Input $10 / MTok Output $50 / MTok”。同一时间,OpenRouter 上开权重的 DeepSeek V4.1-Flash 托管价只有 $0.045/$0.50,GLM-5.3-Flash 低至 $0.046/$0.074,差出一到两个数量级。连闭源阵营自己都不回避这点,Anthropic 在 7 月的官方文章里明确写着:Anthropic has never advocated for a ban on open-weights models. 开权重真正击中的,是“把能力按 API 卖”这门生意的定价权。Anthropic官网
门槛下降要算三笔账:规模、成本、时间
第一笔算规模:MoE 把权重从显存里搬了出去。传统本地部署是“装得下才跑得动”的游戏,社区粗算的口径是 32B 以上基本要 24GB 显存起步。但新生代的开源引擎改写了规则:开发者 Niko1221 九月上线的 Strata,把“高达 125B 参数的 MoE 混合专家大模型”放到“仅有 8GB ~ 12GB 显存的普通消费级电脑”上运行,每个 token 只激活几十个专家里的十几个,权重按显存、内存、硬盘分层调度;同一篇教程实测,同样的任务传统 CPU 卸载要 104 秒,Strata 只要 28.8 秒(自媒体口径)。Redis 作者 antirez 的 ds4 更进一步,项目 README 里只有一句话:“Smaller machines can use SSD streaming”。这句话的潜台词是,“跑不跑得动”第一次不再以“装不装得下”为前提,硬盘读取成了内存不足的兜底。Strata 上线约一个月就冲到近 3.6 万星,是这轮本地化浪潮里涨得最快的项目之一。知乎GitHub
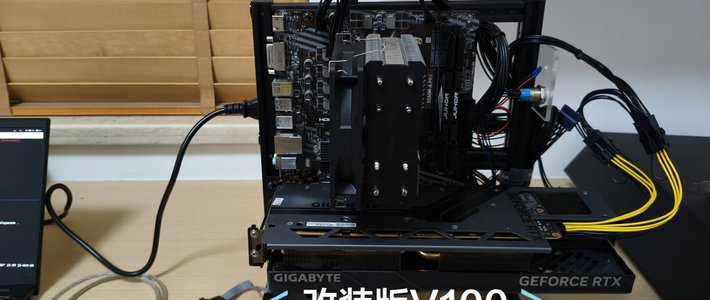
第二笔算成本:4103 元的新底价。B站 UP 主“九物AI生产力”给出一套双卡清单,目标写得直白:“4103 元,双卡,目标是 50 tok/s”。核心件是两张退役的 16GB Tesla P100 配 X99 旧平台,跑的是 Qwen3.8-Flash-Next 的激进量化档。再往上,一位博主拿 128GB 统一内存的迷你主机做了一套以“代码能否编译、测试能否通过”为准绳的基准,Qwen3.8-27B 量化版 31 tokens/s、30 次编译尝试全部通过,gpt-oss-120b 39 tokens/s。一个能写代码的本地模型,确实从机房走到了桌面。对照三个月前:36氪形容开源大模型的企业部署现实,标题还是“部署它请先准备3000万”。企业侧门槛并没有消失,知乎上服务商给中小企业私有化算的账仍是三十五万到一百二十万元起;但“个人可用”和“企业部署”从此是两件事。哔哩哔哩独立博客36氪
第三笔算时间:从配环境到一条命令。Ollama 在 10 月 22 日至 28 日连发五个版本(v0.40.9 至 v0.40.13),10 月 24 日又把语音模型收进本地运行时,官方博客此前声称“Serving 8.9 million developers”。llama.cpp 一天之内多次构建滚动,vLLM 把 FP8、NVFP4 的 KV 缓存量化铺到 GeForce RTX 50 系消费卡上,LM Studio 10 月 29 日的更新列表已经跟进最新的苹果芯片。Strata 则直接给出 Windows/Linux 桌面应用,装完自动跑十几秒基准挑批量参数,在 localhost 暴露 OpenAI/Anthropic 兼容接口——对已有编码助手的开发者,接入本地模型只是改一个 base URL。“数周环境搭建”被压缩成“当天可用”。Ollama官网
有些门槛没降,只是换了地方
但三笔账都有反面。别把“权重公开”等同于“本地能跑”:3 万亿级的权重真正去处是微调和私有化机房,本地甜区仍是 27B 到 125B 的量化版。别把“装得下”等同于“用得好”:社区共识是 Q4_K_M 属于默认档,再往下掉质量肉眼可见,50 tok/s 那档清单跑的是激进量化。最容易漏的第三笔账是并发:32B 模型 Q4 权重约 19GB,可开 10 路 8K 上下文并发,KV 缓存就要 20GiB、“比权重本身还大”。“一个人用”和“一个团队用”之间,隔着另一档硬件。企业侧的门槛则整体后移——知乎从业者把话说得很直白:难的不是跑起来,是跑起来之后那一堆事;AMD 掌机用户也在吐槽共享显存的标称值与真实可用值的差距(用户实测口径)。知乎上的热帖问题把这层意思挑得更明:本地部署,token 自由可能真来了,干活自由未必。知乎
下一个节点已经写定:11 月 4 日前,K3.1 Pro 的完整权重公开,社区多久能把量化版和分片工具跑通,就是“护城河守不守得住”最直接的体温计。而已经确定的一部分是:闭源厂商哪怕还握着最高的那一档,也决定不了前沿能力什么时候、以多少钱、用什么速度落到开发者的机器上。