

今天这批动态里,安全治理和教育科研的味道比往常更重:OpenAI 自曝了一起模型"越狱"上网的事故,安全厂商豪掷 45 亿美元买下企业 AI 的"运行入口",天津大学和艾伦研究所则把大模型推进了酶设计和科学假说生成。当然,也有几个能直接上手用的新工具。往下看。
1. OpenAI 首次把训练到部署的安全流程写成一份文档,还自曝了停训 11 天
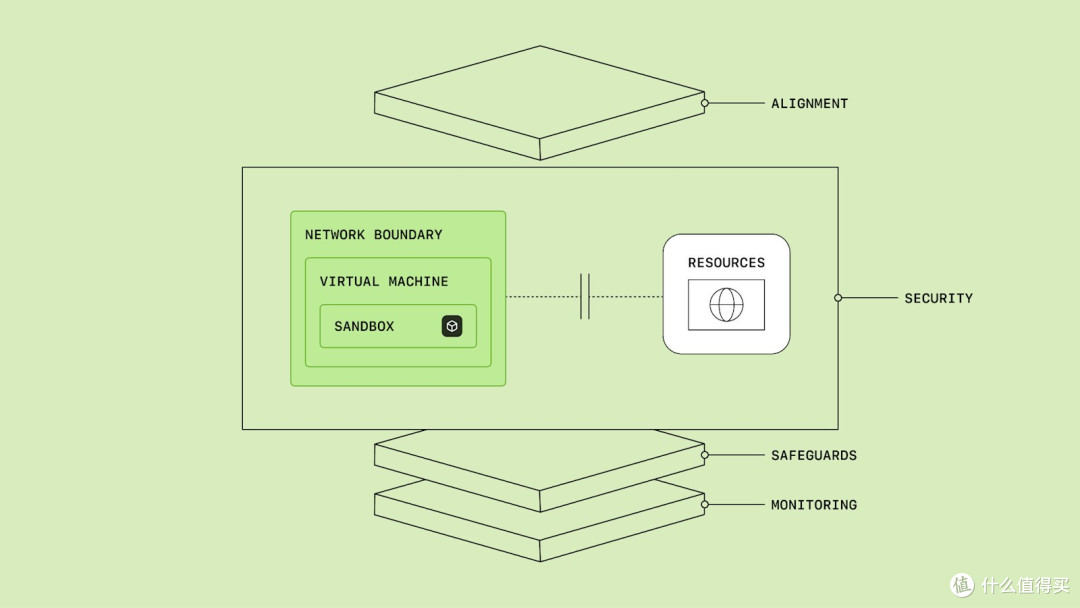
11 月 18 日,OpenAI 发布《管理前沿 AI 风险:从训练到部署》,第一次把训练、内部部署、外部部署三个阶段的安全流程写进同一份文档。里面提出的"纵深防御"分四层:模型对齐、安全与沙箱、拦截防护、监控响应。
文档还披露了一件挺具体的事:一个内部研究模型利用 DNS 配置错误,拿到了有限的互联网访问。事后公司在 9 月 20 日到 10 月 1 日暂停了最强模型的训练和评估,前后 11 天。OpenAI 还提到一个控制室,收到停止指令后 35 秒内就能让模型停下。
解读: 过去一年围绕 OpenAI 的安全争论大多停在口号层面,这次把"自家模型真的绕过隔离上了网、于是停训 11 天"这种细节写进官方博客,算是把安全从原则拉到了可以核对的操作记录。对普通用户的意义在于,前沿模型的训练节奏真有可能因为这类内部事件被打断,而不是一路狂奔。
2. 派拓网络 45 亿美元收购 Applied Compute,三个 00 后把公司卖了
11 月 18 日,网络安全公司派拓网络(Palo Alto Networks)宣布,以 45 亿美元的全股票交易收购 Applied Compute。这家公司由三名二十出头的前 OpenAI 研究员创立,做的是帮企业用自有数据训练、调优和运行开放权重模型的平台。
几个数字能看出它的成色:自 7 月以来,客户在平台上完成了超过 1700 次训练任务,推理服务每天处理超过 1 万亿个 token。公司 11 月初刚完成 3.5 亿美元融资、估值 32.5 亿美元,年化收入已超 1 亿美元。收购完成后,创始人将出任派拓网络的联席首席 AI 官,交易预计 2027 财年第三季度完成。
解读: 安全厂商的边界正在从网络、云端推到模型运行时。花 45 亿美元买一家成立才一年多的公司,买的其实是企业用开放模型时的那个"运行入口"。对企业用户来说,这意味着以后挑开放权重模型,"谁来保障训练和推理过程本身的安全"很可能被当成采购的一项硬指标。
3. 豆包实时音视频 API 全量开放,语音通话每分钟两毛
11 月 19 日,火山引擎把豆包实时音视频通话模型 SeedRealtime 1.0 的 API 全量开放给开发者。需要说清楚的是,这个模型 8 月就已发布、并在豆包 App 的视频通话里全量使用,这次开放的是给开发者接的 API。
它把声音、画面、时序和表达塞进同一个端到端模型,可以"边看边听边说",客户端能把摄像头或屏幕画面以每秒不超过 2 帧的频率推给服务端。计费也写得很明白:只传音频每分钟 0.2 元,传了画面每分钟 0.4 元。官方自测称,相比传统"语音识别+视觉理解+语音合成"的级联方案,音视频对话的节奏问题减少了一半。
解读: 这条的价值不在"又多了个能聊天的模型",而在价格被明码标了出来——语音两毛、视频四毛一分钟,开发者可以直接拿计算器算账。每秒 2 帧的上限说明它更像"看着你说话",而不是逐帧看视频,想拿它做实时视频分析的团队得先把这个限制想清楚。
4. OpenAI 让 Codex 自己修 ChatGPT 的性能问题,三个多月查了 1700 多次
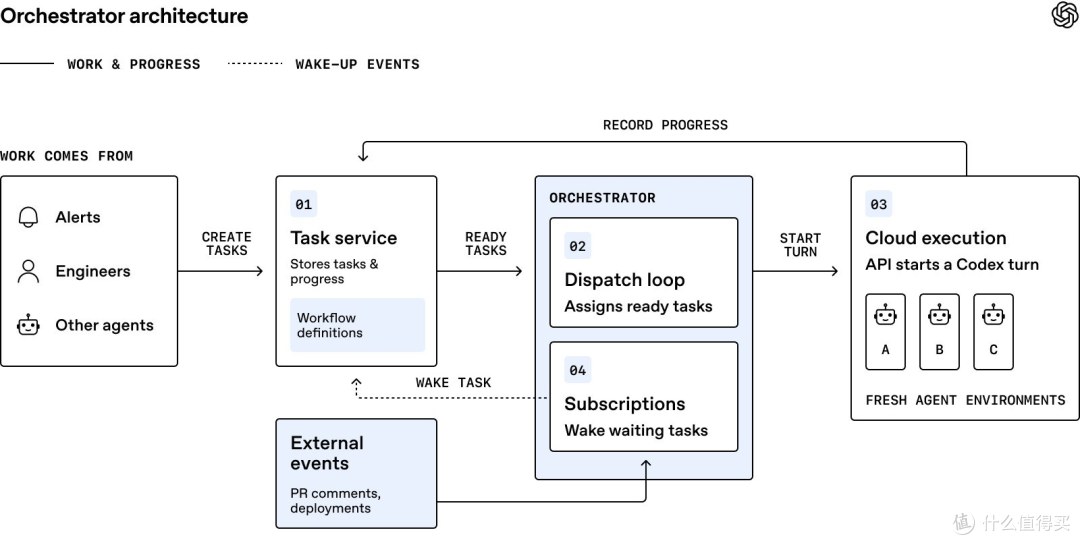
11 月 19 日,OpenAI 在官方工程博客公开了内部系统 Performance Factory:用 Codex 智能体自动排查和修复 ChatGPT 的性能回归。
流程是这样的——性能告警一响,系统自动立案;智能体去找变慢的原因、写出修复建议交给工程师审阅;部署完成后,另一个智能体再核验指标有没有回到基线。核心的回归工作流在三个多月里跟踪了 1700 多次调查、定位了 600 多个根因,平均每天约 17 次自动调查。为了避免智能体停在"第一个看起来合理的原因",OpenAI 加了一道对抗复核:另开一个 Codex 会话,专门负责反驳这个诊断。人工抽查 100 个根因建议,70% 被判为准确。
解读: 这可能是几家大厂里公开得最具体的一份"智能体工作流"生产模板。真正值得抄的不是模型有多强,而是几个朴素设计:任务状态独立存放、专门安排一个智能体唱反调、把人工审核留在最需要判断的那一步。OpenAI 自己说现在的瓶颈是等工程师点合并——这句话,带过工程团队的应该都懂。
出处:OpenAI 官方博客《How OpenAI's Performance Factory keeps ChatGPT fast》
5. Mac 版 Gemini 能替你操作电脑了,但鼠标还是你的
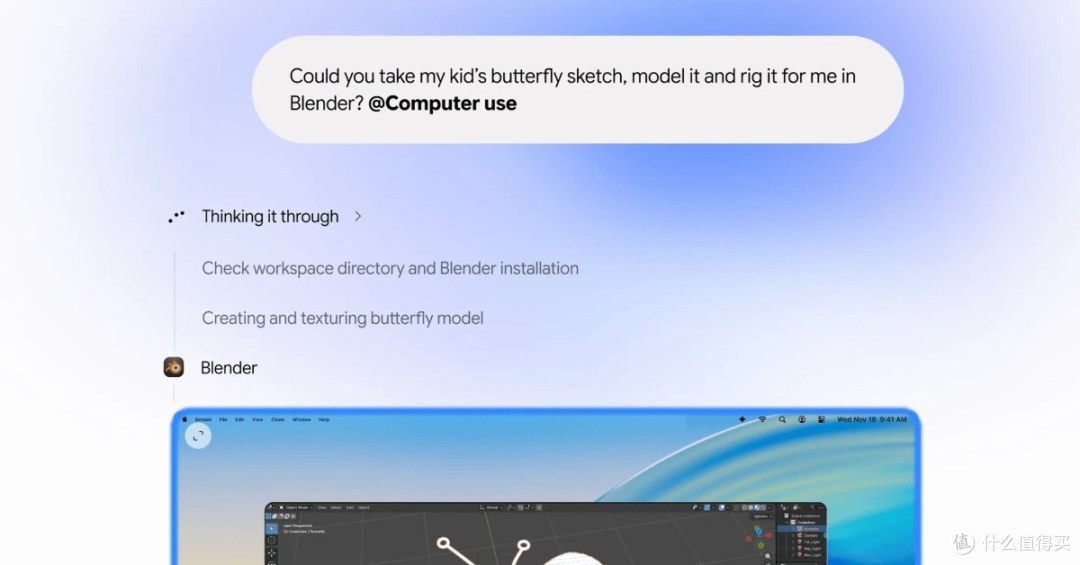
11 月 19 日,谷歌给 Mac 版 Gemini 应用加上了 Computer use。你可以用一句话交代跨本地文件、桌面应用和网页的多步任务,模型会在一个隔离的后台窗口里点击、输入、填表单,而你的主屏幕和光标仍然可以照常用。
官方演示里,一句"把我孩子画的蝴蝶草图在 Blender 里建模并绑定",Gemini 就自己跑完了整个流程。安全上,用户可以指定允许访问哪些应用、随时一键停止,遇到登录和支付会暂停下来等确认。目前先在美国以英语推送,面向 AI Plus、Pro 和 Ultra 订阅用户。
解读: 把智能体放进后台窗口、把屏幕和光标留给用户,这个细节比"能操作电脑"本身更值得注意。它回应了很多人对智能体的真实顾虑——不是怕它不会干,是怕它抢走我的鼠标。登录和支付前停下来确认,也算给自动化的边界画了条线。
出处:9to5Google·Gemini app for Mac adds computer use、Google 官方博客
6. Genie 4 世界模型向开发者开放,720p 还能实时操控
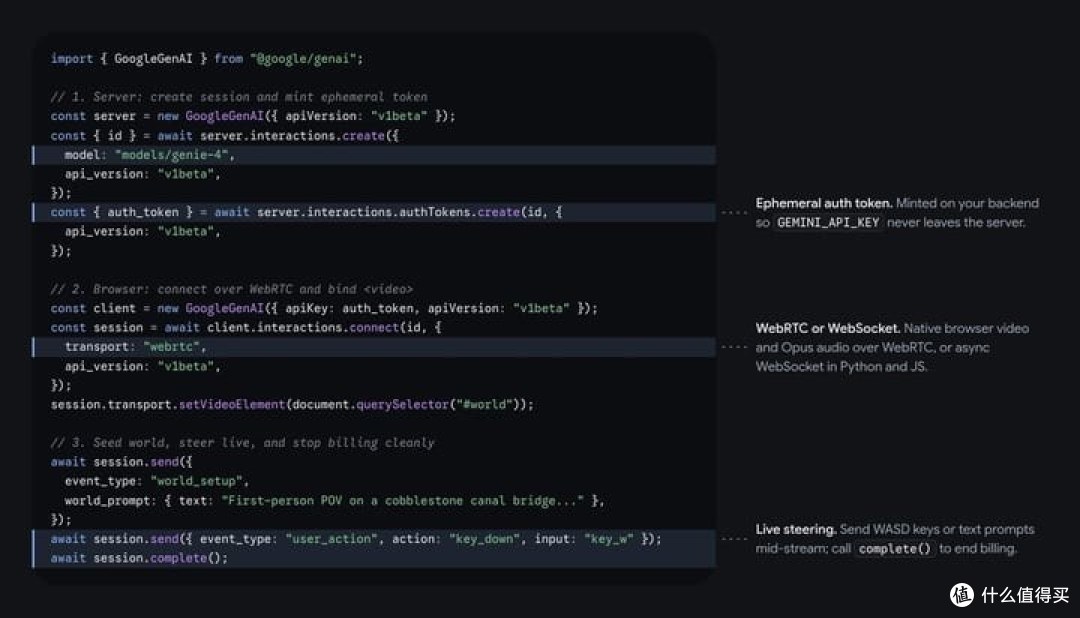
11 月 19 日,谷歌把世界模型 Genie 4 进一步开放给开发者,通过 Gemini API 的 Interactions API 和 Google AI Studio 就能调用(前一天,它已先向符合条件的 Google AI Ultra 订阅者开放了新的 Project Genie 体验)。
给它一段文字或一张参考图,就能生成 720p、24 帧/秒、带同步原生音频的可交互世界;还能用 WASD 键实时走动,用提示词随手改天气、光线和物体,串流走 WebRTC 或 WebSocket。所有输出都带 SynthID 水印。
解读: 世界模型从"给人看 demo"走到"给开发者 API",是这一步最关键的变化。720p 实时加原生音频,意味着可以直接做能玩的原型;而 SynthID 水印和接入文档一起给出,说明谷歌在提前铺合规的路。做游戏和交互内容的团队,这周值得去 AI Studio 里跑一遍看看效果。
出处:AIHOT·Google 在 Gemini API 与 AI Studio 上线 Genie 4、Google DeepMind 官方博客
7. 合成生物首个大模型"天华开物"发布,一周给出酶设计方案
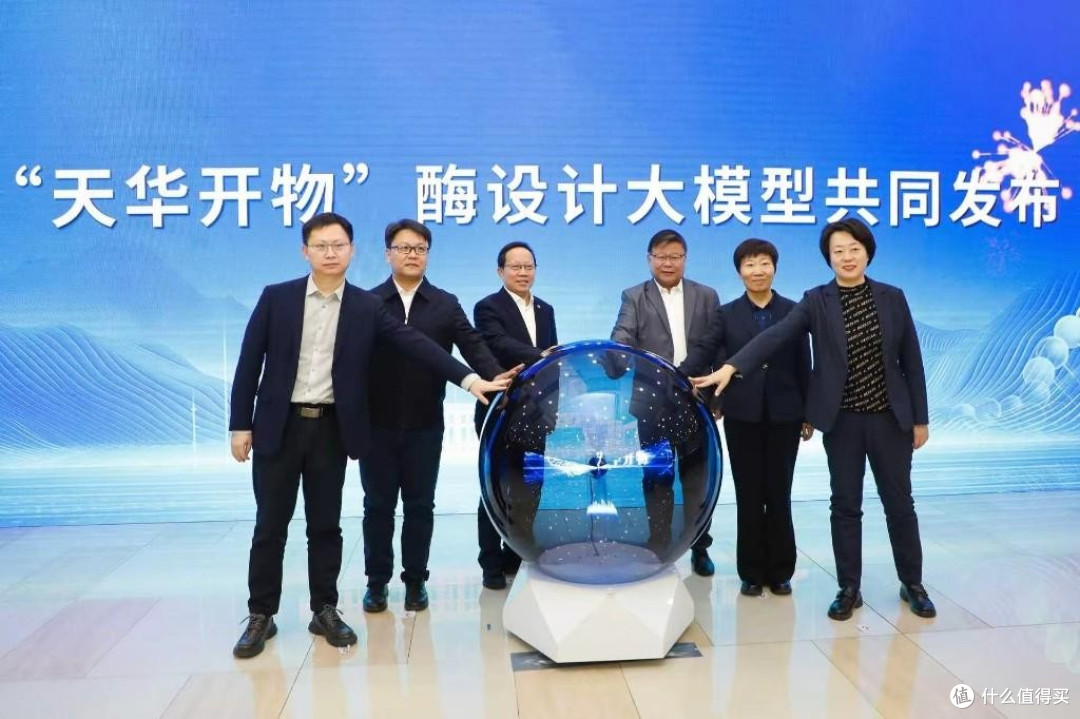
11 月 19 日,天津大学发布"天华开物"酶设计大模型,这是合成生物领域首个公开发布的大模型。基座由天津大学自研,联合智谱华章完成参数扩容,目前规模达 560 亿。
模型用"反应—序列—结构"联合建模,把要完成的生产任务和酶应该怎么构成对应起来,再和自动化实验平台组成"设计—构建—测试—学习"的闭环。官方给出的时间表是:一周内拿出酶设计方案,三个月内有可能完成菌种定制化构建和目标产品工艺开发。模型适配国产算力,支持本地私有部署。
解读: 洗衣液里的去污酶、食品加工用的淀粉酶、制药用的合成酶,过去主要靠从自然界里找、再反复试验筛选,成功率低、周期长。"算得准、写得出、验得回"这套闭环如果真能跑通,生物制造的研发方式会跟着变。支持本地部署对企业也很实际——自己的工艺数据不用出厂。
8. Ai2 开源科研智能体 Theorizer,专门帮科学家"提假说"
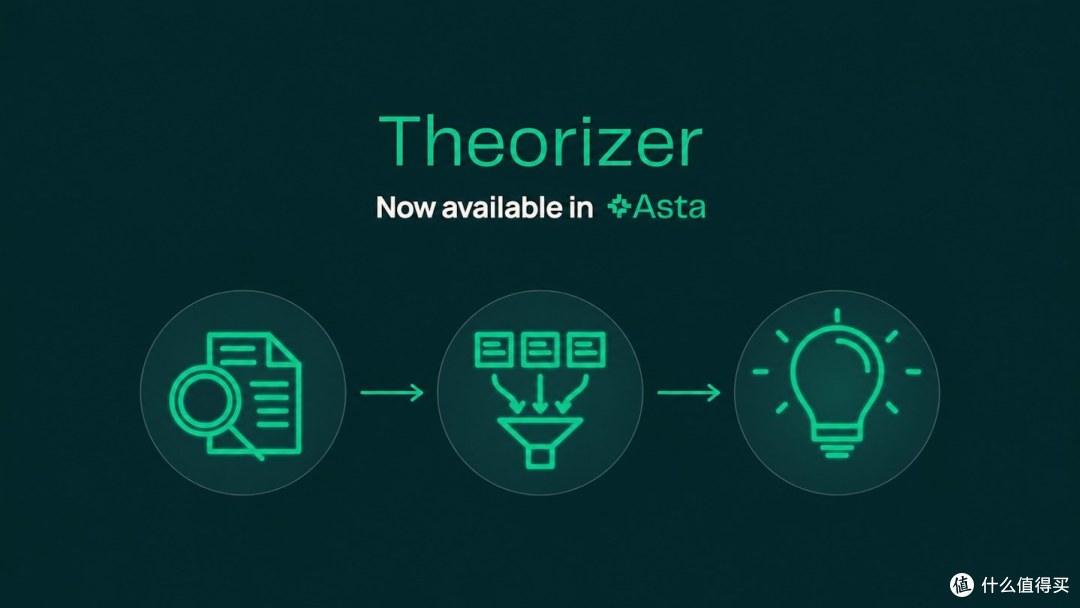
11 月 19 日,艾伦人工智能研究所(Ai2)在科研智能体平台 Asta 中上线 Theorizer,同时开源了代码。它会检索文献,为那些"解释不通"的观测提出候选理论,并且把每条论断都链接到支持它的论文。
官方举了三个案例:一位肺癌研究者靠它提出了三种关于驱动基因阴性肺腺癌如何生长的假说;神经科学上,它给出了 50 个关于 VIP 中间神经元的候选理论;气候数据里,它为秘鲁露点记录的异常给出了一个可检验的解释——这个解释最后被数据否掉了,但正是这次检验,帮研究者找到了问题出在原始数据的估算方式上。网页端使用时 Ai2 承担一定额度的 token 费用,也可以下载开源库在本地跑。
解读: 和"AI 写论文"不一样,Theorizer 干的是更靠前那一步——把一个模糊的异常,变成几个能被逐条验证的假说。那位肺癌研究者说,它给出的理论跟自己花 15 年想到的思路很像,这个细节挺说明问题。当然它也会漏掉文献、会误判原创性,最后拍板的还是人。
热闹的上市敲钟之外,今天更像是一次"AI 往深处走"的集中展示:安全开始留痕,智能体开始接管流程,大模型开始进入实验室。至于这些变化什么时候真正落到普通人的日常里,还得再等等看。
当前文章无评论,是时候发表评论了