









 深耕汽车、数码、AI兴趣领域





5
7
GitHub爆火的N卡算力解锁工具,但对今天的AI玩家意义不大
2026-10-27 18:53:21
0点赞
0收藏
0评论
最近开源社区又整出了一个大活。一个名为 gpu-unlock 的项目在 GitHub 上突然爆火,宣称不需要硬改显卡、不需要刷入第三方 VBIOS,甚至不需要魔改官方驱动,就能直接解开英伟达在 RTX 20、30、40 乃至 50 系消费级显卡上暗中施加的算力封印。
不少极客第一时间去跑了测试,晒出的跑分相当唬人:底层的矩阵乘法吞吐量直接暴涨 50% 到 100% 不等,甚至连笔记本上的 3060 移动端显卡,手搓解锁后矩阵算力都能飙升 65%。
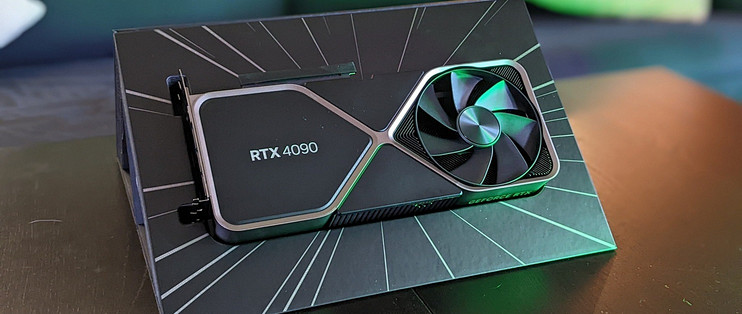
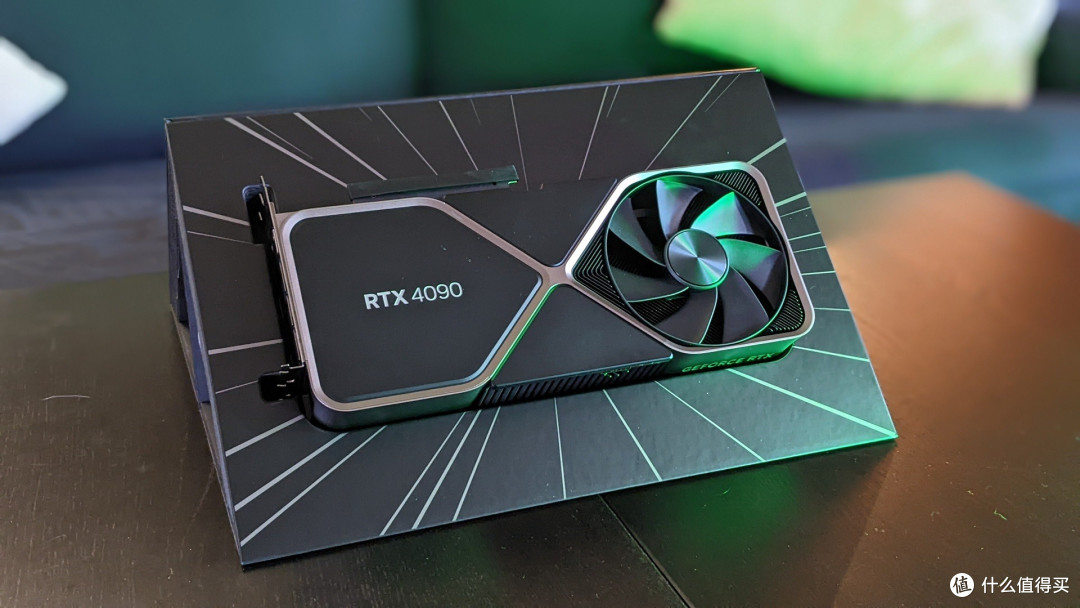
评论区瞬间沸腾了,很多手握 3090、4090 的玩家直呼过年了,觉得手里的游戏卡终于能越级打出专业计算卡的满血性能。但如果你冷静下来,结合当下的 AI 模型生态仔细盘一盘就会发现:这确实是一次极其惊艳的底层逆向工程,但对于绝大多数本地跑 AI 的玩家来说,它的实际意义已经微乎其微了。
老黄到底锁了什么?极客又是怎么撬开的?
要搞清楚这个工具到底有没有用,得先明白老黄当初挥下这一刀是为了什么。
在 RTX 30 和 40 时代,消费级旗舰卡的硬件底子非常强。英伟达为了防止企业、实验室买一堆便宜的 3090、4090 去替代昂贵的专业计算卡,在固件层面耍了个心眼,专门把 BF16、带 FP32 累加的 FP16 以及 TF32 这三个特定精度的张量指令吞吐率给砍了一半。
而这次的 gpu-unlock,在思路上算是一脉相承了当年破解 CMP 矿卡的骚操作。它把自己编译成 Linux 内核模块塞进 initramfs 里,赶在英伟达官方驱动加载之前抢先运行,利用 GPU 安全启动固件的漏洞拿到受保护寄存器的写入权限,直接把被限制的速率改回满血状态。紧接着,触发一次 PCIe 的功能级重置,相当于让显卡不断电重启一次,最后再让正常的英伟达驱动接管。此时官方驱动完全被蒙在鼓里,以为自己接手的就是一张正常初始化的显卡。
听起来极其优雅,对吧?
客观地说,这个解锁并非完全没用。对于一些预算有限、还在用 3090/4090 攒机训模型的高校实验室或小团队,由于 PyTorch 训练默认走的就是 BF16 配合 FP32 累加的路径,解锁后在纯计算密集型场景下,确实能白嫖到最高 50% 左右的性能提升。此外,如果你还在用 ComfyUI 跑 SDXL 或者初代 Flux 这类老模型,且坚持使用纯 BF16 精度,文生图的速度也能快上五六成。
但问题恰恰就出在这里,它解锁的,是属于过去的算力。
从 BF16 到 FP8、FP4,时代变了,高精度的车道已经没人走了
如果这个工具早诞生两三年,绝对是载入史册的神器。因为在两三年前,开源社区的模型权重和推理框架还没有那么成熟的量化方案,大家跑模型基本都是默认挂在 FP16 或 BF16 上硬算,老黄砍掉的那一刀正好砍在所有人的大动脉上。
但看看现在的 AI 生态,风向早就彻底变了。现在的模型精度是越来越低的。
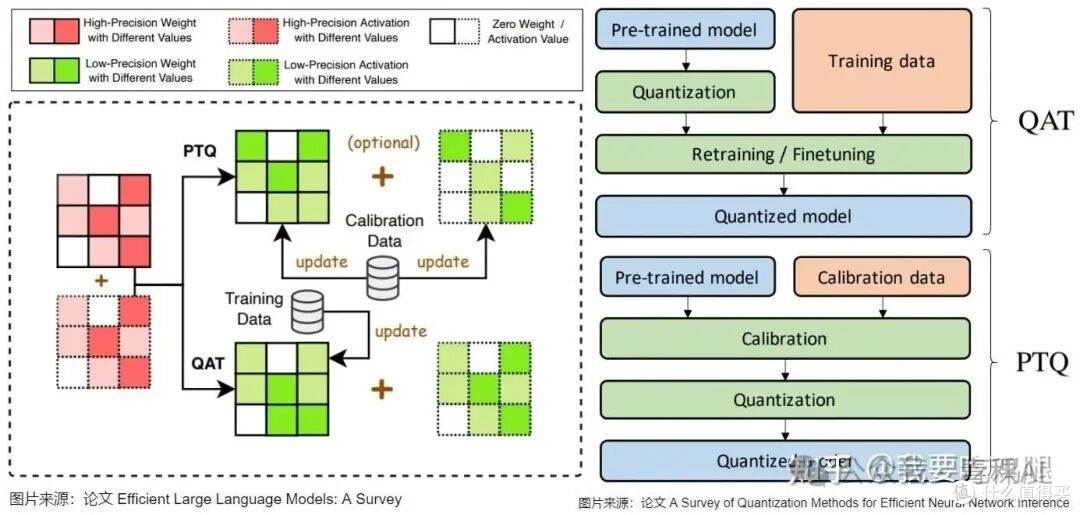
以前大家还在死磕 BF16、TF32 这几个高精度,而现在无论是大语言模型推理,还是像 Minimax-H3、Krea 2 这样的新一代主流单机模型流水线,整个行业都在全面向低比特狂奔。现在大家日常部署用的最多的是什么?是 FP8、INT8,甚至是 FP4、INT4,比如主流的 W8A8、W4A8、W4A4 以及 NVFP4。
原因很简单:把权重和激活值压到 8 位甚至 4 位,不仅能把显存占用砍半再砍半,还能直接调用显卡里吞吐量高得多的低精度计算单元,在几乎不损失肉眼感知质量的前提下,让速度成倍起飞。
就连消费级显卡最常用的 llama.cpp 和现在的 ComfyUI 主流工作流,底层也早就做了针对性绕行,要么直接走 INT8/FP8/FP4 的低精度路径,要么在半精度下改用不限速的 FP16 累加路径,根本不去碰老黄限速的那几条指令。
说白了,gpu-unlock 费尽千辛万苦,把老黄在 BF16 和 TF32 高速公路上设的收费站给拆了;结果抬头一看,现在的 AI 车队早就全开上旁边的 FP8 和 FP4 磁悬浮轨道了。你把老路修得再宽,平时根本没几辆车往那儿走,自然也就发挥不出什么实际作用。
算力过剩的时代,真正的脖子卡在显存带宽上
退一步讲,就算你头铁,非要在本地用原生 BF16 精度去跑大语言模型推理,解锁之后生成的 Token 速度就能翻倍吗?
答案依然是:基本没戏。
做过本地大模型部署的人都知道,LLM 推理,尤其是生成阶段的 Attention 计算,是一个典型的访存密集型任务,而不是计算密集型任务。真正的瓶颈根本不在于 GPU 的核心算力有多强,而在于把庞大的模型权重从显存搬运到计算核心的这段显存带宽。
这也是为什么高端服务器卡必须上昂贵的 HBM 高带宽显存;也是为什么某些统一内存设备虽然能拿几十上百 G 的大内存当显存用,但因为内存带宽太低,平时只能跑跑激活参数小的 MoE 模型,一旦遇上大参数的稠密模型,速度就会断崖式暴跌。
同理,在 3090 和 4090 上跑大模型推理,核心算力本来就是严重过剩的。显卡绝大部分时间都在算力等数据。你用工具把核心算力再翻一倍,唯一的区别就是计算核心干完活的速度更快了,然后花更多的时间在那里干等着显存把下一批数据送过来。
那些动辄提升 60%、100% 的截图,全是在跑纯粹的底层矩阵乘法 Benchmark。这就好比你拿鲁大师的理论跑分去衡量 3A 游戏的实际帧率一样,脱离了显存带宽谈推理算力,基本都是耍流氓。模型越大、层数越多,这个解锁带来的实际收益就越趋近于零。
写在最后
除了算力方向过时和带宽瓶颈之外,gpu-unlock 在实用性上也有很高的门槛。因为它需要在驱动加载前注入并重置 PCIe 设备,目前基本只能在 Linux 下愉快玩耍;如果在单显卡的 Windows 主机上冷启动重置 PCIe,大概率迎接你的直接就是黑屏。而且它利用的是固件层面的安全漏洞,只要英伟达下定决心在下个版本的驱动里打个补丁,这招随时就会失效。
当然,我们还是得给开源社区的极客们脱帽致敬。这两年借助 AI 辅助逆向,民间大神突破硬件厂商软件阉割防线的速度越来越凶猛,从早前的矿卡魔改、A卡强开 DLSS,到如今直接改写受保护寄存器,软件层面的封印确实越来越难困住硬件的本来面目了。
只不过对于咱们普通玩家来说,看个热闹、点个 Star 也就够了。手里的 3090、4090 老老实实挂着 FP8 或者 FP4 的量化模型跑着就行,实在没必要为了那几个已经退居二线的 BF16 指令,去折腾自己的系统内核。