

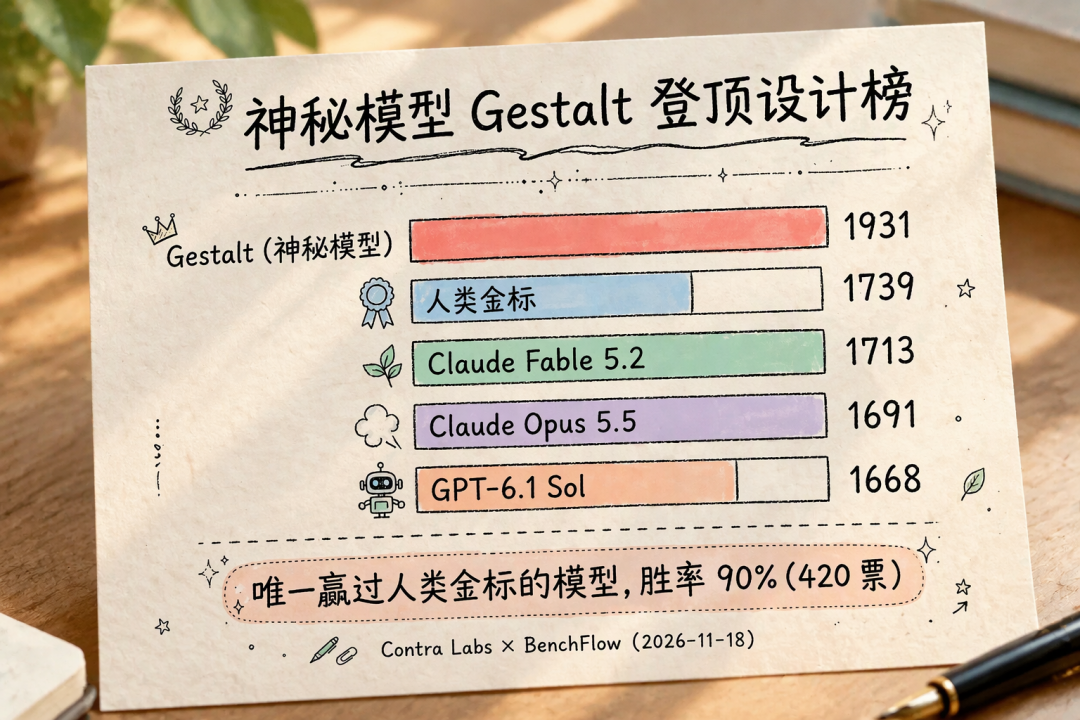
一个连开发方都没公开的 AI 模型,第一次露面就把专业设计师裁判的榜单踢到了自己脚下。设计接活平台 Contra 的研究团队 11-18 发布前沿设计榜(Frontier Design Benchmark),匿名模型 Gestalt 以 1931 分 Elo、90% 胜率登顶,是唯一排在人类参考稿(1739 分)前面的模型。榜单题目取自真实商业委托:多页网站、营销落地页、带操作流程的 Web 应用,35 名设计师在不知道哪份是人类作品的前提下盲投了 4311 次。哔哩哔哩微博微博
90% 胜率和对人类 20 比 8,是两个问题
流传最广的两个数字其实分母不同:90% 是整组配对比较的胜率,专看与人类参考稿的直接交手,评委是在 28 次里选了它 20 次。分数结构上,排第二的不是任何模型,而是人类作品的金标,第三名的具名模型 Claude Fable 5.2(1713 分)被它甩开 218 分。而且它不是蹲在榜上慢慢爬上去的——有作者梳理榜单记录,刚上线时人类参考稿还排第一,Gestalt 是后来才出现,一出现就把所有人都甩开了。知乎哔哩哔哩哔哩哔哩知乎
比名次更值得看的是随榜公开的"AI 味"检测:分数越高越像 AI 做的,人类参考稿只有 0.9,而 Gestalt 约 1,Claude 系列在 31 到 38、GPT 系列在 41 到 53。设计师评委投票时不知道作者是谁,但机器给出的"像不像 AI"分数,和人的偏好得出了同一个方向:Gestalt 的成品在这一轮里几乎不带常见 AI 网页的套路感。哔哩哔哩
是谁家的:官方一个字没提,传闻一个来源没有
Contra 官网对 Gestalt 的全部说明是"一个还在隐身中的高质量设计模型"。研究说明里确认正在与背后的团队合作,但没有写团队名字。哔哩哔哩知乎
传闻方向则互相打架:中文圈有帖子说是国产,被问出处只回一句"外网透露了";也有创业者断言它不是几家美国头部公司、是美国的,同样没给来源。名字倒是有指向:Gestalt 取自格式塔心理学,意思是整体大于部分之和——排版、配色、留白单看都合规,拼在一起好不好看全靠整体判断,起这个名字就是冲着"品味"去的。哔哩哔哩知乎
一个容易误导的巧合:人大 GeWu-Lab 确实公开过一个同名的多模态开源项目,论文、代码都在,但缺的恰恰是一条能把榜单参赛者和仓库作者连起来的证据,现阶段只能当撞名。知乎
匿名参测本身不是新闻。今年 4 月,100B 参数的匿名模型"大象"冲上过 OpenRouter 热榜第一;7 月,匿名模型 Kivine 在外网开发者社区被广泛猜测是 Kimi 家的新模型;10 月现身编程赛道的代号"太空兔",最终由 MiniMax 发新模型认领。按这个惯例,Gestalt 的揭晓窗口大概率不会太远——通常就在模型正式发布前后。36氪36氪36氪
这张榜赢不了的部分
榜单的权威性有一条需要说明的边界:赛事由 Contra 自己主办,X 上读者给原帖加了"没有独立核实"的提示;其他模型由 Contra 统一跑,Gestalt 单独接入测试,重试次数和花费都没有公开。它验证的是真实委托下一次性成品的整体观感,而按客户反复改稿、遵守带流程的产品约束、在预算和工期里交活,都不在盲测规则之内——"AI 赢了设计师"目前成立的版本,是赢下了这一轮盲投里的参考成品。哔哩哔哩
对普通用户,这张榜实际回答的是另一个问题:AI 的设计成品已经跨过了"一眼假"的门槛,近到专业裁判在不知道作者的情况下愿意把票投给它。下次拿到一份设计产出,先别看署名——这轮榜单上,连设计师自己都分错了方向。

当前文章无评论,是时候发表评论了