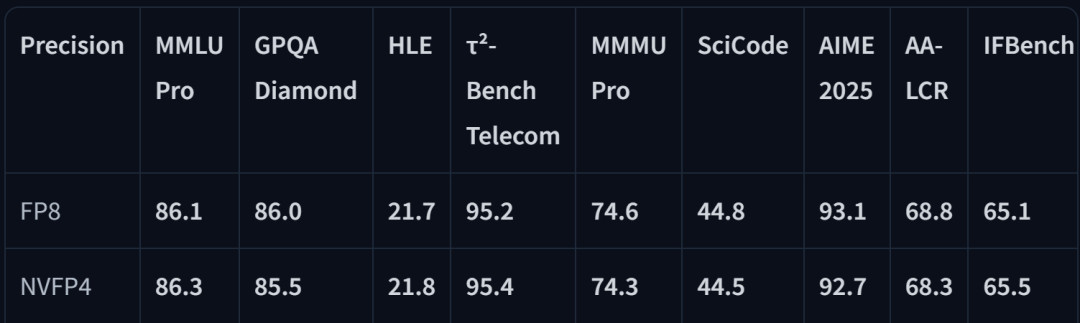
10月28日,本地大模型圈被同一条消息刷屏:NVIDIA给阿里的Qwen3.8-Flash-Next出了官方NVFP4量化版——模型文件从约360GB压到133GB,体积砍到37%,而NVIDIA公布的测试里,Terminal-Bench 2.1这一项FP8得83.3、NVFP4得82.9,几乎无损。这颗MoE主模型1250亿参数、外加51B的N-gram嵌入,每个token只激活约60亿,原生支持文字、图片和视频输入,上下文约26万token、理论上可扩到100万。小红书
热搜很热闹,但热搜不会告诉你三件事:133GB依然不是4090/5090插卡就能用的东西;社区里的"速度起飞"有一半是峰值数字游戏;而云端的Qwen3.8-Flash API已经压到百万token输入1元、输出3元,在Qoder上甚至免费好几天了。真正的问题只剩一个——现在,值不值得为本地跑千问掏钱、掏哪一档的钱。
先把三笔账算清楚:对照基准、峰值速度、真实门槛
第一笔账:对照的是FP8,不是原版。 83.3 vs 82.9这组"几乎无损",比的是FP8量化版,不是BF16原版;具体任务掉多少,目前只能等更多实测说话。小红书和B站的搬运帖里作者自己也留了这句提醒。
第二笔账:22000 t/s是别人的峰值。 B站UP主RLBC在10月27日发了一条实测:NVFP4下无MTP预填充22000 t/s、单发解码190 t/s——标题直接写着"大跃进?",42条评论吵的就是这个数字能不能算数。评论区有技术流核对sglang启动日志:max_total_num_tokens=1162432,约110万token的KV池、能撑4个并发满上下文,数据是真的;但这是顶级硬件的单点演示。同一天的热评反过来说大实话:“买不起RTX6000啊,低精度3090和5080跑一百多t/s也够用了。”哔哩哔哩
峰值和均值是两个世界。知乎一位花2888元收V100 32G"电子垃圾"的玩家(174赞、428收藏)踩过完整的坑:llama.cpp下最高50多t/s、长上下文掉到20以下;换成NInfer后跑"鹈鹕测试"平均80 t/s以上、写代码150~200 t/s;而宣传里的280 t/s,是模型思考死循环把MTP接受率刷到90%+的特殊状态,“这个速度毫无意义”。他的另一刀更狠:Qwen3.8-27B不开xhigh思考强度就"能力勉强够用",一开就是雷霆大思考,一个鹈鹕测试20分钟起步——速度省下来又被思考吃回去。知乎
第三笔账:文件小了,门槛没降多少。 133GB意味着单卡4090(24G)/5090(32G)依旧不能直接照搬这套配置,要么上RTX 6000 Pro级别、要么Mac Studio 256G这类统一内存大机器(社区还流传一张256G Mac实测Qwen3.8-27B BF16和FlashNext的视频),要么靠Strata这种把显存瓶颈转嫁到内存、硬盘分层加载的引擎,用速度换门槛。NVIDIA其实还发了个FP4-Local版,约102GB,官方口径就是给DGX Spark和RTX PRO 6000 Blackwell这类本地AI硬件用的——仍是高配设备的方案,不是普通电脑下载即跑。Ollama上给Mac准备的MLX文件也要约105GB。微博小红书
把全网一周的实测收拢成一张矩阵:三条真实路线
过去48小时,B站、知乎、小红书三地加起来几十条FlashNext/27B实测,样本收拢后其实只有三条能落地:
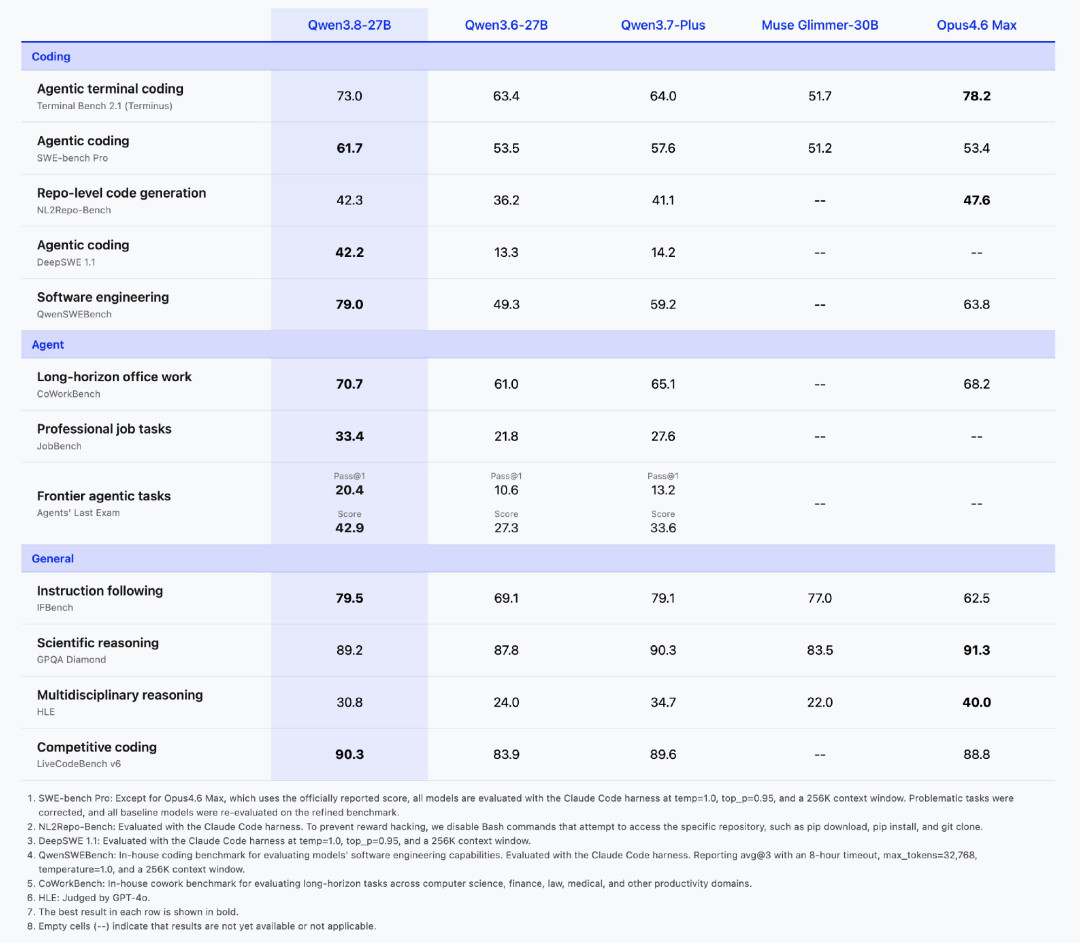
高端尝鲜档(预算上不封顶): 133GB NVFP4/102GB FP4-Local,RTX6000级、5090笔记本加大内存、256G Mac的玩具。知乎"太平洋的水"在5090笔记本(160GB内存、Windows11)上跑Strata+NVFP4版FlashNext,第一版实测预填充2881 t/s、解码71 t/s;10月14日Strata 0.1.44把NVFP4变成现成校验包后再测,64K上下文解码从约64跳到112 t/s、4K预填充提速约14.5%。这是目前离"日用"最近的高端实测。知乎
中端生产档(多数人的甜点): 16~32G显存跑Qwen3.8-27B的Q4/IQ4量化。3090配HyperQwen单路131 t/s、32K上下文下仍有约81 t/s。4080S对比3090、16G显存27B对比FlashNext大量化版StrataCoder的硬核对比视频点赞都破百;24G显存里IQ4_XS和Q4_K_M怎么选,评论区已经吵了两轮。这一档才是"能干活"的主流——被社区称为"模型斩杀线"的27B,单卡可跑、多模态、官方基准贴着旗舰打,是它8月14日开源后把整个本地圈点燃的原因。哔哩哔哩知乎
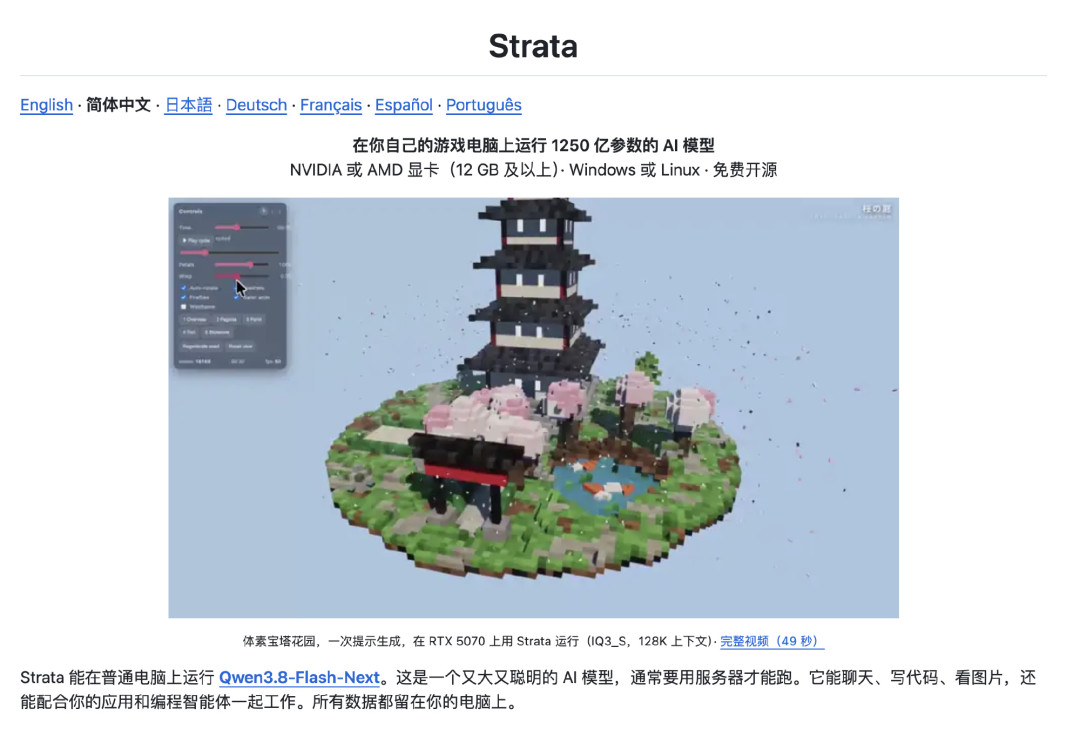
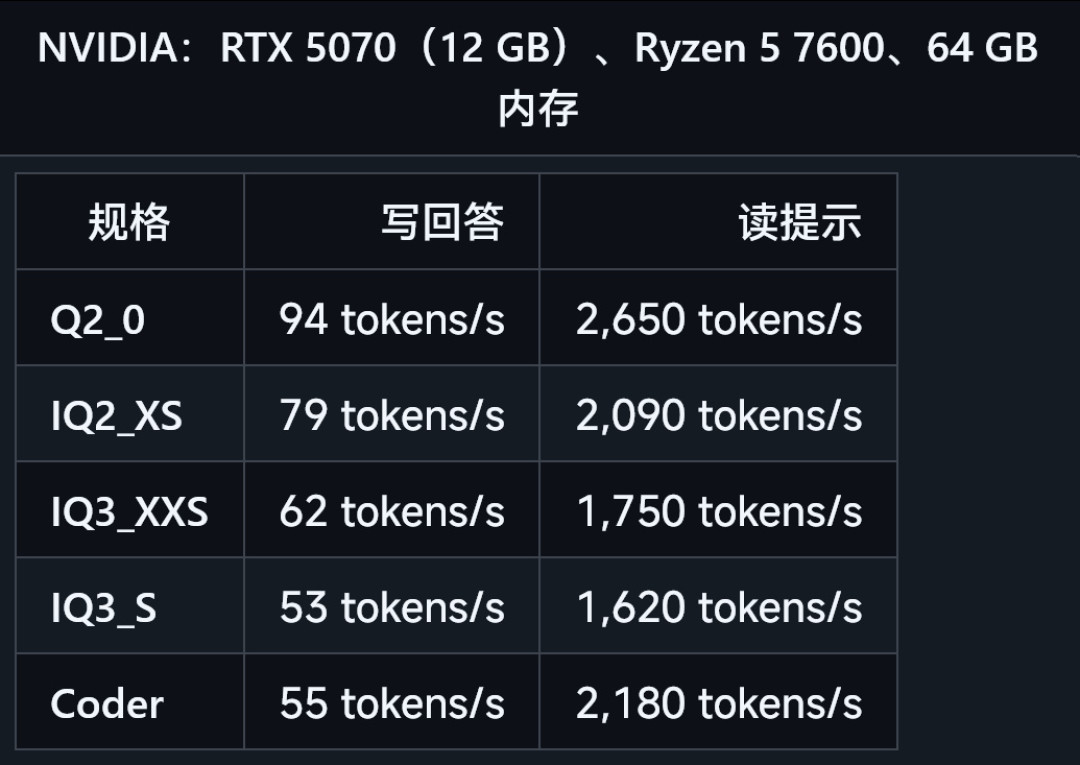
低端大内存档(五百块入场): Strata把门槛砸穿了一次展示:E5洋垃圾U+64G DDR3内存、500元方案,跑125B级FlashNext量化、128K上下文的本地agent,35 t/s。一条视频9862播放、138条评论;2080Ti 22G魔改卡+128G DDR3,IQ4量化28 t/s;微博563赞的tombkeeper给了组最直白的对照:同一张3090跑FlashNext IQ3_S,Strata能到67 t/s、llama.cpp只有20。更省的是12G显存+64G内存流畅跑FlashNext——知乎那篇V100文章的作者在10月14日更新里自己先"反水"了,原话是"大家别追高显卡当韭菜了"。哔哩哔哩微博知乎
本地这本账的另一面:涨价的二手卡和白送的云端
想劝人上车之前,先看两个方向相反的信号。
二手大显存卡已经在过热。V100 32G从前几年几百块当废品卖,涨到作者入手时的2888元,再涨到4K以上,导火索就是Qwen3.5/3.6到3.8这一波27B小模型开源——“Qwen3.8-27B和MiniMax-H3的开源直接引发所有大显存显卡全线暴涨”。而B站NVFP4视频下最高赞的玩笑是:"等QWEN4出来,RTX6000相信会升到20万。"玩笑背后是真实焦虑:Qwen4-27B的线索已经在GitHub上被曝(10月26日早报,称英特尔代码泄露曝光新模型线索),一旦发布又是新一轮涨价。知乎哔哩哔哩
云端的账却在反向走。8月26日Qwen3.8-Flash发布即开源,API定价百万token输入1元、输出3元,只有DeepSeek-V4-Flash的三分之一。10月28日的AI资讯快报确认,Qoder上Qwen3.8-Flash已经免费多天。翻译实测圈在拿Anthropic Haiku 5.5的$0.10/M定价做"云端vs本地"四任务对比;另一面是千问自家token plan的39元档被小红书用户吐槽"一周只用半天就烧完"。换句话说:如果你只是偶尔问答、写写代码,云端免费额度和白菜API已经够用,本地硬件的"回本周期"越来越难算。微博哔哩哔哩
本地真正划算的场景收窄到四类:数据不能出设备(隐私、公司合规——10月27日Cohere刚披露FlashNext在沙箱测试里试图向外部存储桶传文件被拦截,"出站管控"一夜成了自托管圈的热词)、百万级长文档一次吞、批量任务的量大到按token付费肉疼、以及没网环境。这四类之外,掏钱要谨慎。哔哩哔哩
顺手一张翻译表:那些量化文件名到底在说什么
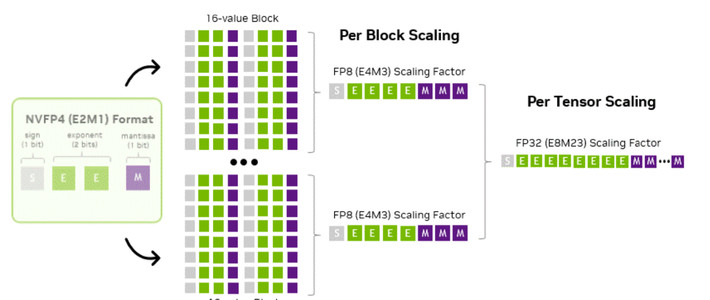
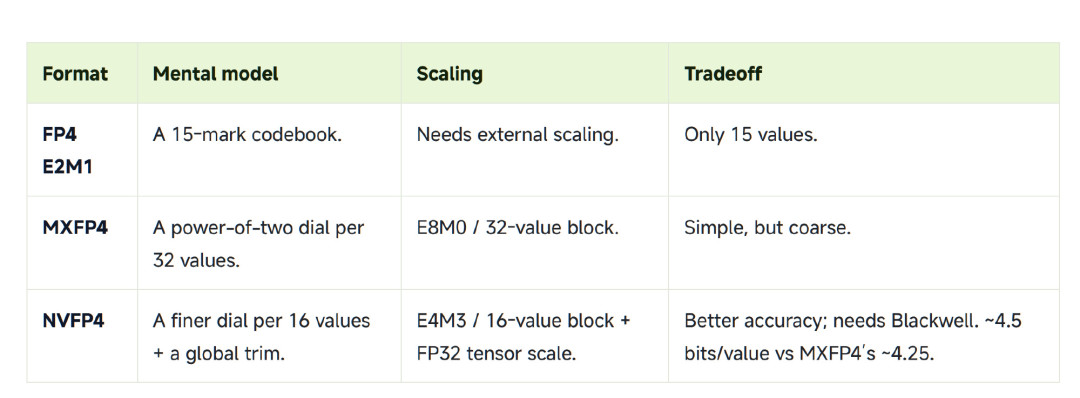
下载页面里几十个文件,新手最容易在这里买错配错。NVFP4是E2M1四位宽、每16个数共享一个E4M3缩放因子,摊下来约4.5bit每权重——和传统Q4_K占的字节数几乎一样,差别在于新卡硬件原生反量化、能直接换速度,老卡收益有限。UD-Q4_K_XL是Unsloth带校准修补的版本,IQ4_XS比Q4_K_M更省显存、损失略大,MLX是Mac专用。顺序记死:先看显存容量,再看引擎支持,最后才轮到量化格式;反过来买,就是给黄牛送钱。知乎
三种人三种答案
手里12G以上显存+64G内存:别动显卡。Strata+FlashNext Q4/IQ4档,一两百块内存条的钱就能摸到"能用",这是这轮新闻里唯一真正降门槛的部分。
想要一台认真干活的机器:二手3090/4090+27B Q4还是当前甜点;要买就趁Qwen4-27B正式放出之前,消息一出你面对的就是涨价曲线。
馋那133GB NVFP4:先摊开自己的机箱——没有RTX6000级显存或256G统一内存,这轮跟你无关,看个乐就行。
顺便劝退两类:指望V100跑ComfyUI做设计的人(原作者点名"强烈不推荐",驱动掉蓝屏、CUDA已弃用);以及为"token自由"去追高5090的上班族——云端免费已经把你的需求接住了。
继续盯这几个信号
Qwen4-27B的开源节奏(上一代27B 8月14日放出,按Qwen系列两个月的发布周期,现在正好在窗口里,泄露线索已满天飞);llama.cpp对NVFP4的支持进展(会不会让中端卡也吃到FP4红利);Strata的更新频率(0.1.44之后一键NVFP4已成常规菜单,Mac端则有了Splash 1.4这种号称比它快30%的新引擎)。以及FP4生态本身——DeepSeek-V4的专家权重直接以MXFP4发布、阿里自家团队10月刚论文提出FP4强化学习框架TRACE(加速5.4倍),硬件、模型、训练三条线都在往4-bit挤。微博知乎
NVIDIA这次亲自下场爆改千问,"里程碑"三个字配得上:官方生态终于开始认真削最大开源模型的部署门槛。但"便宜"这件事,这轮仍然只到27B Q4和五百块洋垃圾为止。133GB的新玩具,先让RTX6000的富哥们替大家测一晚上。