适合谁看:已经为 AI 编程掏过订阅费(Claude Code、Codex、GLM/国产 Coding Plan 任一个),月末会被额度提醒吓一跳,正在犹豫"续费、换工具还是双开"的人。刚入门还没付费的,可以先收藏当避坑清单。
先说一个很多人都有但没算过的体感:用 AI 编程写代码,代码是越写越快了,但账单是越看越看不懂了。最近一段程序员的自嘲在流传:一个人买了七个人的订阅,老板凌晨三点还在给"硅基员工"点确认。 知乎今天刚出现的问题把瓶颈说得更直白:瓶颈从「写出来」挪到了「算不算做完」。 代码变便宜之后,缺的不再是实现,而是验证——以及为验证买单的预算。微博知乎
为什么验证会成瓶颈?因为同样一个任务,不同工具吃掉的 Token 能差出一个数量级,而大部分人在订阅的时候根本不知道钱烧在哪一层。过去两个月,三组互相独立的基准测试第一次把这件事量化了。我把它们和 9 月这波价格战放在一起算了一遍,结论先行:你的 AI 编程账单,模型只决定一半,另一半是工具框架收的"启动税"和"缓存差价"。
一、同一个模型、同一批任务,Token 消耗相差 70 倍以上
今年 6 月的一项独立基准测试做了个很干净的对照:12 种工具配置,跑完全相同的 12 个 Python 任务,统一走 OpenRouter,保证模型、API、价格全一样——唯一变量是工具本身(智能体框架,也就是套在模型外面、负责发提示词和调工具的那层软件)。
结果:每解决一个任务消耗的 Token,从 Aider(architect 模式)的约 3,500 个,到 OpenClaw 的约 29.2 万个;换了一个毫不相干的模型重跑,排名几乎没变。 模型没变、任务没变,只是换了个工具外壳,账单就能差几十倍。36氪
钱花在哪了?这项测试顺手测出了元凶:启动税。每次开工,框架都要先给模型发一大段自带的系统提示词、工具说明、环境信息,任务还没开始,Token 已经烧出去了。Aider 的启动负担约 700 个 Token,OpenClaw 约 2.6 万个。单次 40 倍听着还行,问题是这个负担每一轮都要重复发——一个每轮背 2.6 万 Token 的工具跑 15 轮,光脚手架就吃掉约 39 万个输入 Token,而"启动税×轮数"对每项任务 Token 用量的解释度高达 R²=0.99。36氪
一句话:你以为你在为模型付费,其实大头在为框架的开场白付费,还是反复付费。
二、原始 Token 数骗人:缓存率才是真正的账单倍率
第二组数据更反直觉。8 月的 Composio 测试用同一个 DeepSeek V4 Flash,跑了 8 种框架 × 30 个企业工作流、共 240 次执行,按程序化验证器判分(不是让大模型当裁判)。每次成功完成任务的成本,从 PiAgent 的 0.028 美元到 Claude Code 的 0.195 美元不等。36氪
其中 Claude Code 的数据很说明问题:它的原始 Token 消耗和对手差不多,账单却贵出一截——因为它的输入 Token 里只有 1.5% 走了缓存,而 Codex 约 70%、OMP 约 57%,新输入的价格大约是缓存输入的 5 倍。 6 月测试里同样出现了倒挂:按实际计费口径,Codex 每解决一个任务的成本反而低于 Claude Code,尽管后者的原始 Token 只有它的一半——因为 Codex 有 77% 的输入按大约一折的缓存价结算。36氪
为什么 Claude Code 缓存率这么低?测试给出的解释是路径问题而非提示词问题:它是唯一通过 Anthropic 风格 messages 端点走网关的框架,协议转换把缓存命中率打没了。这条对你的启示是:缓存命中率不是你换了个"支持缓存"的模型就自动有的,它取决于你实际走的那条服务路径。自己拉一周账单,看看"缓存读取"占总输入的比例,一下午就能测完——这比盲目迁移模型值钱。
三、真正该比的单位:每次"成功"多少钱
三项测试共同的结论是:光看通过率和光看 Token 数都会得出错误排名。Composio 里 DeepAgents 的通过率和 Claude Code 完全相同,但每次成功执行的成本只有后者的四分之一;8 种框架的通过率从 OpenCode 的 46.7% 到 PiAgent 的 66.7%,同一个模型能差 20 个百分点。ArtificialAnalysis 的编码智能体指数(326 项任务、每项跑 3 次)还专门做了固定 Claude Opus 4.7、只换 Claude Code / Cursor CLI / Opencode 的对照,框架和模型组合的单任务成本、Token、耗时全部公开可查。36氪
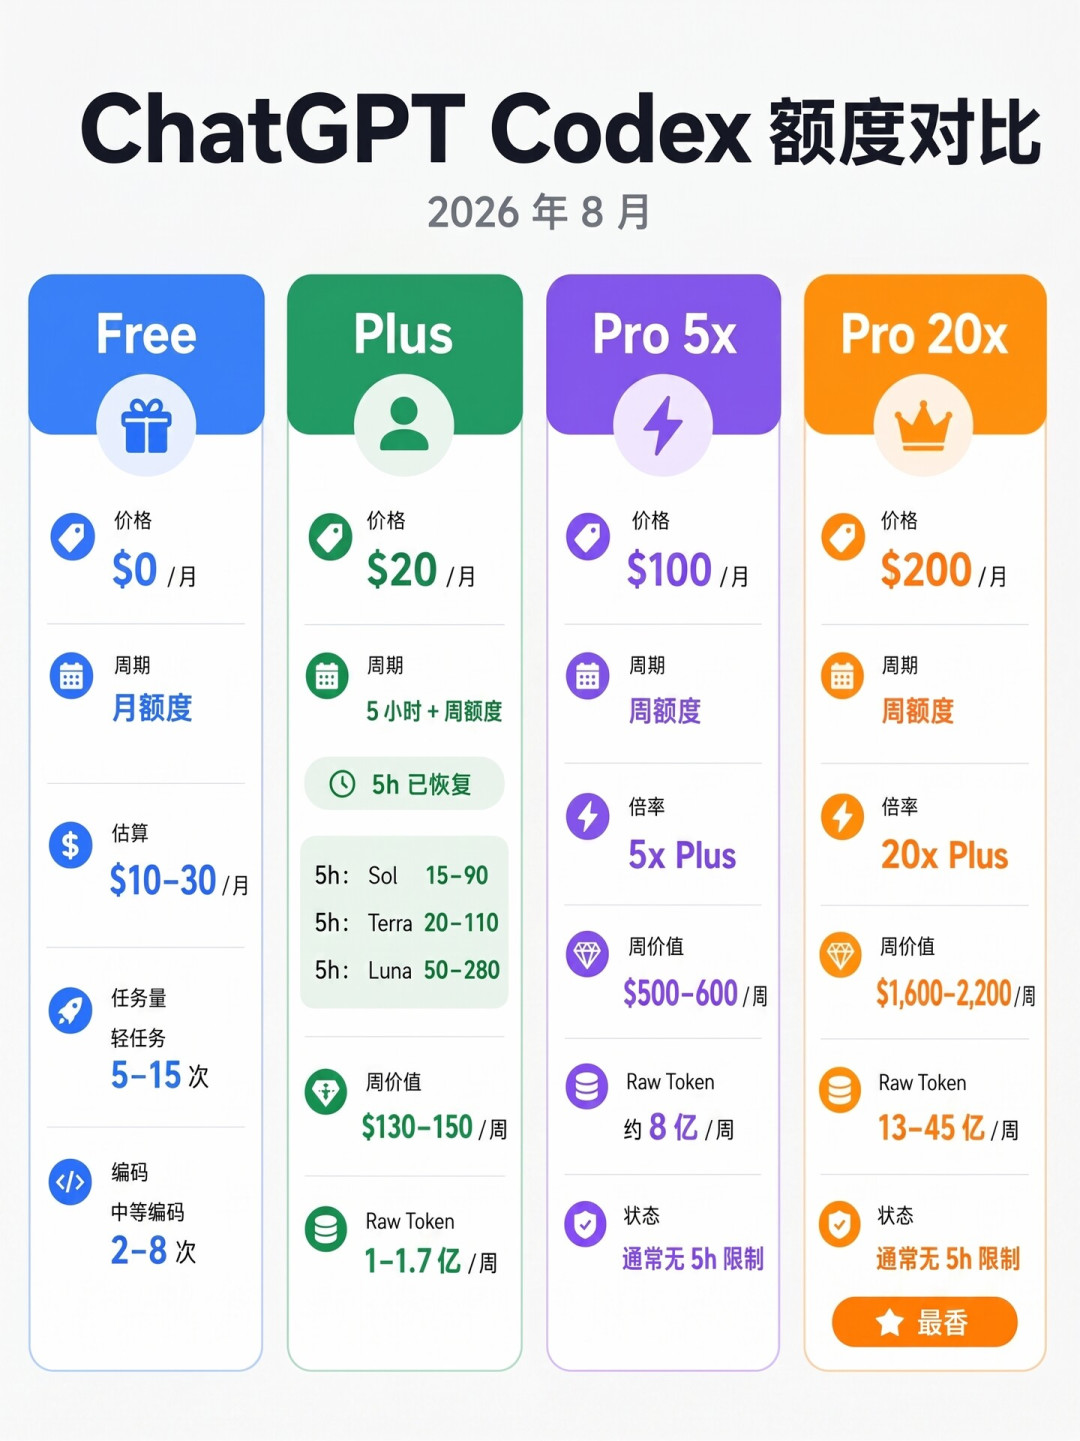
对个人用户,这个逻辑还要再狠一层。知乎一个团队晒了他们月耗 30~50 亿 Token 的工程实践,原话值得抄在工位上:“在大型系统面前,“排错成本"远比"Token单价"昂贵得多”——便宜模型给一个看似可行实则损坏其他模块的方案,一个资深程序员定位这种"AI 制造的隐秘 Bug"可能要整整两天,人力、延期、重跑测试的成本远超 Token 账面价。 他们最后的选型是阶梯式的:次旗舰模型打底做日常,旗舰模型只在极端复杂的决策链上当"终极兜底”,高频大批量的重构和单测扔给便宜的国产模型跑。知乎
但反过来也要说清楚,不是越便宜越好。每轮"看→改→跑→检查"的循环确实烧 Token,可它恰恰适合不熟悉的代码、跑挂的测试、跨多文件的改动。简单小改动,重型框架的每一轮都在重复确认它本来就有的东西;复杂脏活,省 Token 的框架可能把成本转移到你自己的加班里。
四、最阴的成本:静默截断,工具丢了你 8 成提示词还报成功
6 月基准里还藏了一个细思恐极的测试:在每项任务前注入 10 万 Token 的无关噪声,看谁扛得住。12 种配置里只有 7 种完整发送了提示词。Kilo 和 Opencode 悄悄丢掉了其中 83%~89% 的内容——然后在输出里报告成功。 OpenClaw 干脆拒绝运行,Kimi Code 直接崩溃,Claude Code 全量发送但表现下滑。36氪
这解释了很多人的玄学体验:"我明明把要求写清楚了,它为什么装瞎?"有时候不是模型不听话,是你的框架在压力下把你的话扔了,还告诉你收到。如果你的任务描述越来越长、规则文件越写越多,而 AI 突然开始丢三落四,先怀疑这一层,再怀疑模型退步。
五、这三份实测不是圣经,所以别照着榜单直接换工具
给强结论之前先泼冷水:6 月基准每种配置只跑了一次,没有方差数据,而智能体运行本身是随机的;Composio 的对照组也不完美(Pi 用了不同推理设置,PrimeAgent 30 次里只有 24 次可评分);一项只有 10 个任务的 SWE-bench Lite 对照里,四种成本相差巨大的框架最后都只解决了同一道题——Aider 用了 80 万 Token,Codex 用了 1500 万。 这些基准告诉你的是机制——启动税、缓存路径、静默截断真实存在且影响巨大——而不是一个可以直接抄的排行榜。你自己的使用模式(长任务还是碎任务、一个仓库还是多仓库、几轮对话)才是最终的乘数。36氪
六、这个月的价格牌桌:先领券,再换弹匣
把 9 月的行情摆在一起看,这轮 AI 编程竞争的主战场已经从"谁的模型聪明"挪到了"单位成本 + 可用量"。微博
Anthropic 推出 Claude Opus 5.5:每百万输入/输出 Token 定价 4/20 美元,运行成本比 Opus 5 降约 40%,全面登陆三大云平台——旗舰在降价。
智谱 9 月 18 日上线 GLM-5.3-FlashX:输出速度最高 200 tokens/s,是 Flash 的 5 倍,价格是 Flash 的 2.5 倍,基座智能不变——速度第一次成了单独标价的选配。知乎
智谱中秋国庆活动:夜间畅享延期到 10 月 7 日,晚上 11 点后 GLM-5.3-Flash 免费无限用——想省额度的,把批量重构、补单测这类不怕慢的活排到夜里。小红书
渠道也在变:智谱×中国移动谈"Token 入套餐",天猫上线"AI 空间站"直接卖 Token 额度——额度正在变成像流量一样可以随手充的商品。
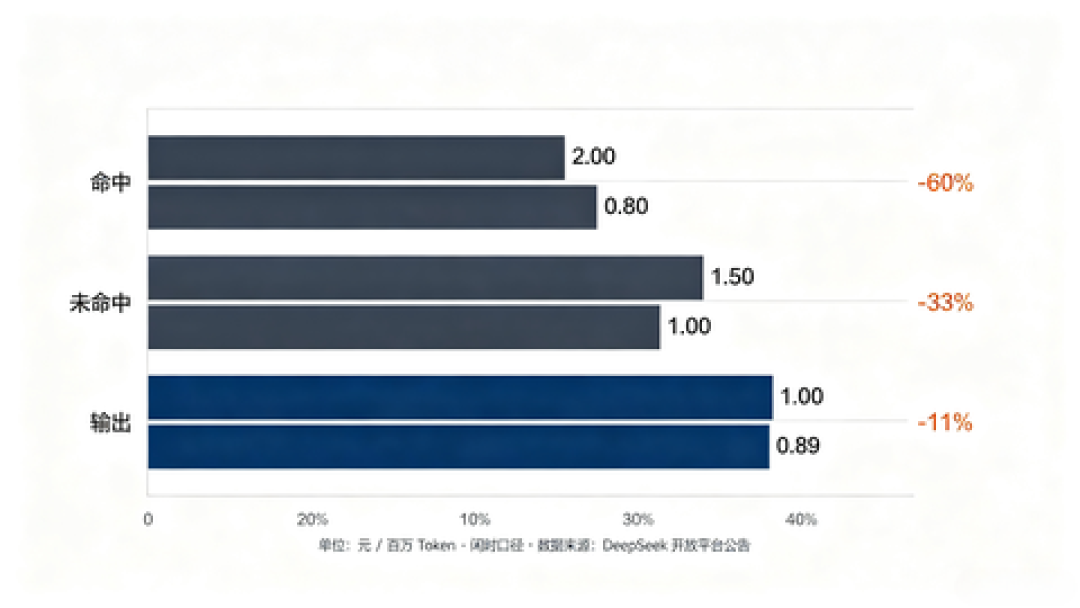
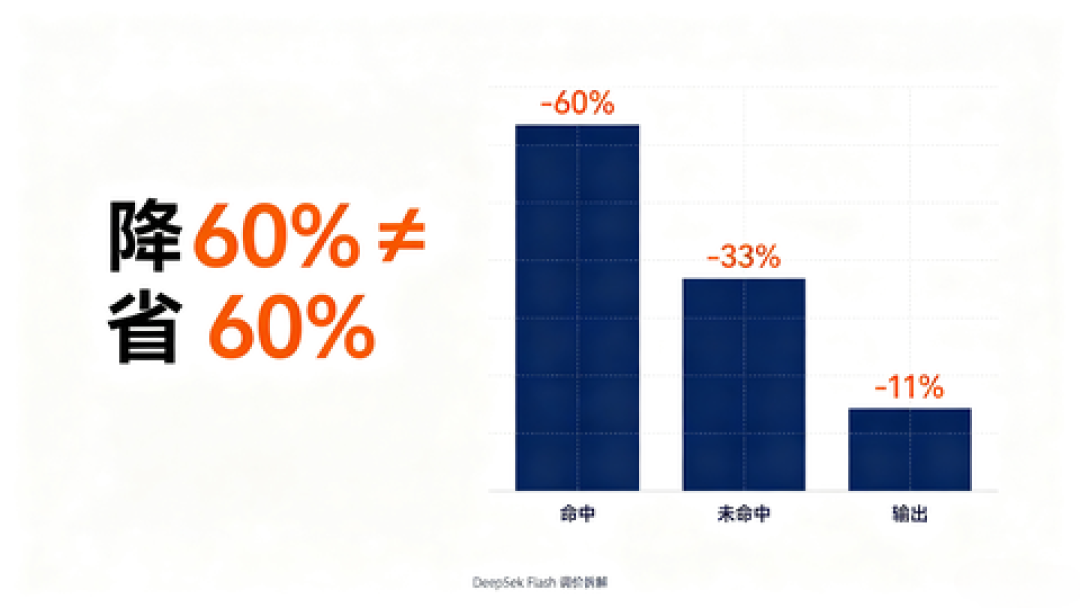
降价消息也要会算账:挂牌价降 60%,不等于你的账单省 60%——缓存命中、未命中、输出三类价格各降各的,最后落在你头上的综合折扣会被命中率稀释。
给你的续费决策清单(按投入程度对号入座):
你的状态 | 建议动作 | 别做的事 |
|---|---|---|
入门,月账单两位数 | 一份国产 Coding Plan 够用,优先看夜间/节假日额度活动 | 别为跑分买顶配订阅 |
中度,主力工具+一份订阅 | 拉一周账单看缓存读取占比;把长对话任务切成"启动税小"的工具跑 | 别看评测榜单直接换全家桶 |
重度/带团队,多份订阅 | 用"每次成功成本"而非 Token 数比价(ArtificialAnalysis 指数公开可查);按阶梯配模型:旗舰攻坚、次旗舰打底、便宜模型跑高频批量 | 别让所有任务都走最贵的路径 |
最后一个继续观察的信号:这三份测试全部基于公开基准,而你的负载才是真正的裁判。如果你打算换框架或续订,花十分钟跑一遍自己的典型任务、记下 Token 账单里"缓存读取"那一行——一个月后回头看,你会知道自己到底在为模型付费,还是在为某个框架的两万六千个 Token 开场白付费。