















14
19
本人故事克隆音色,句意与表达自然分开核
2026-10-09 21:16:10
0点赞
0收藏
0评论
本人儿童故事克隆音色像机器念稿,可以先核文稿句意、样本与当前输入要求,用一段包含对话和叙述的代表稿重新试听。剪映的克隆音色与文本朗读相关能力不等于任何文字都能自动自然表达;像某个人的音色和准确、自然地讲故事,需要分别判断。
本文没有音色相似度或声音效果测试。只使用本人或明确授权来源,不能克隆未经许可的人物。样本条件、支持端、音色和权益从当前说明确认,不给固定秒数或免费承诺。
文稿先写成能被听懂的话
故事里谁在说话、叙述与对话的边界要清楚,长句包含几个意思时先整理成完整表达。修改句子不能改变人物关系、时间与否定;不是为了声音更顺就删掉必要前提。
标点和分段可以帮助表达,但不能保证输出一定自然。数字、名字、拟声词和连续对话需要实际试听,书面上通顺的句子也可能在声音里不好理解。先保留可靠原稿,再改副本比较。
样本和生成输入分别核
按当前要求准备本人或授权的清晰声音样本,环境干扰与多人混说可能影响判断。不要把背景音乐大的录音当理想条件,也不从其他节目截取未经许可声音。是否符合当前输入要求要实际检查。
样本合适不证明新文稿已经通过。每次生成还需核词语、句意、停顿和音量,当前输出支持什么后期处理也要确认。本文不写未经核验的入口名称或“所有端都有”结论。
五步试一段故事
- 保存合法声音来源、授权范围与准确原稿,建立修改副本。
- 按当前克隆输入要求核样本,确认人物与声音来源可靠。
- 选择有叙述、对话和必要长句的代表段,整理清楚句意。
- 实际生成后逐句听发音、停顿与语气,单独记录音色和表达问题。
- 接入视频并导出回听整段,文字、声音与最终版本准确后交付。
失败现象一:音色像本人,故事还是像逐字朗读
回文稿的句意和当前表达支持,先找具体不自然句子,而不是直接放大所有效果。长句试拆为准确短句,必要连接保留;结果还要实际听,不把修改标点当必然解决。
如果当前方案仍不能满足表达,选择合法普通音色或本人重录等适合任务的方式,并准确说明性质。选择取决于故事是否讲清楚,不因已经生成克隆音色就必须使用不合格声音。
失败现象二:单句好听,接起来却忽快忽慢
核每段实际文稿、输出与拼接位置,保持完整词尾和必要呼吸。后期变速或音量调整只按实际能力处理,不能替正确发音,也不能把所有长句压成相同节奏。
回听叙述转对话、角色连接和结尾,孩子听故事时是否能分清谁在讲话。角色语气可以创作,但不冒称本人过去说过这些话;文字和AI声明准确对应内容性质。
选择声音的记录方式
| 项目 | 实际应核内容 |
|---|---|
| 来源 | 本人或明确授权,使用范围合适 |
| 文稿 | 人物、事实与句意准确 |
| 声音 | 发音、停顿、音量与连续表达 |
| 文件 | 工程引用与导出版本对应 |
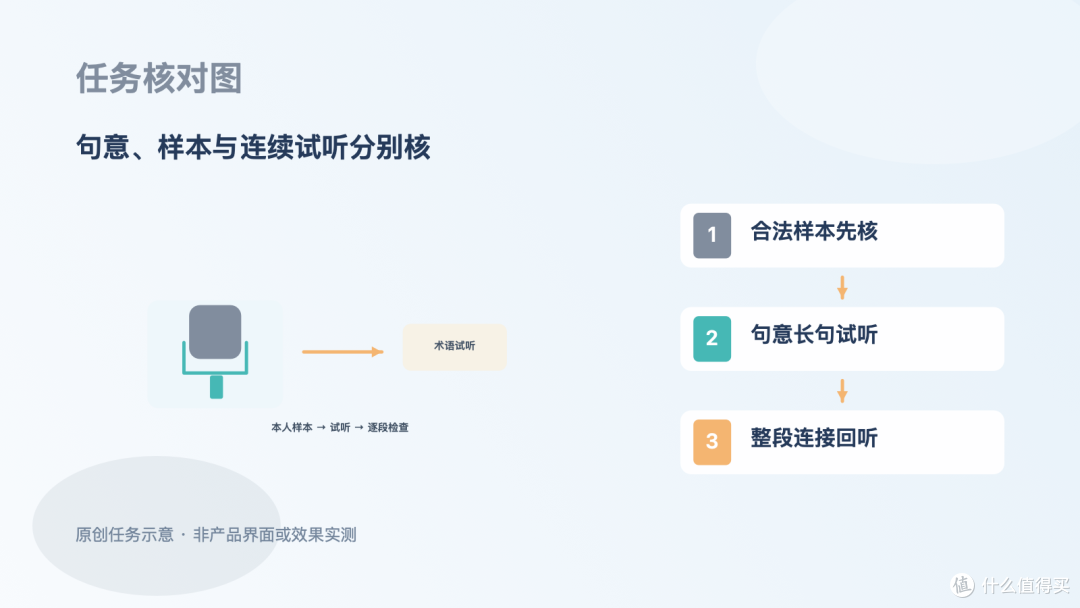
不填未经测量的自然度评分或克隆精度。背景音乐的来源与用途也要核,不能压住故事重点。封面为原创声音输入与试听示意,不是真实人物照片、软件界面或效果测试。
扩展到整篇之前
代表段可靠后,再按同一标准处理剩余故事,每段新文稿仍然要听。声音更新时检查字幕与工程引用,旧音轨不会因文件名相近自动成为新版本。
最终导出完整播放,从开场到最后一句核人物、词语与声音连接。保存正式文稿、声音来源和工程副本,后续返工能定位具体段落,才算这一篇故事配音真正完成。
作者提示含AI生成内容。





