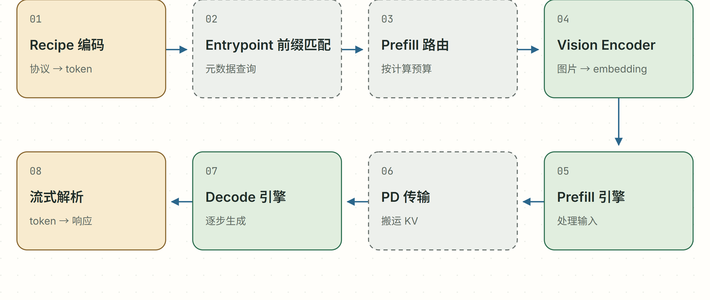
10月20日,DeepSeek把自家本该是商业机密的账本翻开了。
支撑其线上大模型服务的推理框架DeepInfer以Apache 2.0开源,随附的技术报告给数给得罕见地直白:单集群每天服务155万亿token,约合每秒17.9亿个;单卡每小时挣38美元。知乎相关问题下堆了109条评论,大家噼里啪啦算的就是这笔账:38美元/卡/小时=一天912美元,显卡岂不是一天回本?知乎专栏知乎
先别激动,小字条款还在:这是"低谷电价时段"的下限值。知乎专栏
给了什么,没给什么。README里三条"不含"——KV缓存、Prefill/Decode分离、跨数据并行副本的负载均衡——恰好划开了"离线跑分"与"线上接流量"的边界。藏得更深的是官方Q&A:FlashMLA缺一处手调SASS优化,decode kernel慢5%~10%;在线负载均衡只到离线完美均衡基准的八成;重启以分钟计。放出来的是一台调好的引擎,整车还得自己攒。真正有含金量的在批不变推理、SWA有界重放(只保留140个token)和DSpark投机解码这些设计里——省的不是电费,是重复计算。知乎专栏知乎专栏
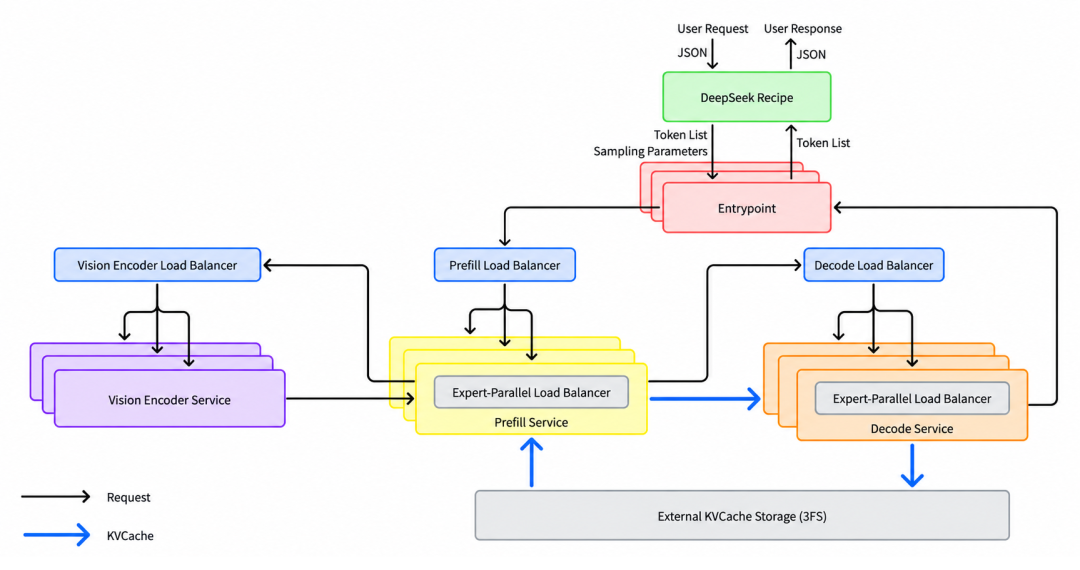
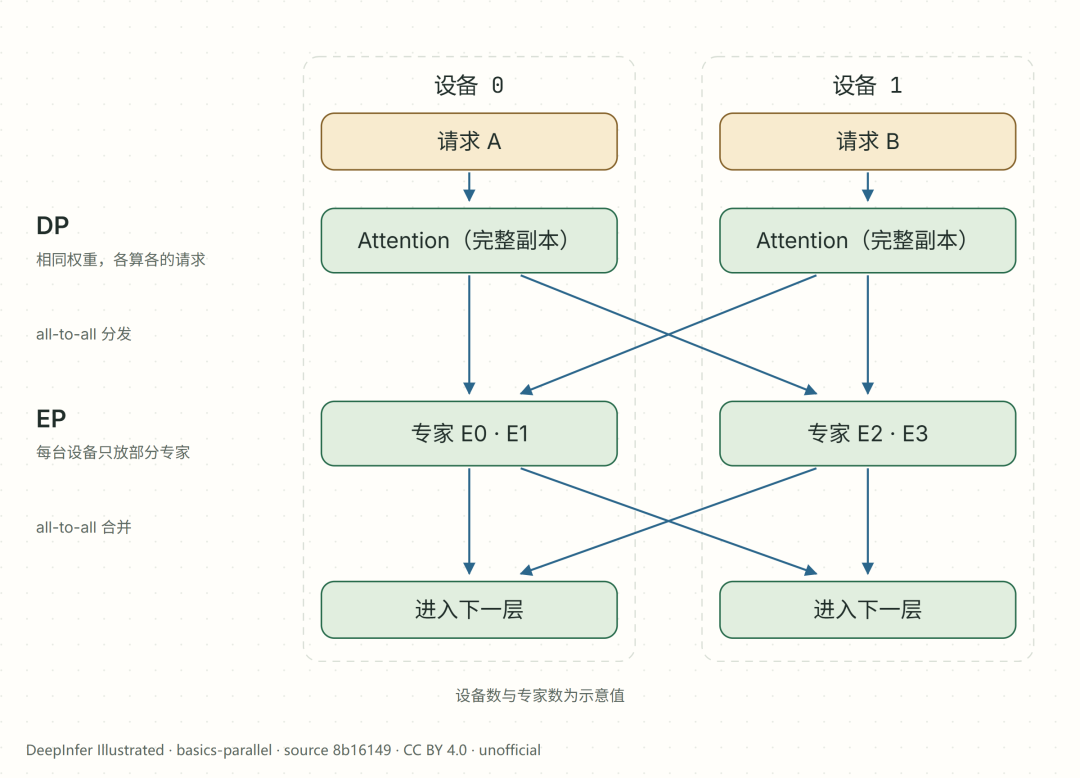
硬件名单为什么只有两行。SM100加昇腾950,别的没有。知乎用户刘景初拆出三层原因,值得逐条看:指令集——SM100有tcgen05指令和专属张量内存TMEM,消费级SM120没有,DeepGEMM和Mega MoE的kernel就是照tcgen05写的,搬到5090等于重写;显存——V4.1的路由专家按MXFP4约260GB,外加196B参数的Engram表,5090那32GB根本装不下;互联——decode要EP64~128并行,不在同一个NVLink域就走不了对称内存直读,工作站卡只有PCIe,EP一拉大通信先爆。一句话:不是不想带你玩,是并行数学不允许。知乎
名单同一行,线下不同命。昇腾950与Blackwell并排写在支持列表里,Reddit被顶到最高的评论写着"Nvidia in shambles"。但批不变推理和确定性采样明确标注仅限英伟达,官方基准清一色SM100,开源一周也找不到第三方在950上的复现数据。这一行目前叫"支持",还不叫"验证"。知乎专栏
社区侧更好玩。六天206个PR、97位作者,官方只合了2个。"套皮vLLM"的质疑很快出现在问题评论区;可同一周,#92用9000多行把V4.1-Flash塞进了H20,#210把专家权重塞进30GiB主机内存让单张5090跑起了Sage-A1.5,#196的复现报告也老实交代:4×B200只到官方曲线的59%~69%。上游冷,外围热——vLLM已有6个PR引用它的实现,SGLang贴出了接近甚至略超的成绩,deepseek-recipe的集成PR都合了。知乎专栏
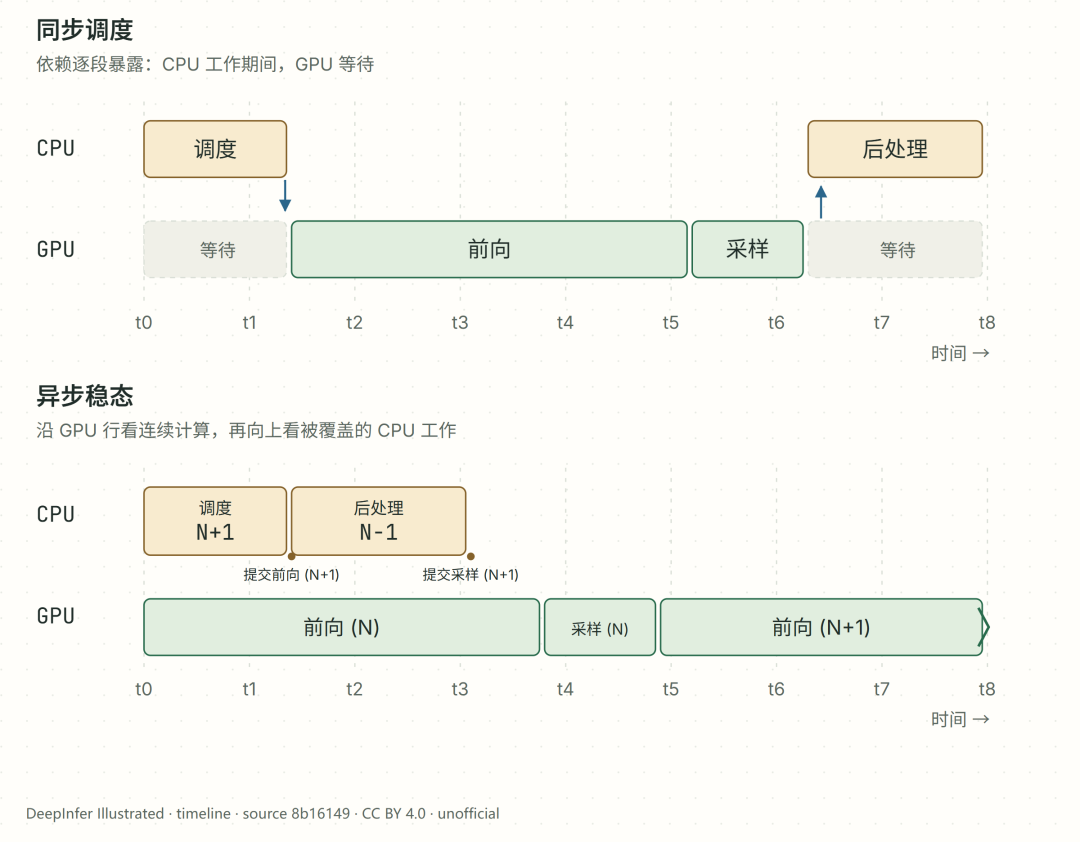
最后补一个反直觉的。"推理优化到头了吗"的问题昨天还在更新:斯坦福Hazy Research在同一张H100上跑Llama-1B,vLLM和SGLang的显存带宽利用率最高约50%,把整个前向融成一个megakernel做到78%,比vLLM快约2.5倍。哪怕这还只是单请求小模型的实验——GPU并行计算这个场子,缺的从来不是更快的卡,是让卡别等。DeepInfer值不值得读,值的不只是它一周2万多的star,而是它第一次把"多少算力在等、多少在空转"摊成了公开账本。知乎