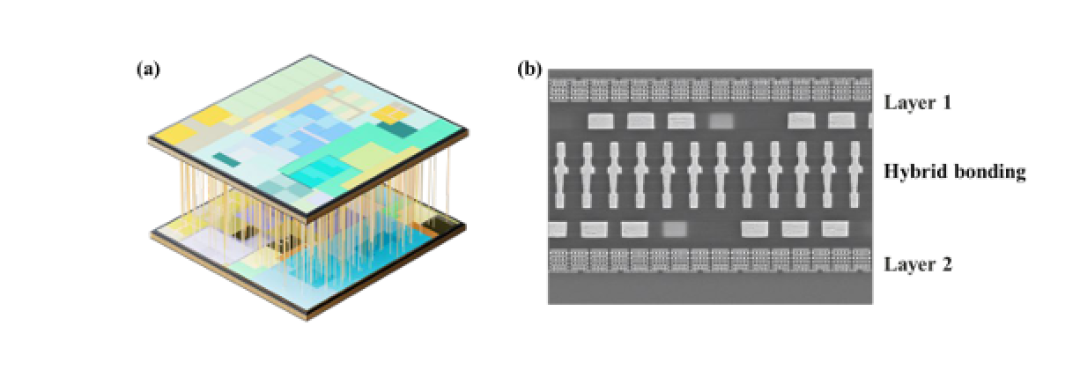
10月2日,极客湾把一颗麒麟9050 Pro切开了。电子显微镜下,芯片不是一层:两颗裸片铜对铜键合,主要模块横跨上下,数据沿着垂直方向走。制程仍是上一代麒麟9030 Pro那一档,性能却抬了上去。新浪微博
答案不在光刻机里,在“折叠”两个字里。
今年5月,海思负责人何庭波在论文里提出“韬(τ)定律”。她不再问晶体管还能做多小,而是问整个系统的时间常数τ还能压多低。知乎
为什么换标尺?7nm之后,晶体管本征延迟的收益越来越薄,真正拖慢信号的是互连。线越细,电阻越大;间距越小,寄生电容越难降,RC延迟成了关键路径的主角。
再往后,EUV折旧和设计成本一起抬头。对拿不到最先进光刻的华为,这条路的尽头来得更早。
“逻辑折叠”的做法,是把关键路径上的门电路分到两层有源层里,再用混合键合把上下连起来。知乎
这代产品的键合间距是1.5微米。论文给出的门槛是低于2微米,键合间距与顶层金属间距的“齿轮比”要低于3,越接近1,跨层连接就越像多加一层金属。微博知乎
不是整颗SoC都三维化,只折最影响时序的那部分。两颗裸片也有分工:一颗负责核心计算逻辑,另一颗专用于SRAM和缓存。新浪微博
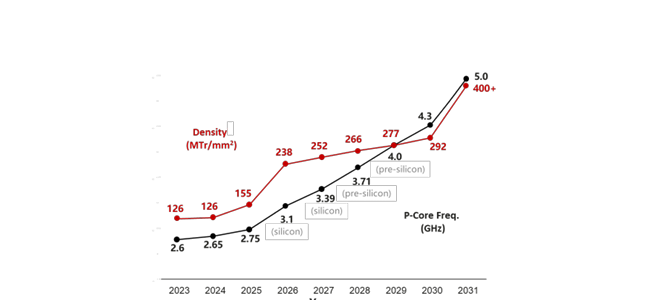
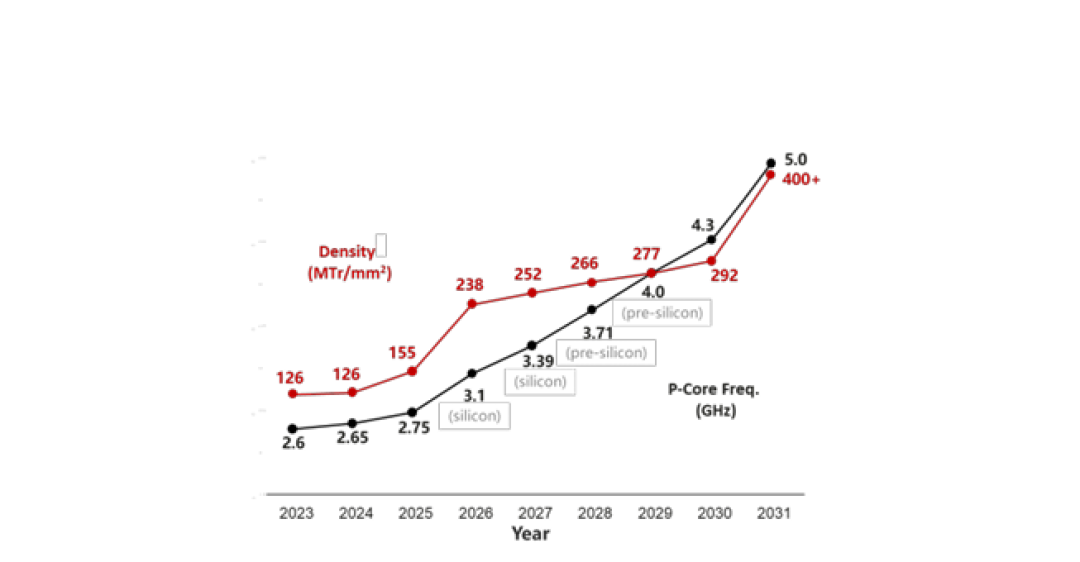
效果写进了数据:麒麟2026的晶体管密度在一代内从每平方毫米1.55亿颗跳到2.38亿颗,性能核能效提升41%,最高频率回到3.1GHz。知乎
跨层NoC的数据路径面积减少55%,SRAM运行频率提高超过40%。线短了,信号少绕路,频率和能效一起回来。
但“省电”这个说法要拆开看。τ是时间定律,不是能量定律。折叠省下的是信号传播的时间,不是电流做的功;把省下的时间全拿去提频,芯片反而可能更耗电。知乎
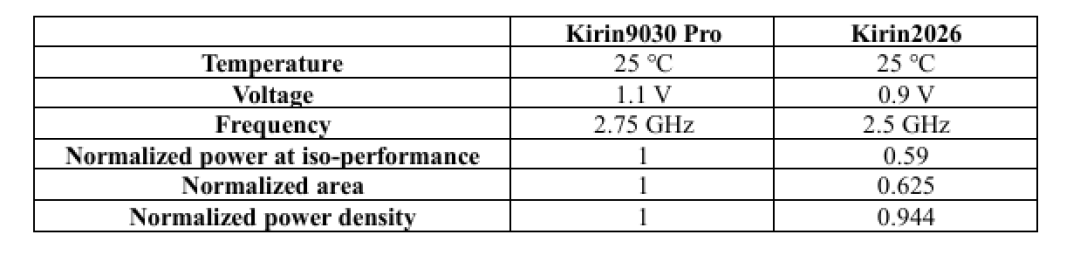
论文里的DSP就是例子:第一代折叠总功耗降了25%,面积缩了40%,功率密度却反升24%,第二代重新设计才压到平面版以下。CPU的账更含蓄:等效性能下,电压从1.1V降到0.9V,功耗降41%。新浪微博知乎
成本没有消失,只是换了科目:从面积挪到散热,从光刻挪到封装。微博
两颗裸片键合,坏一颗就废一对。键合前没法把两颗都筛一遍,上下只要有一处缺陷,这一对就一起报废,瓶颈从来不在设计,在良率和成本。新浪微博
散热同样要还账。高功耗电路不参与折叠,设计时还要避免高功耗模块在垂直方向相邻,靠热感知的分区和布局把热点拆开。知乎
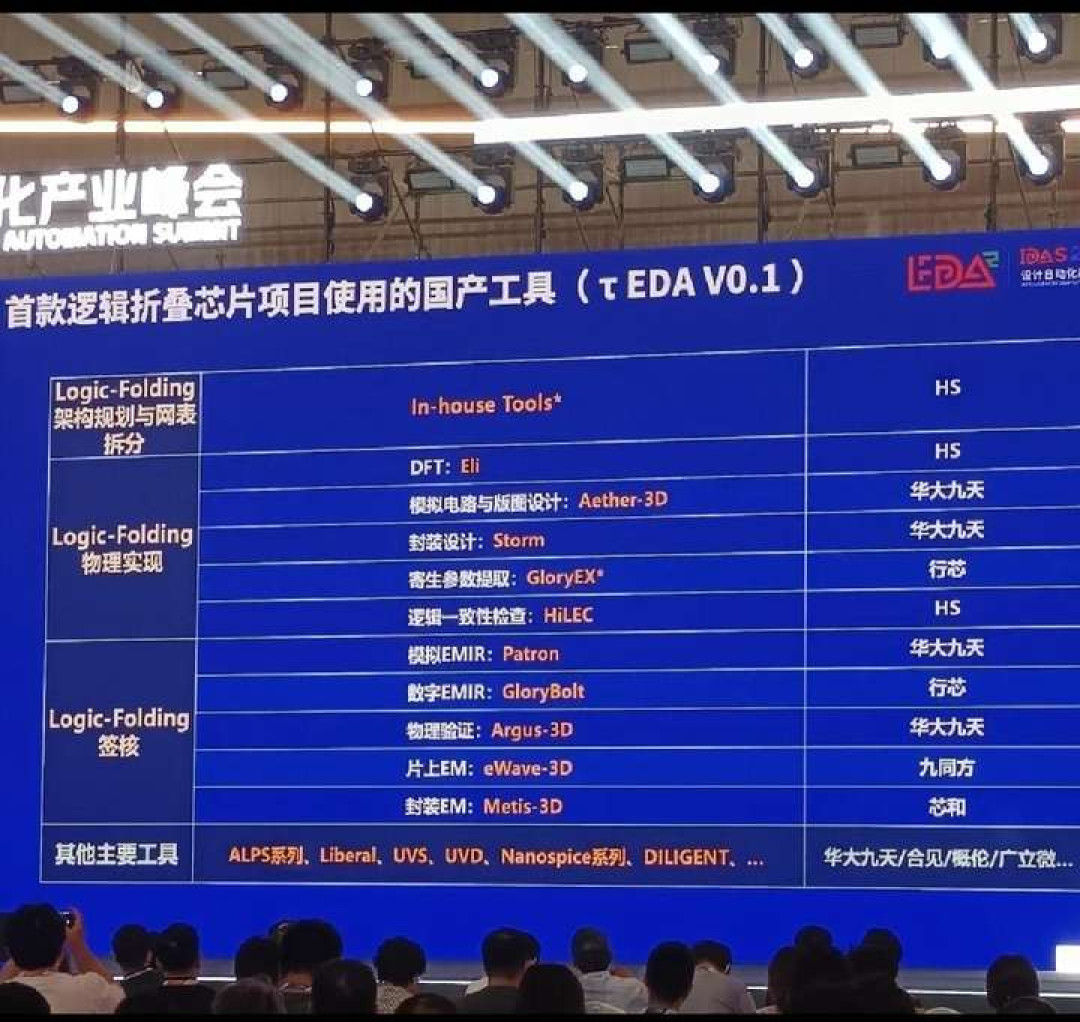
真正难的是工具。华为半导体EDA首席科学家黄宇在湾芯展上说,韬定律最大的挑战在EDA——工具跟不上,折叠就只能手工折。新浪微博
所以它不是魔法。先进制程、光刻、材料、EDA、良率,仍然是硬约束;它做的是在7nm级工艺上,把架构、封装和系统协同的效率榨出来。第一次成功只能叫工程,第二次还成立,才配叫定律。新浪微博
10月13日,徐松余说下一代麒麟2027已经就绪,测试结果符合预期,逻辑折叠未来十年可持续。微博小红书
接下来要看的不是热搜,是两个数:键合间距能不能从1.5微米走到1微米,第二代折叠还能不能成立。新浪微博
把芯片折起来,省下的是信号在硅片上赶路的时间。这笔时间能不能一年一年继续省下去,才是“定律”两个字真正的分量。