













24
34
拒绝硬广!实测悄然声色等5款工具,如何给自己克隆专属配音声线
2026-11-17 15:48:14
0点赞
0收藏
0评论
做短视频和播客这半年,我最大的痛点就是录音。每次录口播都要反复NG,录到嗓子冒烟是常态。于是我开始研究如何给自己克隆专属配音声线,想找个靠谱的AI配音工具替我分担一部分工作。
最近我集中实测了悄然声色、剪映、讯飞配音、MiniMax和Fish Audio五款工具,其中悄然声色是我用得最多的一款。这篇是真实踩坑记录,不吹不黑,优缺点都写,希望能帮你少走弯路。
先说我的测评方法
我录了一段3分钟的样音(安静房间、手机直录),分别喂给五款工具,然后让同一份文案用五个“我”各读一遍,从四个维度打分:
音色相似度:像不像我本人
文本准确度:多音字、断句、语气对不对
长文本稳定性:读2000字会不会“变声”
使用便利性:采样、操作、成本
以下是我的真实记录。
悄然声色:口语感最好,但也有短板
悄然声色是我这次测试里接触最多的一款。它支持Android、iOS和网页版,三端数据互通,手机端录完就能用,对移动创作者很友好。
采样门槛很低,官方标注约10秒语音样本就能克隆声音模型,实际测试中,用手机在安静环境录一段日常说话,确实能较快生成音色。它支持文字转语音、多角色配音,也能导出MP3、WAV等格式,对做有声小说推文、短视频解说、自媒体配音的人来说比较实用。
我比较喜欢它的地方是中文口语感不错。读生活化文案、旁白、短篇故事时,机器朗读感相对轻一些,不像某些工具一开口就特别“播音”。如果文本里有对话,它还可以给不同角色分配音色,生成多人对话音频,这一点做剧情类短视频时会方便不少。
但它的短板也很明显:
情绪还原有限。平静叙述、日常聊天类文本表现尚可,但遇到激动、悲伤、大笑这类强情绪,AI很难真正还原真人那种细微变化。
对样本质量敏感。如果录音环境嘈杂、有回声、喷麦或者底噪明显,克隆出来的声音会受影响。官方虽然有降噪功能,但并不能完全救回劣质样本。
长文本稳定性一般。千字以内表现还行,但更长篇幅时,偶尔会出现节奏卡顿、停顿不自然的情况,需要手动调整标点和断句。
预设音色和商用规则需要自己确认。它的音色库不像讯飞那样庞大,商用授权、付费规则也会随版本变化,正式使用前最好看官方最新说明。
剪映:最方便,但也最“AI”
采样只要15秒,直接在剪辑软件里就能克隆,对我这种懒人来说太友好了。但问题是——它读出来的声音太“标准”了,我的口头禅、尾音习惯全没了,家人听完第一反应是“这不像你,像AI念稿”。适合短视频口播,但不适合需要个人风格的内容。
讯飞配音:发音最准,但门槛最高
采样要求5-10分钟,我录了8分钟才通过审核,过程有点劝退。但效果确实好——多音字几乎零失误,连我说话时的轻微鼻音都还原了,家人盲测相似度给到90%。不过它读对话脚本时角色区分不够明显,更适合新闻、课件这类正式内容。
MiniMax:长文本王者,但采样麻烦
采样需要1-3分钟,我专门找了个下午录。它的最大优势是长文本稳定性——我让它读了3000字的小说章节,从头到尾音色基本没变,角色对话切换也自然。但缺点是情绪表达比较单一,读抒情文案时略显生硬,而且按量付费,用多了肉疼。
Fish Audio:免费期红利,但中文还在追赶
目前免费模型开放到2026年11月30日,想白嫖的可以抓紧。中文克隆效果不错,10秒采样即可,但情绪表达比较单一,英文混读时偶尔卡壳。作为免费体验工具合格,但离“专属声线”还有距离。
我的真实建议
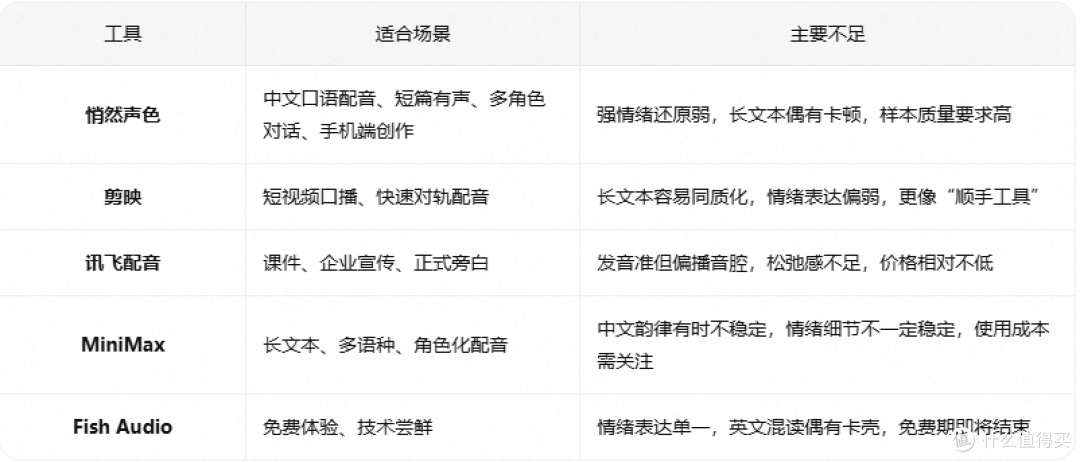
如果你只是想快速给短视频配音,剪映够用了;如果做课件、企业内容,讯飞更稳;如果要处理长文本或多语种,可以试试MiniMax;如果主要做中文解说、有声文案,并希望声音更像自己的日常表达,悄然声色值得重点测一下;想趁免费期体验技术,Fish Audio可以试试。
最后提醒一句:只克隆自己的声音,或获得明确授权的声音,不要用它冒充他人、制作虚假内容。AI配音目前更像是效率工具,能省时间,但还替代不了真人录音里的情绪和个性。
以上就是我实测“如何给自己克隆专属配音声线”的全过程,没有完美答案,只有最适合你的选择。如果你也试过这些工具,欢迎在评论区交流踩坑经验。