

今年骁龙峰会,高通把AI故事讲得相当完整:智能体写邮件、管日历、做行程规划。但这个故事的多少,会真的装进你年末新手机的口袋里?知乎知乎
不用猜,全网达人和媒体已经留下了实测。我们把结果拼成一篇——先看懂这4个数字,再谈骁龙和端侧AI。
数字一:3字/秒。
想把35B大模型真塞进手机?有B站UP主把MiniCPM和Qwen的35B MoE模型跑进了手机,能用但不快:约每秒3个字、机身约43℃。写一篇两百字,得站着等一分多钟。别拿云端聊天的预期套它——端侧跑大模型,今天叫"能跑",不叫"好用"。哔哩哔哩
数字二:138 tokens/秒。
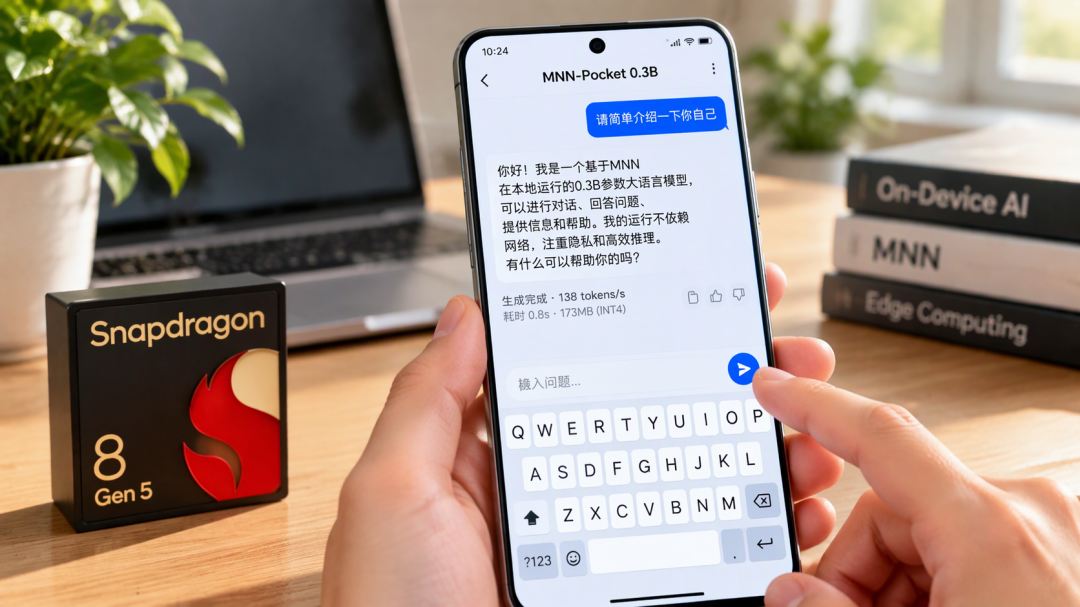
另一个极端。淘宝今年11月开源了0.3B小模型MNN-Pocket,INT4量化后只有约173MB、支持32K上下文,在骁龙8 Gen 5上解码能到每秒138个token。翻译成人话:短问答、摘要、随手翻译,端侧的"秒回"体验真的成立。端侧AI现在的样子,不是"手机能不能跑AI",而是"模型配不配得上这件事"。哔哩哔哩
数字三:2分半一张图。
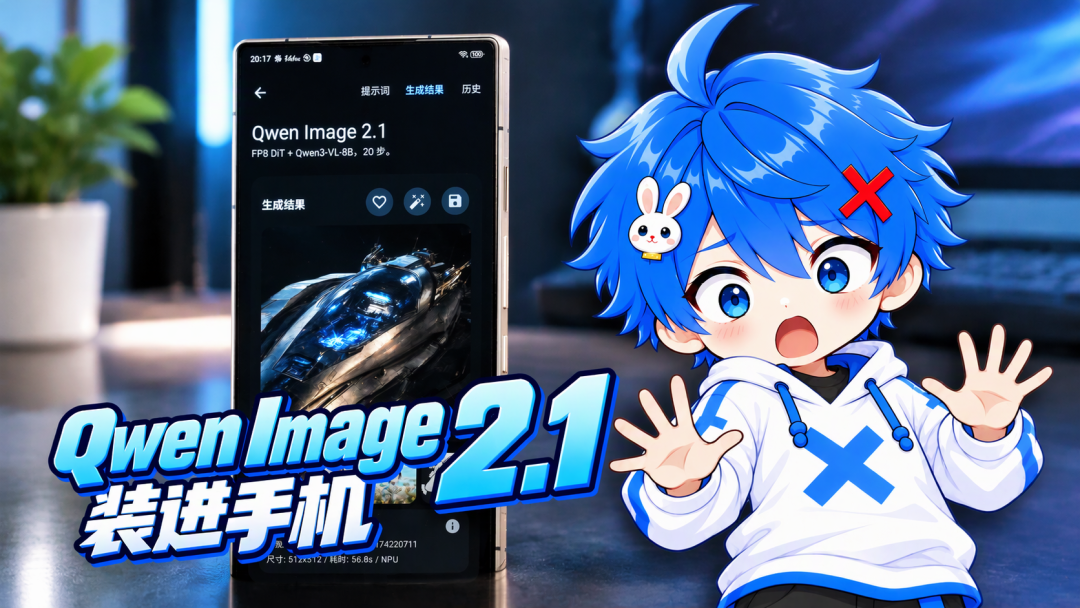
生图是目前NPU最出圈的用法。用开源项目LocalDream在手机上跑Qwen Image 2.1,2分半出一张图。这位UP主拿红魔11 Pro+和红魔12 Pro+对比了速度、整机功耗和电池温升。评论区有人实测整机约9.8W、把电费折算到"不到一分钱",也有人自述用骁龙8E跑未过滤原版模型1分钟一张——速度取决于你跑哪个模型,别拿一个数字套所有。日常随手玩,骁龙8系NPU上小模型512×512约10秒出图、大模型约60秒。哔哩哔哩哔哩哔哩
数字四:+35%。
第六代骁龙8超级至尊版(8EE6)的官方口径是:NPU性能较上代提升35%、AI每瓦性能提升33%、NPU共享内存增加50%。这里最容易踩的坑是——这些全是"跟自己上代比",不是跟天玑比的横向成绩。知乎
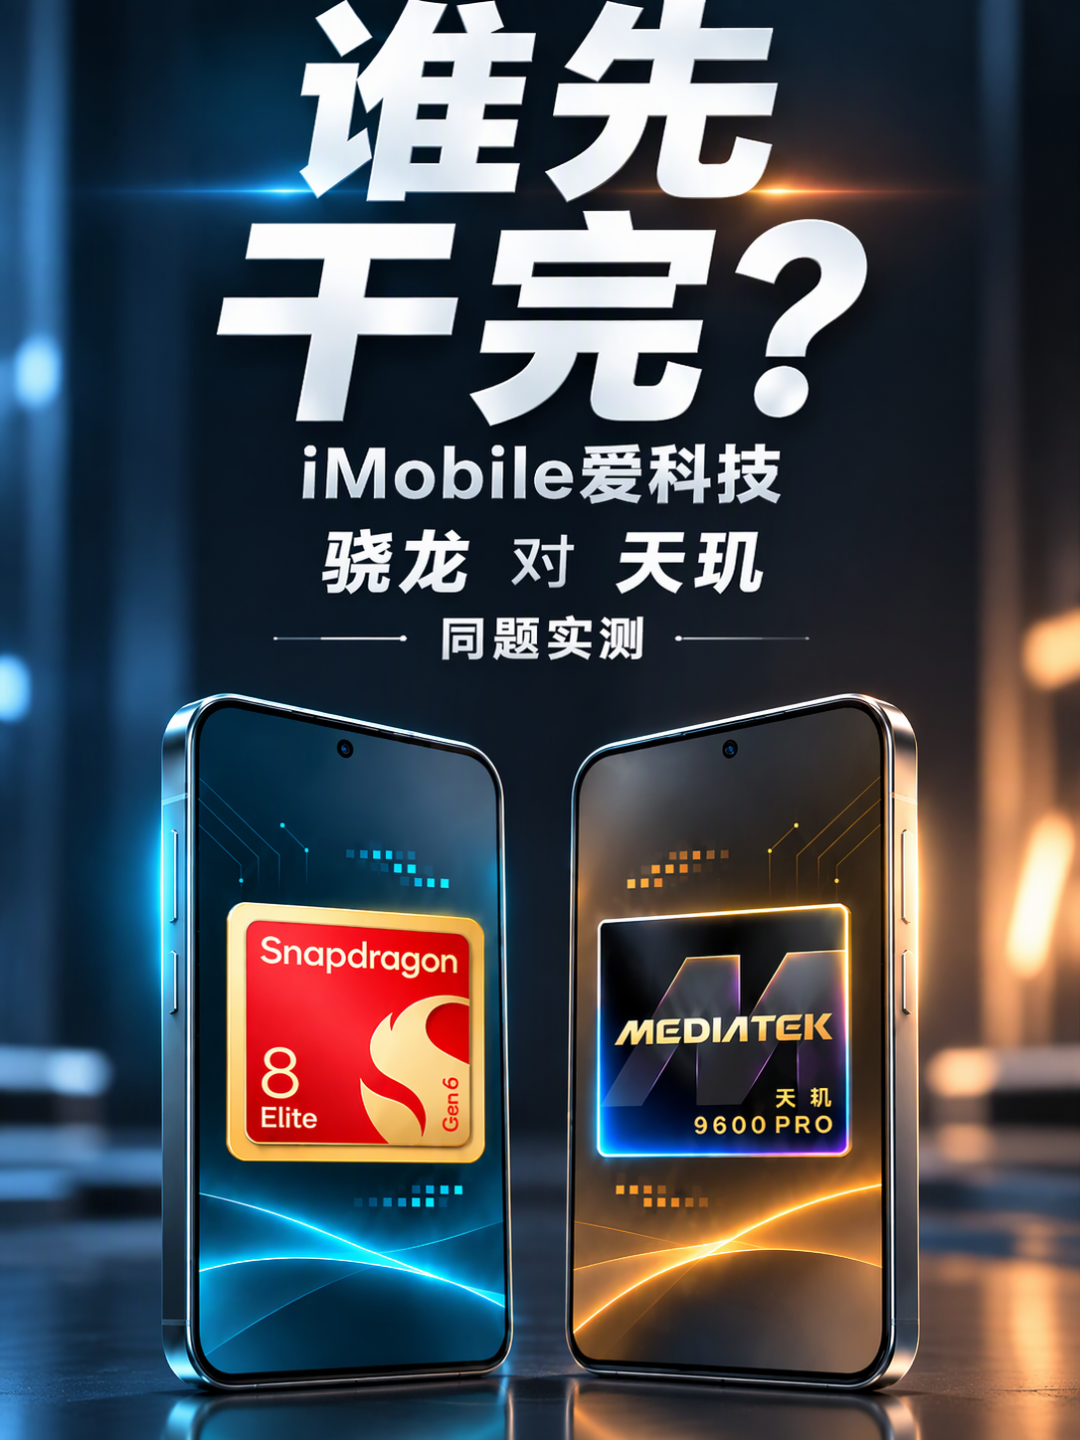
对面天玑9600 Pro宣传的"大模型预填充性能提升51%、每瓦生成词元数最高提升55%",同样是跟自己上代比、不是跟骁龙比。真正同题的对决看实测:11月iMobile爱科技把同一个大模型装进两台手机、只用CPU跑——骁龙生成回答更快,天玑在处理输入为主的连续任务里更早完成、更省电。没有统一的赢家,只有各自的取舍。知乎知乎小红书
两条话术,别照单全收。
一是"发布会≠到手"。峰会上演示写邮件、规划行程的StepEdge-Omni 30B-MoE,是高通联合伙伴部署在参考设计上的能力上限:模型权重从端侧闪存加载、NPU与GPU协同推理。但落到哪台手机、开放多少、收不收费,取决于厂商实现。二是"参数≠体验"。年末下单前,问客服一句比盯参数页有用:这台手机端侧能跑哪个大模型、智能体功能开放吗、要不要付费?知乎
顺便给折腾党一个增量信号:骁龙机型可以启用Linux终端跑命令了——11月9to5Google已在红魔12Pro上实测确认。端侧的上限还在抬高,但发布会和你兜里之间的距离,得自己拿数字去量。知乎
当前文章无评论,是时候发表评论了