

在快节奏的现代生活中,我们早已经习惯了对着手机屏幕按下录音键,然后看着一串串文字跃然纸上。无论是会议记录、微信上的语音输入,还是智能家居的语音指令,人工智能将声音转化为文字的技术早就已经悄无声息地融入了我们的日常。
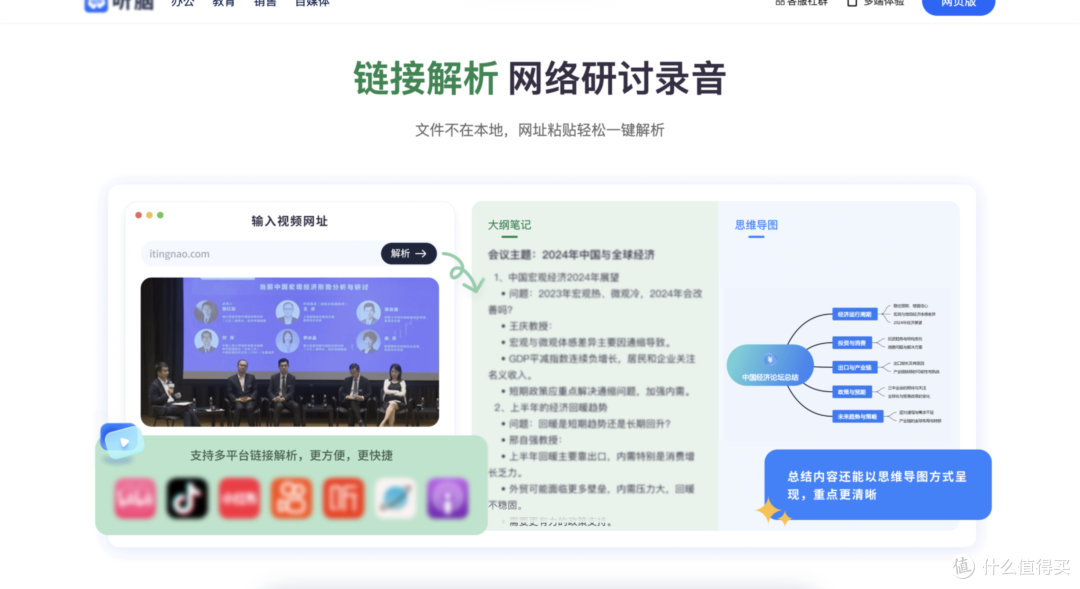
这种技术看似理所当然,但在这背后,其实隐藏着一场精密、复杂却又充满趣味的“数字翻译”之旅。今天,让我们放慢脚步,一起剥开这层神秘的面纱,用最轻松的方式,看看机器究竟是如何“听懂”人类语言的。
声音的本质,是空气的振动。当我们说话时,声带的振动在空气中激起了一圈圈看不见的涟漪,这就是声波。人类的耳朵里有精密的鼓膜来感知这些涟漪,而对于冷冰冰的计算机来说,它的“耳朵”就是麦克风。麦克风的角色就像是一个忠实的记录员,它感受到空气的振动后,会把这些物理上的起伏变化,转换成微弱的电流变化。然而,计算机是个彻底的“理科生”,它不懂电流的起伏,它的世界里只有数字0和1。
因此,系统需要进行一步操作:给声音“拍照”。你可以把它想象成给连续的动作拍定格动画——系统每隔极其短暂的时间(通常是一秒钟内测量上万次),就去记录一下当前声音的强度,并把它转化成一个数字。原本连绵不断、无影无形的声波,就这样变成了一长串密密麻麻的数字代码。至此,AI终于拿到了进入声音世界的入场券。
面对这如海啸般涌来的千万个数字,AI如果一口吞下,肯定会消化不良。因此,它需要像切土豆片一样,把连续不断的声音数据切成一小段一小段的。在技术上,这被称为分帧。每一小段声音的时间极短,大约只有二三十毫秒。
切好片之后,AI并不会去死记硬背这些枯燥的数字,而是要提取其中的“声音指纹”。为什么需要这一步呢?因为同一个词,老人说和小孩说,感冒鼻塞时说和情绪激动时说,甚至在安静的书房和嘈杂的街头说,录下来的数字表现是完全不同的。
AI必须撇开音色、音高、背景噪音这些表象,抓住发音的最核心特征。就像是在熙熙攘攘的人群中,它不仅要看出这是一个穿着红衣服的人,还要透过外表看出他的骨骼轮廓。这一步去伪存真的过程,让杂乱的声音数据变成了干净、纯粹的特征拼图。
接下来,是真正考验AI阅历的时候了。我们人类学说话是一字一句模仿的,而AI则是通过一个庞大的“声音档案馆”(声学模型)来对比声音。
想象一下,AI的脑海里存放着人类语言中所有微小的发音单元。当AI拿着刚才提取出的那片“声音指纹”走进去时,它会开始疯狂地比对:这个声音,是不是有点像拼音里的“b”?还是更像“p”?
通过强大的计算能力,AI会对每一段声音进行概率评估,拼凑出最可能的发音组合。在这个阶段,机器其实还不知道你到底说了什么意思,它只是像一个不懂中文的外国朋友,极其努力地用拼音把你刚才发出的声音复述出来。
如果仅仅停留在“听音拼字”的阶段,AI往往会闹出很多笑话。中文博大精深,有大量的同音字和近音字。比如“期中”和“期终”,“权利”和“权力”,或者是“我想静静”和“我想晶晶”。单纯依靠声音指纹,计算机根本无法分辨你到底要表达哪一个。
这时候,就需要AI的大脑——“语言模型”登场了。语言模型里装满了人类说话的习惯、语法规则和海量的文本知识。
当声学模型递过来一串发音为“qi zhong kao shi”的拼音时,语言模型会迅速开始思考:根据我阅读过的大量书籍和文章的经验,在“kao shi(考试)”这个词前面,搭配“期中”的概率,要远远大于搭配期终。
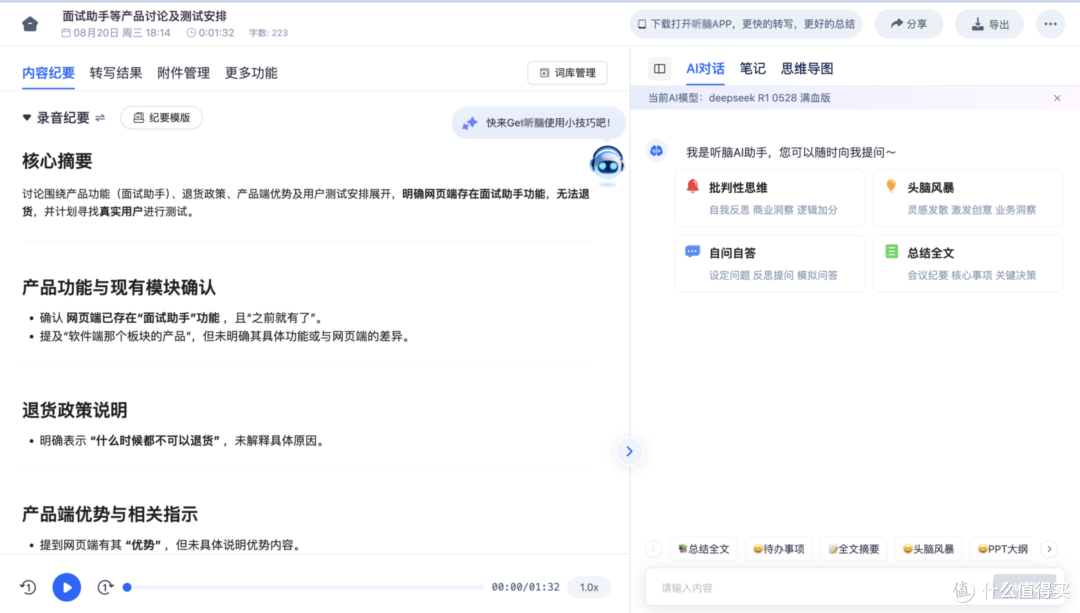
于是,AI不仅“听”到了声音,更结合了上下文的语境,做出了最符合人类常理的判断。它就像一个经验丰富的文字编辑,迅速帮你修正了同音字的歧义,最终把精准、通顺的文字呈现在屏幕上。
从无形的声波涟漪,到二进制的数字代码,再到发音比对和语境推断,AI的每一次语音转文字,都是一次跨越物理世界与数字世界的奇妙旅行。在短短零点几秒的瞬间,成千上万次的计算在后台悄然完成,最后化作屏幕上安静且准确的一行字。
随着技术的不断迭代,如今的AI不仅能听懂标准的普通话,还能分辨各地方言,甚至能从语气中察觉到你的情绪。但无论技术如何演进,它的核心魅力始终在于:用最理性的代码和算法,去努力理解人类最感性、最灵动的交流方式。下次,当你在屏幕上看到那些由声音变来的文字时,或许可以花上一秒钟,在心里为这位默默无闻、严谨高效的数字翻译官点个赞。
当前文章无评论,是时候发表评论了