

装完机第一次跑本地大模型,最让人心里发凉的不是报错,是它不报错。
B站UP主“打工的小满”拿一台 RTX 4060 Laptop 跑 Qwen2.5-7B 的 Q4_K_M 量化,权重才 4.68GB,显存 8188MiB,看着很宽裕;可上下文一开到 65536、KV 缓存用 f16,实际要 9900 多兆,它没有崩也没有报错,生成速度只是从 41.1 token/s 掉到 15.3。他给这件事下的注脚是:“显存不够的时候,它不会拒绝你,它会借你的内存,然后收你两倍的时间。”哔哩哔哩
最亏的不是不够,是刚差一点
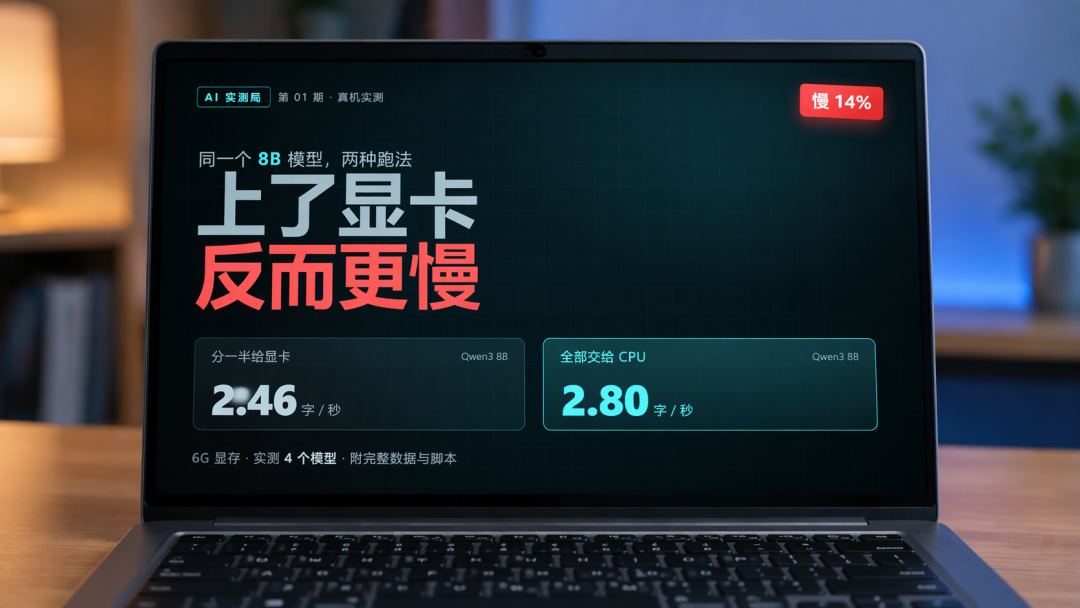
“让梦想飞吧-大肥鱼”用一台 RTX 3050 6GB 的笔记本跑 Ollama,四组数字排在一起很扎眼:4B 权重 2.5GB、86% 上卡,11.49 字/秒;8B 权重 5.2GB、只有一半上卡,2.46 字/秒;同一个 8B 强制全走 CPU、显卡 0%,2.80 字/秒;14B 权重 9.3GB 全塞内存,1.26 字/秒。插着显卡,比拔掉还慢 14%,原因他讲得很直白:显存不够时权重要在内存和显卡之间来回搬,搬运时间比直接在内存里算还长。还有个装机时没人提的数:这台 6GB 的卡开机空载已吃掉 5715MiB,真正能留给模型的只有 429MiB,你按 6144 去算需求,从第一步就错了。哔哩哔哩
钱给显卡还是给内存,取决于一件事
知乎答主“天煞”把它拆成两半:prefill 相当于输入,吃算力;decode 相当于输出,吃带宽。所以显存的作用是把东西放在近处——放得下,速度由显卡决定;放不下就换一套逻辑,decode 这一步吃的是带宽,框架把溢出部分留在主内存里,速度立刻换一档。知乎哔哩哔哩
MoE 架构把这道门槛砸了下来。天煞的原话是,不管 35B A3B 还是 125B A6B,最终激活只有 3~6B,CPU 配上四通道内存就还能碰一碰。他那台机的配法是:千问 3.6 35B A3B,显存只放注意力层、KV 缓存和上下文,占用不到 6G,12G 的专家层全扔进内存,配 E5-2683V4 十八核加 DDR4 四通道,decode 跑到每秒 30 token。知乎
对装机的直接影响是:走这条路,CPU 的内存通道数比型号重要,主板支不支持四通道比它贵不贵重要。
双卡这条捷径,通常被主板堵死
“量子菠萝_”拿两张 RX 7900 XTX 实测:单卡约 36 token/s,双卡 34,加一张反而慢了。原因是默认的分层切分让两张卡轮流干活,只有张量切分才真提速(他那组测试约 1.3 倍),而张量切分极吃 PCIe 通道——他说大多数主板第一条槽给 16 通道、第二条只给 4,只有少数能拆成 8+8。所以那句提醒值得记住:两张 16GB 显卡绝不等于 32GB 可用显存,系统预留与驱动开销会吃掉部分空间。哔哩哔哩
撑爆显存的往往是上下文
“图解AI_Infra”的提问很到位:一张 80GB 的卡装 16GB 的模型绰绰有余,为什么聊着聊着就爆显存?因为 KV Cache 一直在长,而 GQA 结构下每 4 个头共用一组 K、V,一个 token 的 KV 约 128KB,效果几乎不掉。8GB 显存除以 128KB,65536 个 token 就到顶。好在这一项能压:回到小满那组实验,KV 缓存从 f16 换成八位,同样 65536 上下文,占用降到两 G,速度回到 40.5,一点没掉。哔哩哔哩哔哩哔哩
预算到底怎么分
模型能整个塞进显存的,钱全给显卡,这一档没有捷径。
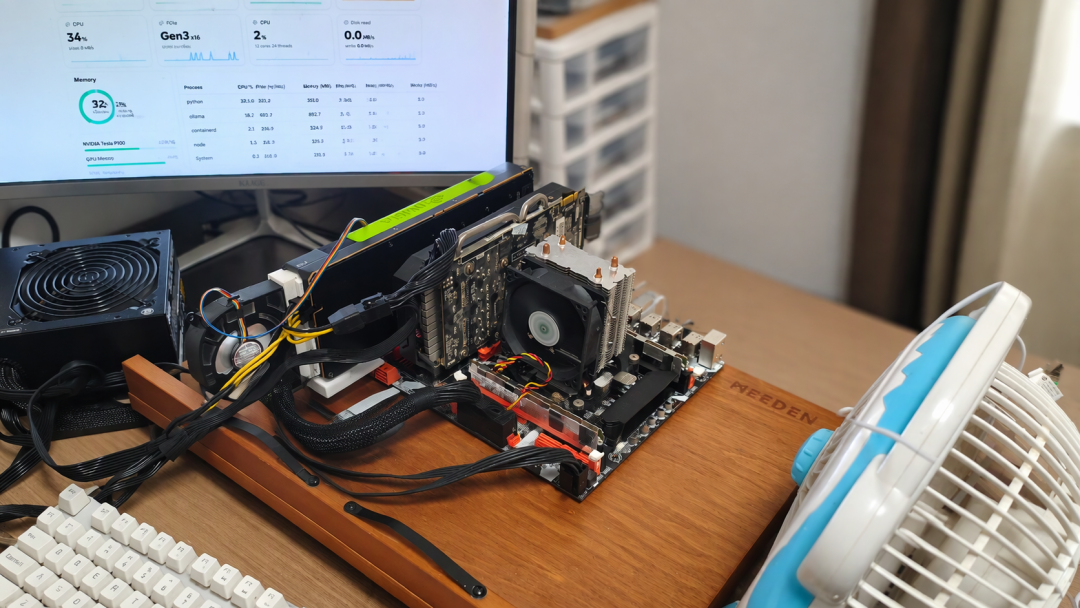
塞不下又要跑大的,大内存路线反而最便宜。“ZZ是画渣”花 1400 元出头捡了套 X99:X99D3 魔改主板加 E5-2673V3、DDR3 服务器内存、P100 计算卡,本地跑 Qwen3.8-Flash-Next 的 IQ3 量化,实测平均 30+ token/s、峰值 50。这条路的成本逻辑天煞也算过:DDR3 还是便宜一些,900 到 1000 块能买到 128G 内存。哔哩哔哩知乎
不过 ZZ是画渣自己也标了一句客观说明:P100 的 prefill 速度偏弱,这套方案更适合 Strata,对其他大模型兼容性一般。洋垃圾不是白捡的。哔哩哔哩
再往上一档是“本鱼先炫口白饭”的一万五:Dell T7910 双路工作站,双 Xeon E5-2620 v4、16 个内存槽,先插 32G ECC、打算补到 192G,GTX 1650 亮机加 960G 固态,正从 ModelScope 往数据盘里下 300GB 权重跑 Q2 量化。他说得很实在:跑起来不会快,上下文也不长。但至少,不会在自己不知道的时候被换掉。哔哩哔哩
下单前只做一件事
先定死要跑的模型、量化档和上下文长度,算出显存需求,再决定钱给显卡还是给内存。顺序反过来——先看上哪张卡、再想跑什么模型——大概率落在最亏的那个中间档。
当前文章无评论,是时候发表评论了