数码DIY圈有个老毛病:东西做得再酷,也是个哑巴。
桌面机器人、离线语音助手、自制智能音箱——想让它们"说话",以前只有两条路:要么按次给云厂商交钱,声音数据还得传出去;要么上带显卡的机器,成本和体积直接起飞。断网那一刻,全场安静。
语音模型塞进了口袋
10月22日,法国AI实验室Kyutai更新了Pocket TTS:把原本约1亿参数的语音模型,压出了18.2M、6.9M、1.9M三个规格,全部支持声音克隆和CPU推理。其中最小的1.9M版本,参数量砍掉约98%,官方测试里只用一个CPU线程,就能以实时速度的25倍合成语音;代码MIT许可,权重CC BY 4.0,下载前接受使用条款即可。这基本等于拍着你肩膀说:随便折腾。知乎知乎
这对DIY党意味着什么
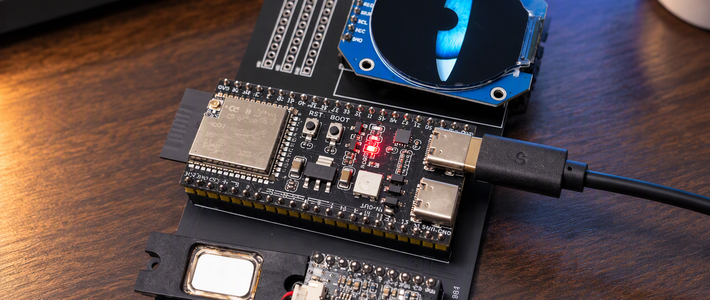
“单核CPU、25倍实时”,翻译成人话:不用显卡,抽屉里吃灰的树莓派、退役多年的旧笔记本,都有戏跑。
B站已经有人用2GB版树莓派5做完全离线的AI语音助手,也有人让树莓派Zero W跑起了实时语音对话。这股"本地语音"的火一直有人烧,缺的就是一个够小、够快、还免费的合成引擎——现在它来了。哔哩哔哩哔哩哔哩
能玩的场景很直接:
万圣节就在眼前,南瓜灯里藏块板子加个喇叭,就能用"人声"迎宾,英语场景正好对上新模型
桌面宠物、机械臂、自制音箱:克隆一段自己的声音,设备立刻有"人格"
离线场景:小屋、宿舍、地下室,没有网,语音播报照常干活
三盆冷水,先泼为敬
第一,新的小模型主要面向英语。想让它说中文,要么等项目里更大架构的语言模型,要么换CosyVoice、GPT-SoVITS这类中文项目——别急着喊"中文有救了"。知乎
第二,25倍实时是单线程吞吐量,不是延迟。从你说完话到设备开口,中间还有语音识别、大模型对话两段路,对话场景的总延迟得自己实测。知乎
第三,音质是换来的。官方定位很清楚:18.2M版本音质已接近原版,1.9M版本则是"够用、本地、免费"。做玩具绰绰有余,做正经产品,先拿你自己的文本跑一遍,比看任何评测都靠得住。知乎知乎
怎么上手
官方仓库代码和权重全部开源。不想碰命令行的话,VoiceStudio、audio.cpp这类开源工具已经把PocketTTS收进了引擎列表。知乎知乎
长期以来,"声音"是DIY硬件身上最贵的器官:要么按秒租云,要么供一台显卡。现在有人把它压到190万参数,还免费。
这张门票不要钱,上不上车,看你手里的板子答不答应。