

11月18日,搭载RTX Spark平台的紧凑型桌面电脑正式上市,华硕、戴尔、微星首批推出产品,宏碁、技嘉、惠普等厂商随后跟进;这类设备配备20核Grace CPU和Blackwell架构RTX GPU,最高128GB统一内存,官方支持本地运行1200亿参数大模型,并主打减少云端API依赖和Token费用。微星EdgeMesa N AI+基础版64GB内存加1TB固态的日常价为33999元,128GB加4TB的顶配到了56999元。微博知乎
比起参数表,用户真正想知道的是上机实测的表现。综合首批实测,结论可以浓缩成一句:同样的N1X芯片,要放进敢给足140W功耗预算的桌面机身里,才算发挥出了完全体。本地大模型、AI创作、游戏这三件事的答案都是"能",但各自带着前提:模型速度取决于推理引擎,游戏帧数取决于软件适配。
桌面机身放开功耗,才是性能的前提
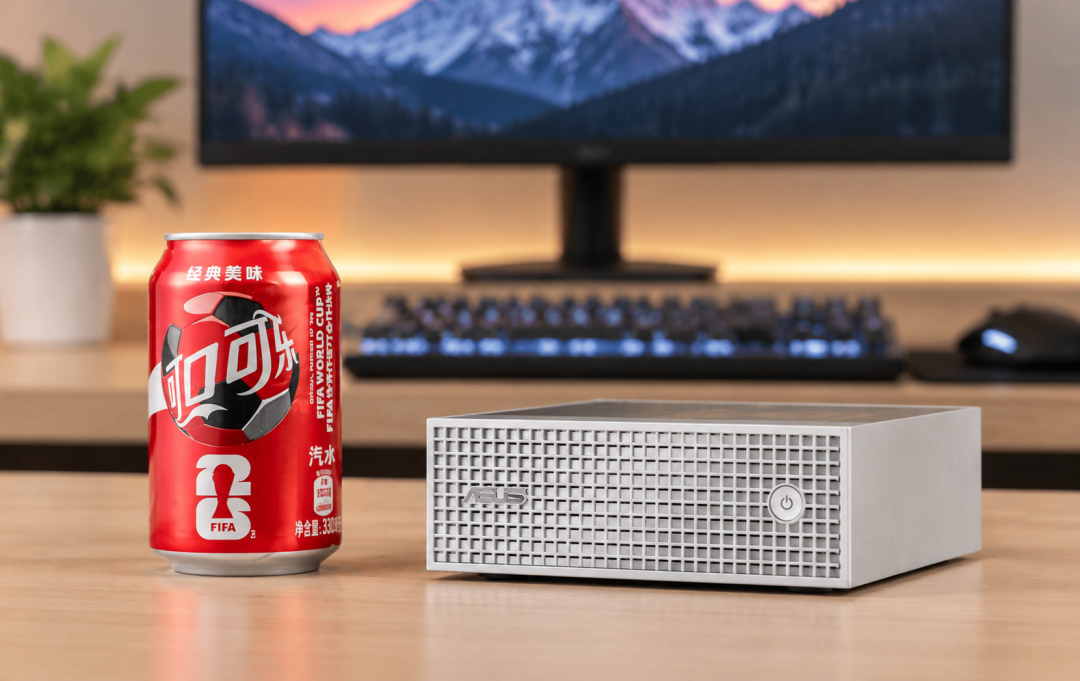
首批上市的三款迷你主机都沿NVIDIA公版设计,性能体验层面几乎相同,差别集中在存储、散热和品牌,华硕和微星两台机器的计算平台本就是同一级的。哔哩哔哩知乎
以华硕ProArt GR1X为例,这颗芯片在ProArt创16笔记本里最高只能设到85W,换进15厘米见方的桌面机身,整机功耗上限提到140W。有实测者做了CPU与GPU同时满载的烤机:两者功耗分配稳定在60W加80W,合计正好达到标称值,单烤GPU还能冲到102W。连续满载20分钟,GPU温度70℃出头,距83℃温度墙还有余量;3DMark光追项目Port Royal比笔记本提升8%,已接近桌面RTX 5060 Ti的水平。需要先对齐的是口径:官方标称的1 PetaFLOP指的是FP4精度下的理论值,和数据中心计算卡不能直接横向排名。知乎知乎
本地大模型:50 Token/s是底线,翻倍靠软件
用最常见的llama.cpp引擎,这台机器跑176B这类Flash级别的模型能到50–60 Token/s,官方"本地运行1200亿参数"的说法对应的就是这种能用、不算炫的速度。知乎
真正把速度拉高一档的是推理软件:实测者把开源的TensorFold引擎编译到Windows上,配合更高量化精度的权重跑256K上下文长任务,平均解码吞吐提升116%,首字延迟降低58%,单Token能耗还下降了44%。同一条测试链路里,一次4万Token以上的长推理代码生成,前者约11分钟一次跑通,后者耗时接近40分钟还先产出了需要修复的代码错误。不过这类优化主要惠及单人使用:TensorFold官方没有Windows版,它在多用户并发场景的表现不如vLLM甚至不如llama.cpp——而并发服务恰恰是DGX Spark的主场,那台机器跑Linux、官方支持微调700亿参数模型,还能用200Gbps网口把4台连起来。知乎知乎
创作和游戏:能干旗舰干不了的活,也要等得起时间
视频超分测试里,一段15秒的高压缩720p素材拉升到1440p,峰值内存占用超过70GB——32GB显存的RTX 5090装不下,传统工作站要72GB以上的专业卡才够格;128GB统一内存让它可行,代价是从冷启动到渲染完成足足4.3小时。图像生成同理,40GB级别的BF16生图模型对它不构成显存障碍,属于"别人干不了,它能干"的卖点,而不是"更快"。知乎
游戏则更依赖适配深度。《漫威争锋》1440p高画质加DLSS平衡档,同一款笔记本用x64转译版平均只有56帧,换成ARM64EC原生版本就到了80帧。换进桌面机身,在同样的原生版本上平均帧率进一步升到88帧,最低1%帧从49涨到61,跨过流畅线。换句话说,帧数一大截差距来自软件生态而非芯片本身,办公创作软件如果强依赖特定x86程序、驱动或老插件,购买前必须先做兼容性确认。知乎知乎
全天候开机的成本,和它值不值
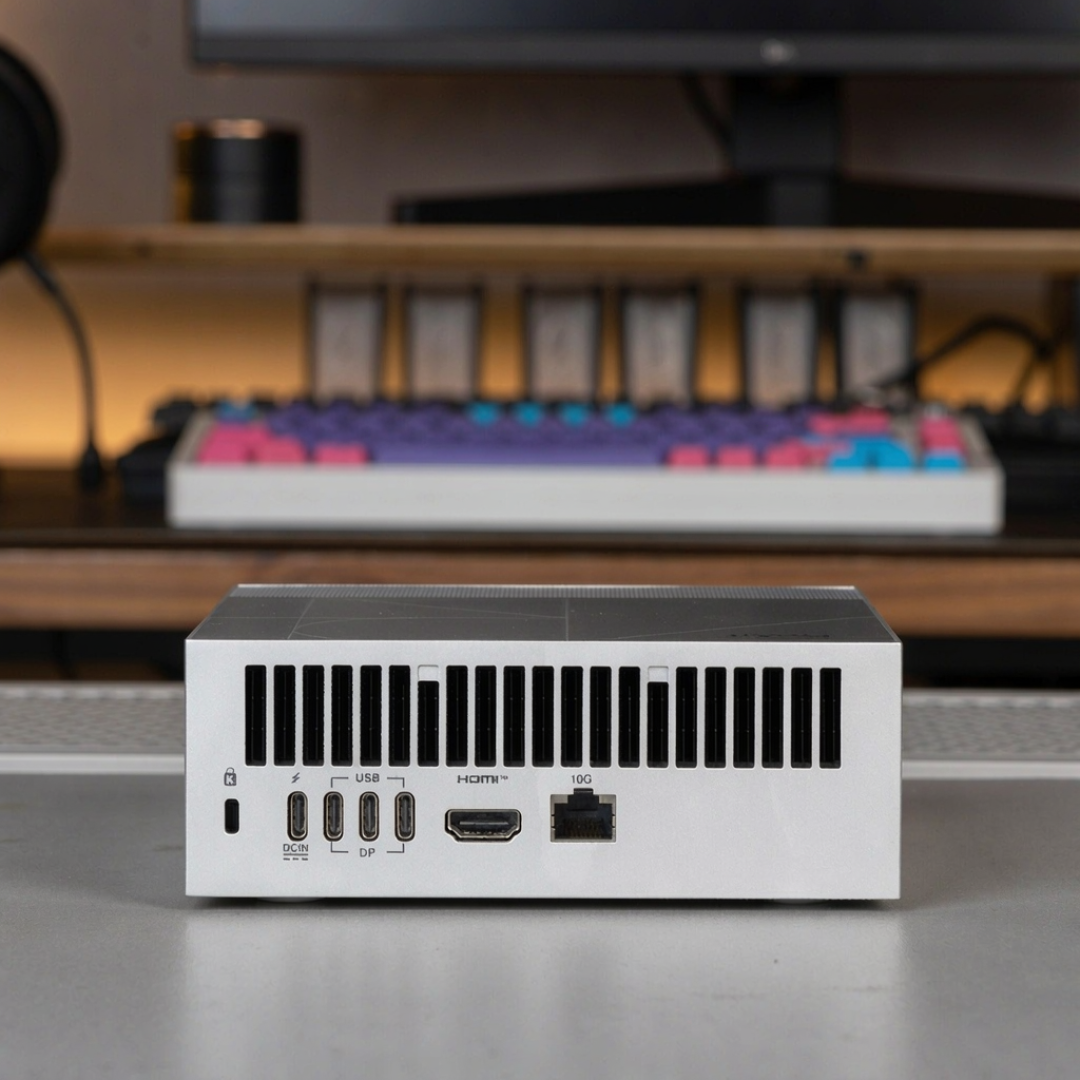
这类机器被设计成7×24小时待命的智能体主机,实测样机在模型已加载、没有推理任务时整机功耗仅15W,全年无休一天约0.36度电,满载推理也只在80W上下,风扇几乎听不见。电费这头很轻,值不值主要取决于云端的账:如果每天都在跑智能体工作流、批量画图剪片,几万元更像一次性买断;如果只是偶尔问答,云API仍然便宜得多。知乎
落到具体型号,华硕ProArt GR1X两档定价34999元和54999元,比微星基础版贵1000元但多了2TB起步的固态。选择逻辑其实一句话就能说完:想要一台白天干活、晚上跑智能体、还能顺带打3A的Windows主机,选RTX Spark迷你工作站;做CUDA开发、微调和多人共享服务,该选DGX Spark;需要带着走,那就是十月份上市的RTX Spark笔记本。知乎


当前文章无评论,是时候发表评论了