

11月18日,NVIDIA RTX Spark紧凑型桌面主机(迷你工作站)首批机型开售,华硕、微星、机械革命三家同时上架。这颗芯片并不新——今年早些时候,同规格的RTX Spark N1X超级芯片已经装进了笔记本。于是最实际的问题变成了:同一颗芯片,放进巴掌大的桌面盒子,到底比笔记本强多少?知乎知乎知乎
首批第三方评测给出的答案比较一致:常规轻负载下两者几乎打平,差距集中在持续重载——笔记本功耗上限约85W,桌面整机可达140W。由此带来的领先集中在持续重载项目:理论图形跑分约+8%~15%、CPU重度多线程约+21%、本地大模型4流并发约+24%,实际游戏帧率随负载结构提升10%上下。而在智能体任务可以7×24小时挂机的场景里,桌面形态的优势就不是几个百分点,而是笔记本根本干不了的活。知乎知乎知乎
差距从哪来:55W功耗预算,几乎全给了GPU
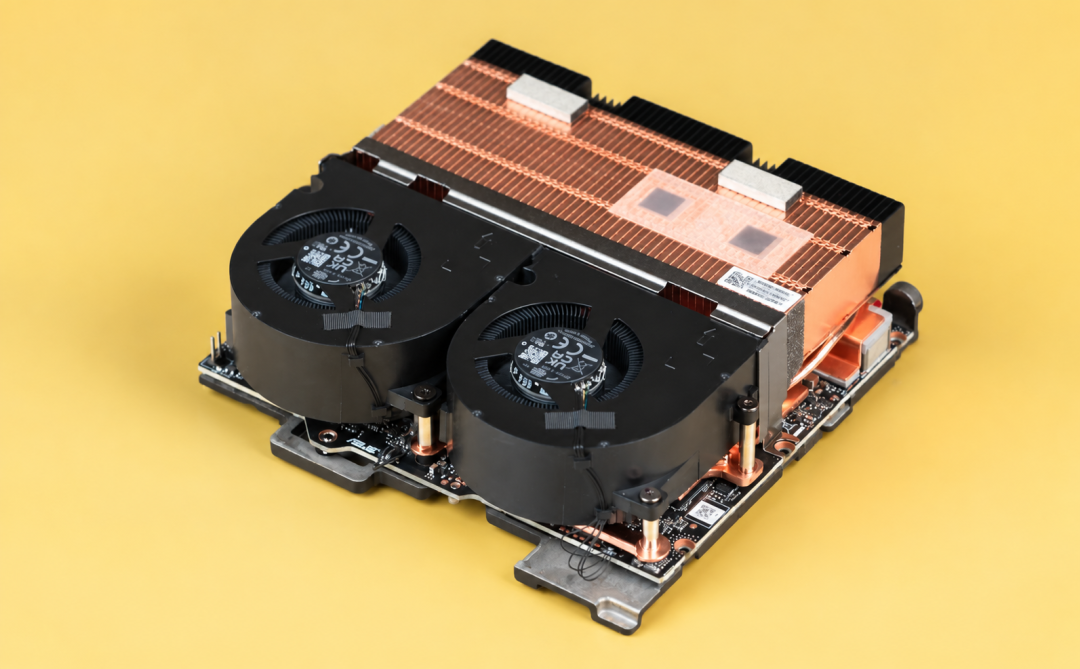
三位评测者(楠爷、Edison Chen、《微型计算机》)都独立拆测了华硕ProArt GR1X,并与此前测过的RTX Spark笔记本做同款负载对照,结论可以合并成一句话:桌面盒子多出来的功耗预算主要花在GPU和持续释放上,而不是CPU峰值。纯CPU满载时,桌面机的多线程CPU功耗仅从笔记本的73.6W小幅升到74.8W,频率提升也有限(P-Core单线程3690→3886MHz);真正拉开的是GPU——3DMark Speed Way压力测试中,笔记本GPU功耗维持在65~70W,GR1X能稳定跑到83W。连续20分钟满载,核心温度才70℃出头,距离83℃温度墙还有相当余量;CPU+GPU双烤时,GR1X按60W+80W分配刚好顶满140W标称,双端频率维持在接近单烤峰值的水平,不会出现轻薄本上"一边升功耗、另一边被迫降频"的跷跷板。知乎
强多少:按负载类型分档看
把各家的数字按负载类型排开,梯度非常清晰。
轻负载与短时任务:基本没有差距。 7-Zip、CPU-Z这类短时测试里两台机器成绩接近;ComfyUI跑MiniMax-H3生成5秒有声视频(fl2va工作流),桌面机耗时334.58秒,比笔记本只快了约4秒。算力密集但单次负载不长的任务,功耗墙几乎碰不到。知乎
重度多线程:约两成。 Cinebench 2026多线程从笔记本的5988分提升到7279分,约+21%;x265编码从4.32提到4.46 FPS。知乎
游戏:理论分+8%~15%,帧率提升随场景走。 《微型计算机》实测的GR1X三项3DMark ARM原生成绩,对比此前测试的RTX Spark笔记本全面领先,Speed Way约2945→3218、Port Royal约8689→10011、Steel Nomad约3010→3364。楠爷侧的Port Royal提升约8%,同样已接近桌面版RTX 5060 Ti水平。实际游戏中差距更依赖负载结构:《漫威争锋》ARM64EC原生版,1440p高画质+DLSS平衡档下平均帧率从80 FPS提升到88 FPS,1% Low从49 FPS涨到61 FPS。这背后是GPU功耗从约35W翻倍到64W换来的;《赛博朋克2077》这类游戏开多帧生成后差距进一步放大,因为帧生成能缓解x86转译带来的CPU瓶颈,让功耗预算更高的GPU充分出力。知乎知乎
本地大模型:单流小差、多流拉开。 同一套TensorFold+Qwen3.8 27B配置,GR1X单流解码64.8 token/s,与笔记本差距不大;但4流并发能到209 token/s,相当于笔记本的1.24倍。持续推理解锁了散热与功耗的稳定性优势。Artificial Analysis的AgentPerf-Local智能体回放(168轮真实任务)中,GR1X完整无中断跑完,输出能力67 token/s,这类整天在线的压力测试才是桌面形态的主场。知乎
一个容易被忽略的前提:软件栈的方差比形态更大
值得提醒的是,这批评测里最大的性能变量其实不是"盒子还是本子",而是推理引擎。楠爷在同一台GR1X上做对照:换用TensorFold跑Qwen3.8-Flash-Next,相比传统llama.cpp路径,平均解码吞吐提升116%、Prefill提升135%、首字延迟降低58%,单Token能耗反而下降44%。也就是说,如果只买硬件不做软件功课,你感受到的差距可能一半来自形态、一半来自自己配的环境。同时TensorFold的高吞吐主要体现在单用户场景,多用户并发仍不如vLLM——这也是DGX Spark(Linux系统、带ConnectX-7可多机并联、原生vLLM生态)与RTX Spark桌面主机的定位分界:前者是团队向的私有AI服务器,后者是个人向的Windows全能工作站。知乎
别只看性能差:7×24常驻才是桌面形态的主场
评测里最容易被标题忽略、但对用户最实际的一项数据是待机功耗:GR1X模型已加载、没有推理任务时整机功耗仅约15W,全年无休开机一天耗电约0.36度。智能体可以全天安静地在桌角待命。NVIDIA给这套组合算过一笔账:本地跑176B级开源模型Qwen3.8-Flash-Next(Artificial Analysis智能指数40,与云端Claude Sonnet 5.5 Medium仅差1分),每月本地产出6100万Token的电费约20美元,同等Token量走云端API大约1200美元。知乎知乎
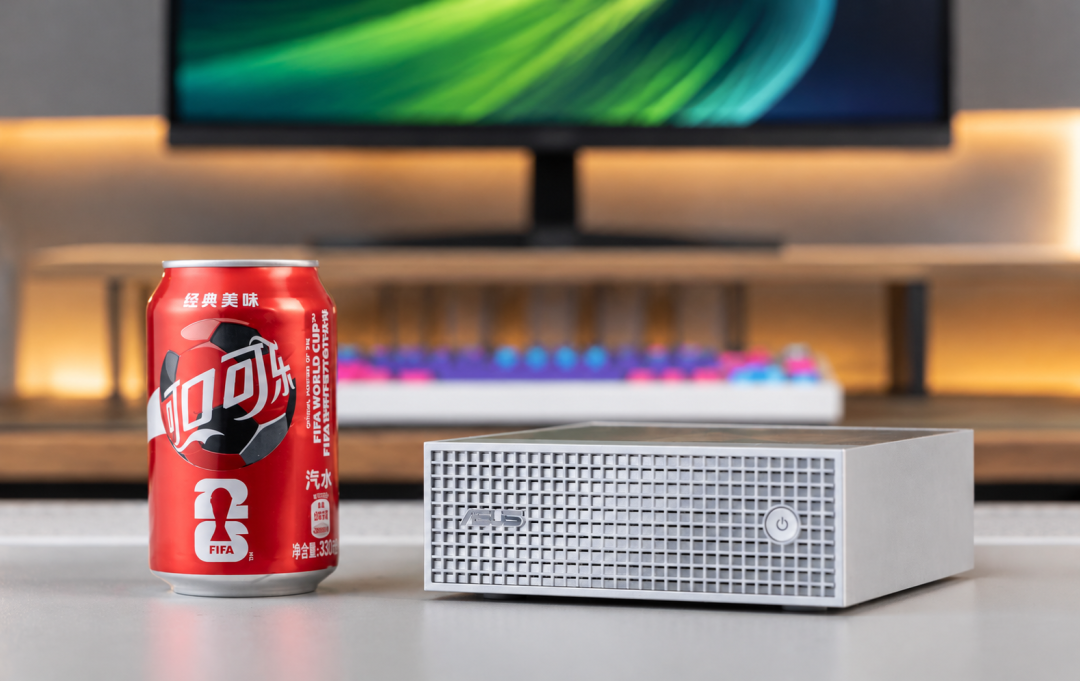
该不该买:先问用途,再比参数
价格方面,微星Edge Mesa NAI+日常价33999元、华硕ProArt GR1X 64GB+2TB版日常34999元、机械革命大师之路X10专业版32999元/旗舰版49999元。三台桌面主机与同芯片笔记本的硬件规格几乎一致,选购逻辑其实就三条:知乎知乎知乎
有移动需求——要带出门见客户、在工位和家之间跑——买笔记本,桌面机的性能差换不来便携性;
需要一台7×24在线的本地AI节点,跑智能体、定时任务、批量出图出视频——迷你主机是更好的选择,140W的持续释放和15W的驻留待机都是笔记本给不了的;
多用户并发或需要堆更大模型——考虑带ConnectX-7并联能力的DGX Spark路线,RTX Spark桌面机目前只适合单机部署。
还要注意两个门槛:Windows下WDDM驱动默认内存额度机制会拦大模型加载,跑70GB级权重需手动把虚拟内存设置为128GB。《三角洲行动》等带强反作弊的游戏暂时跑不了,部分x86应用仍需经Prism转译运行,实测平均损失约16%。性能差实测的结论因此可以更直白地说:同芯片桌面盒子不是"更快的笔记本",而是把同一颗芯片的持续输出和常驻能力解锁出来的另一种设备——为性能差付费的前提,是你真的有要它一直干着的活。知乎知乎
当前文章无评论,是时候发表评论了